Regresión lineal en R con lm()
La función lm se utiliza para ajustar modelos de regresión lineal en R. Estima cómo cambia una variable respuesta numérica en función de una o varias variables explicativas, y summary te devuelve los coeficientes, sus p-valores y el R cuadrado del modelo. En este tutorial aprenderás a ajustar una regresión lineal simple y una múltiple, a leer cada línea de la salida, a hacer predicciones con predict, a comprobar los supuestos del modelo y qué errores debes evitar.
Regresión lineal simple en R
Una regresión lineal simple modela una respuesta numérica \(y\) como una recta de una única variable explicativa \(x\):
\[y = \beta_0 + \beta_1 x + \varepsilon\]
donde \(\beta_0\) es el intercepto (el valor de \(y\) cuando \(x = 0\)), \(\beta_1\) es la pendiente (cuánto cambia \(y\) cuando \(x\) aumenta una unidad) y \(\varepsilon\) es el error aleatorio. lm estima \(\beta_0\) y \(\beta_1\) por mínimos cuadrados ordinarios, es decir, busca la recta que minimiza la suma de los cuadrados de las distancias verticales entre los puntos y la recta.
Para este ejemplo vamos a utilizar el conjunto de datos mtcars, que contiene 32 coches. Vamos a explicar el consumo en millas por galón (mpg) con el peso del coche en miles de libras (wt). Antes de ajustar nada, un gráfico de dispersión te dice si tiene sentido usar una recta:
# Ajuste del modelo
fit <- lm(mpg ~ wt, data = mtcars)

# Gráfico de dispersión y recta ajustada
plot(mpg ~ wt, data = mtcars, pch = 19, col = 4,
     xlab = "Peso (1000 libras)", ylab = "Millas por galón")
abline(fit, col = 2, lwd = 2)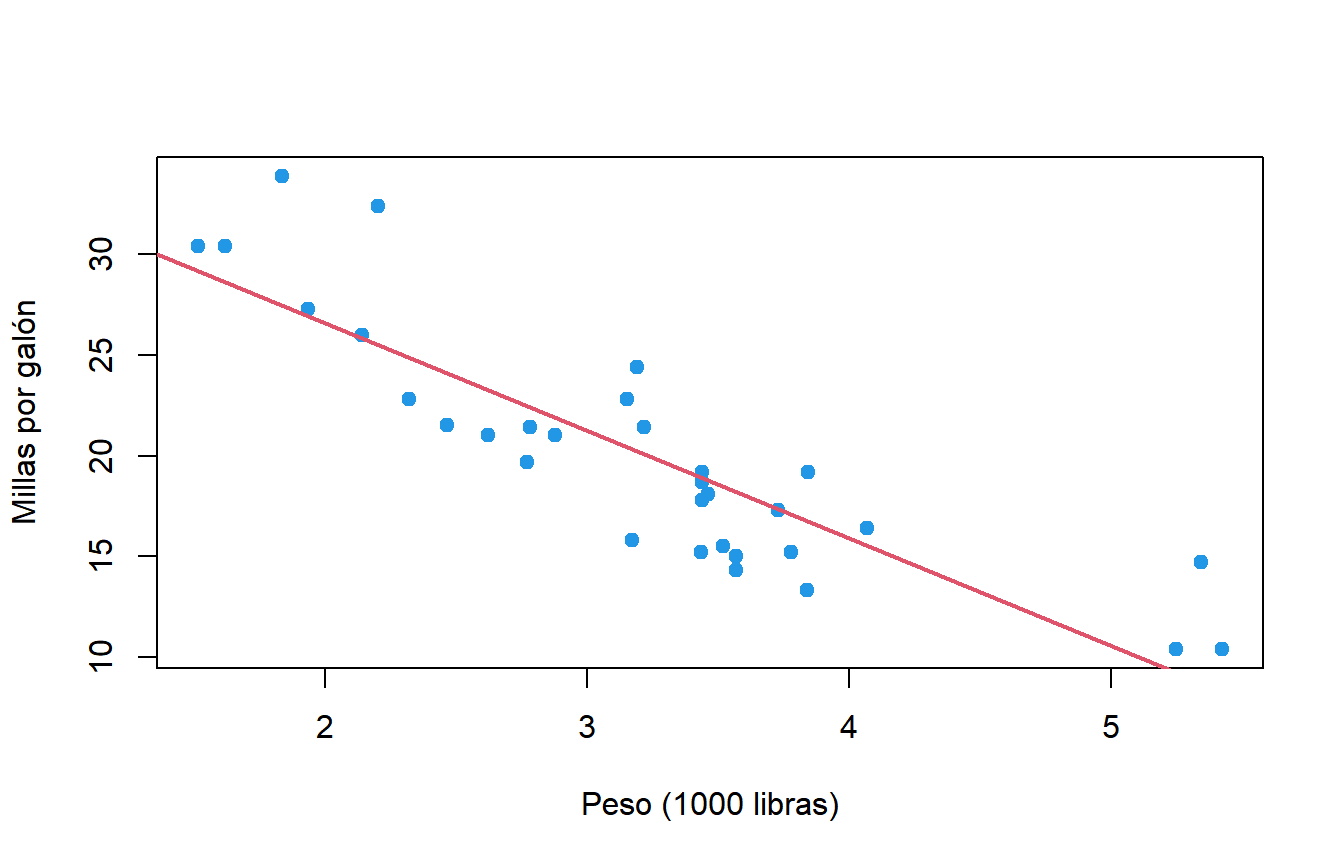
La relación es claramente negativa y aproximadamente lineal: los coches más pesados recorren menos millas por galón. La correlación entre ambas variables, que puedes calcular con cor como se explica en el tutorial de covarianza y correlación (o contrastar con cor.test), mide la fuerza de esta relación lineal, mientras que la regresión va un paso más allá y te da la ecuación de la recta.
La sintaxis de fórmula de lm es respuesta ~ explicativa, y el argumento data indica el data frame donde están las variables. Si imprimes el modelo solo verás los coeficientes estimados:
# Regresión lineal simple
fit <- lm(mpg ~ wt, data = mtcars)
fit
Call:
lm(formula = mpg ~ wt, data = mtcars)
Coefficients:
(Intercept) wt
37.285 -5.344Por tanto, la recta ajustada es \(\widehat{mpg} = 37.285 - 5.344 \cdot wt\). Para saber si estos coeficientes son significativos y cómo de bien se ajusta la recta a los datos necesitas summary.
Cómo interpretar la salida de summary(lm)
Pasa el modelo ajustado a summary para obtener la salida completa de la regresión:
summary(fit)Call:
lm(formula = mpg ~ wt, data = mtcars)
Residuals:
Min 1Q Median 3Q Max
-4.5432 -2.3647 -0.1252 1.4096 6.8727
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 37.2851 1.8776 19.858 < 2e-16 ***
wt -5.3445 0.5591 -9.559 1.29e-10 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 3.046 on 30 degrees of freedom
Multiple R-squared: 0.7528, Adjusted R-squared: 0.7446
F-statistic: 91.38 on 1 and 30 DF, p-value: 1.294e-10Vamos a verla bloque a bloque.
Residuos (Residuals)
Los residuos son las diferencias entre los valores observados y los valores que predice la recta, \(e_i = y_i - \hat{y}_i\). La salida muestra su resumen de cinco números. Si el modelo es razonable, la mediana debe estar cerca de 0 y el primer y tercer cuartil (y el mínimo y el máximo) deben ser más o menos simétricos. Aquí la mediana es -0.13 y el máximo (6.87) es algo mayor en valor absoluto que el mínimo (-4.54), así que hay algunos coches que consumen menos de lo que predice la recta. Esto es solo una primera pista: los supuestos se comprueban de verdad con los gráficos de diagnóstico que verás más abajo.
Coeficientes (Coefficients)
La tabla de coeficientes tiene una fila por parámetro y cuatro columnas:
- Estimate: el valor estimado del coeficiente. El intercepto es 37.285 y la pendiente de
wtes -5.345. - Std. Error: el error estándar de la estimación, es decir, cuánto variaría la estimación de una muestra a otra. Cuanto menor, más precisa.
- t value: la estimación dividida entre su error estándar, \(t = -5.3445 / 0.5591 = -9.559\). Es el estadístico con el que se contrasta \(H_0: \beta = 0\).
- Pr(>|t|): el p-valor de ese contraste, calculado a partir de una distribución t de Student con los grados de libertad residuales (\(n - 2 = 30\) en este caso). Un p-valor pequeño significa que la variable tiene un efecto lineal significativo sobre la respuesta.
El p-valor de wt (1.29e-10) es muy inferior a 0.05, así que el peso tiene un efecto significativo sobre el consumo. Dicho con palabras, la pendiente se interpreta así:
Por cada 1000 libras más de peso, el consumo esperado disminuye en 5.34 millas por galón de media.
Expresa siempre la pendiente en las unidades de tus variables: “una unidad más de \(x\)” aquí es “1000 libras más” porque wt está medido en miles de libras.
El intercepto sería el mpg esperado de un coche que pesa 0, lo cual no tiene sentido. Esto es muy habitual: el intercepto suele ser solo un punto de anclaje de la recta y no hace falta interpretarlo salvo que \(x = 0\) sea un valor con sentido en tus datos.
Error estándar residual
El error estándar residual (Residual standard error, 3.046) es la estimación de la desviación típica del término de error \(\varepsilon\). Está en las mismas unidades que la respuesta, así que puedes leerlo como la distancia típica entre los valores observados y la recta de regresión: las predicciones de este modelo suelen fallar en unas 3 millas por galón. Los 30 grados de libertad son el número de observaciones menos el número de coeficientes estimados (\(32 - 2\)).
R cuadrado y R cuadrado ajustado
El R cuadrado (Multiple R-squared, \(R^2\)) es la proporción de la variabilidad de la respuesta que explica el modelo. Aquí \(R^2 = 0.7528\), así que el peso explica en torno al 75% de la variabilidad de mpg. En una regresión lineal simple coincide exactamente con el cuadrado del coeficiente de correlación entre \(x\) e \(y\).
El problema del \(R^2\) es que nunca disminuye al añadir una variable, aunque esa variable sea puro ruido. El R cuadrado ajustado (Adjusted R-squared, 0.7446) penaliza el número de predictores:
\[R^2_{adj} = 1 - (1 - R^2) \frac{n - 1}{n - p - 1}\]
donde \(n\) es el número de observaciones y \(p\) el número de predictores. Utiliza el \(R^2\) ajustado cuando compares modelos con distinto número de variables.
No existe un valor “bueno” universal del R cuadrado. En física o ingeniería un \(R^2\) de 0.75 puede ser bajo, mientras que en ciencias sociales un 0.3 puede dar lugar a un modelo útil. Un \(R^2\) bajo con coeficientes significativos quiere decir que la variable tiene efecto, pero que hay mucha variabilidad que el modelo no explica.
Estadístico F
La última línea contrasta si el modelo en su conjunto explica algo, es decir, \(H_0\): todas las pendientes valen 0 (el modelo no es mejor que predecir la media de \(y\) para todas las observaciones). El estadístico sigue una distribución F con \(p\) y \(n - p - 1\) grados de libertad, 1 y 30 en este caso. El p-valor (1.294e-10) es minúsculo, así que el modelo es significativo.
Con un único predictor el contraste F equivale al contraste t de la pendiente: los p-valores coinciden y \(F = t^2\) (\(9.559^2 = 91.38\)). Con varios predictores el contraste F cobra sentido, porque los contrasta todos a la vez.
Extraer los resultados del modelo
A menudo necesitarás los números del modelo, no la salida impresa. Estas son las funciones más útiles:
| Función | Devuelve |
|---|---|
coef(fit) |
Coeficientes estimados |
confint(fit) |
Intervalos de confianza de los coeficientes |
fitted(fit) |
Valores ajustados (predichos) para las observaciones |
residuals(fit) |
Residuos de cada observación |
summary(fit)$r.squared |
\(R^2\) ($adj.r.squared para el ajustado) |
summary(fit)$coefficients |
La tabla de coeficientes completa como matriz |
coef(fit)(Intercept) wt
37.285126 -5.344472Los intervalos de confianza suelen ser más informativos que los p-valores, porque te dan el rango de valores plausibles del efecto. Por defecto son intervalos al 95%; puedes cambiarlo con el argumento level:
confint(fit) 2.5 % 97.5 %
(Intercept) 33.450500 41.119753
wt -6.486308 -4.202635Con un 95% de confianza, cada 1000 libras más de peso reducen el consumo entre 4.2 y 6.5 millas por galón. El intervalo no contiene el 0, lo que concuerda con el p-valor significativo.
Los valores ajustados y los residuos son vectores con nombres, con un elemento por observación:
head(fitted(fit))
head(residuals(fit))
Mazda RX4 Mazda RX4 Wag Datsun 710 Hornet 4 Drive
23.28261 21.91977 24.88595 20.10265
Hornet Sportabout Valiant
18.90014 18.79325
Mazda RX4 Mazda RX4 Wag Datsun 710 Hornet 4 Drive
-2.2826106 -0.9197704 -2.0859521 1.2973499
Hornet Sportabout Valiant
-0.2001440 -0.6932545Por último, summary devuelve una lista, así que puedes extraer cualquier elemento de la salida con $:
summary(fit)$r.squared
summary(fit)$adj.r.squared
summary(fit)$sigma # Error estándar residual
[1] 0.7528328
[1] 0.7445939
[1] 3.045882Regresión lineal múltiple
Una regresión lineal múltiple incluye varias variables explicativas, que se añaden a la fórmula con +. En el siguiente ejemplo explicamos mpg con el peso y la potencia en caballos (hp) del coche:
# Regresión lineal múltiple
fit2 <- lm(mpg ~ wt + hp, data = mtcars)
summary(fit2)
Call:
lm(formula = mpg ~ wt + hp, data = mtcars)
Residuals:
Min 1Q Median 3Q Max
-3.941 -1.600 -0.182 1.050 5.854
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 37.22727 1.59879 23.285 < 2e-16 ***
wt -3.87783 0.63273 -6.129 1.12e-06 ***
hp -0.03177 0.00903 -3.519 0.00145 **
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 2.593 on 29 degrees of freedom
Multiple R-squared: 0.8268, Adjusted R-squared: 0.8148
F-statistic: 69.21 on 2 and 29 DF, p-value: 9.109e-12En una regresión múltiple cada coeficiente es el efecto de su variable manteniendo constantes las demás:
wt: entre dos coches con la misma potencia, 1000 libras más de peso reducen el consumo en 3.88 millas por galón de media.hp: entre dos coches con el mismo peso, cada caballo adicional lo reduce en 0.032 millas por galón, es decir, unas 3.2 mpg por cada 100 caballos.
Fíjate en que el efecto de wt ha pasado de -5.34 a -3.88. Los coches más pesados también suelen ser más potentes, así que en el modelo simple parte del efecto de la potencia se atribuía al peso. Ambas variables son significativas y el \(R^2\) ajustado ha subido de 0.7446 a 0.8148, así que añadir hp mejora el modelo.
Variables categóricas y nivel de referencia
También puedes incluir variables categóricas. Por ejemplo, el número de cilindros (cyl) toma los valores 4, 6 y 8. Como está guardado como número, tienes que convertirlo a factor para que lm lo trate como grupos:
fit3 <- lm(mpg ~ wt + factor(cyl), data = mtcars)
summary(fit3)
Call:
lm(formula = mpg ~ wt + factor(cyl), data = mtcars)
Residuals:
Min 1Q Median 3Q Max
-4.5890 -1.2357 -0.5159 1.3845 5.7915
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 33.9908 1.8878 18.006 < 2e-16 ***
wt -3.2056 0.7539 -4.252 0.000213 ***
factor(cyl)6 -4.2556 1.3861 -3.070 0.004718 **
factor(cyl)8 -6.0709 1.6523 -3.674 0.000999 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 2.557 on 28 degrees of freedom
Multiple R-squared: 0.8374, Adjusted R-squared: 0.82
F-statistic: 48.08 on 3 and 28 DF, p-value: 3.594e-11Un factor con \(k\) niveles se convierte en \(k - 1\) coeficientes. El primer nivel (4 cilindros) es el nivel de referencia y no aparece en la tabla: los coeficientes de los otros niveles son diferencias respecto a él. Para un mismo peso, un coche de 6 cilindros recorre 4.26 mpg menos que uno de 4 cilindros, y uno de 8 cilindros 6.07 mpg menos.
Si prefieres otro nivel de referencia, cámbialo con relevel. Por ejemplo, mtcars$cyl <- relevel(factor(mtcars$cyl), ref = "8") convierte los coches de 8 cilindros en la referencia, y los coeficientes pasan a ser las diferencias respecto a ellos.
Interacciones
El modelo anterior supone que el efecto del peso es el mismo para todos los coches. Si crees que depende de otra variable, añade una interacción con *. La fórmula wt * am es un atajo de wt + am + wt:am, donde am vale 0 para cambio automático y 1 para cambio manual:
fit4 <- lm(mpg ~ wt * am, data = mtcars)
summary(fit4)$coefficients
Estimate Std. Error t value Pr(>|t|)
(Intercept) 31.416055 3.0201093 10.402291 4.001043e-11
wt -3.785908 0.7856478 -4.818836 4.551182e-05
am 14.878423 4.2640422 3.489277 1.621034e-03
wt:am -5.298360 1.4446993 -3.667449 1.017148e-03Ahora el coeficiente wt es la pendiente para los coches automáticos (-3.79 mpg por cada 1000 libras) y wt:am es cuánto cambia la pendiente en los coches manuales: \(-3.79 - 5.30 = -9.08\) mpg por cada 1000 libras. La interacción es significativa, así que el peso penaliza mucho más el consumo en los coches manuales. Cuando hay interacción, no interpretes los efectos principales por separado.
Predicciones con predict
Para predecir la respuesta en nuevas observaciones utiliza predict con el argumento newdata. Debe ser un data frame con los mismos nombres de variables que usaste en la fórmula:
nuevos_coches <- data.frame(wt = c(2.5, 3.5))

predict(fit, newdata = nuevos_coches)
1 2
23.92395 18.57948Para un coche de 2500 libras se espera un consumo de 23.9 millas por galón. Con el argumento interval también puedes obtener un intervalo alrededor de cada predicción, y hay dos tipos muy distintos:
predict(fit, newdata = nuevos_coches, interval = "confidence")
predict(fit, newdata = nuevos_coches, interval = "prediction")
fit lwr upr
1 23.92395 22.55284 25.29506
2 18.57948 17.43342 19.72553
fit lwr upr
1 23.92395 17.55411 30.29378
2 18.57948 12.25426 24.90469| Intervalo | Pregunta que responde | Anchura |
|---|---|---|
"confidence" |
¿Dónde está el mpg medio de todos los coches de 2500 libras? |
Estrecho |
"prediction" |
¿Dónde caerá el mpg de un coche nuevo de 2500 libras? |
Ancho |
El intervalo de confianza solo recoge la incertidumbre de la recta estimada, mientras que el intervalo de predicción incluye además la variabilidad de cada coche alrededor de la recta (el error estándar residual). Por eso el intervalo de predicción (de 17.6 a 30.3) es mucho más ancho que el de confianza (de 22.6 a 25.3). Si quieres predecir un único valor nuevo, el intervalo de predicción es el adecuado.
Evita predecir fuera del rango de los datos con los que ajustaste el modelo (extrapolación). Los pesos de mtcars van de unas 1500 a 5400 libras: nada garantiza que la relación siga siendo lineal para un coche de 8000 libras, y el modelo podría incluso predecir consumos negativos.
Supuestos y diagnóstico del modelo
Los p-valores y los intervalos de lm solo son fiables si se cumplen los siguientes supuestos:
- Linealidad: la relación entre los predictores y la media de la respuesta es lineal.
- Independencia: los errores son independientes entre sí (por ejemplo, no hay medidas repetidas del mismo sujeto ni correlación temporal). Depende de cómo se recogieron los datos.
- Homocedasticidad: la varianza de los errores es constante para todos los valores ajustados.
- Normalidad: los errores siguen una distribución normal. Es el supuesto menos importante con muestras grandes.
Todos se comprueban sobre los residuos. La forma más rápida es llamar a plot sobre el modelo, que crea cuatro gráficos de diagnóstico. Utiliza par(mfrow = c(2, 2)) para verlos juntos:
fit2 <- lm(mpg ~ wt + hp, data = mtcars)

par(mfrow = c(2, 2))
plot(fit2, pch = 19, col = 4)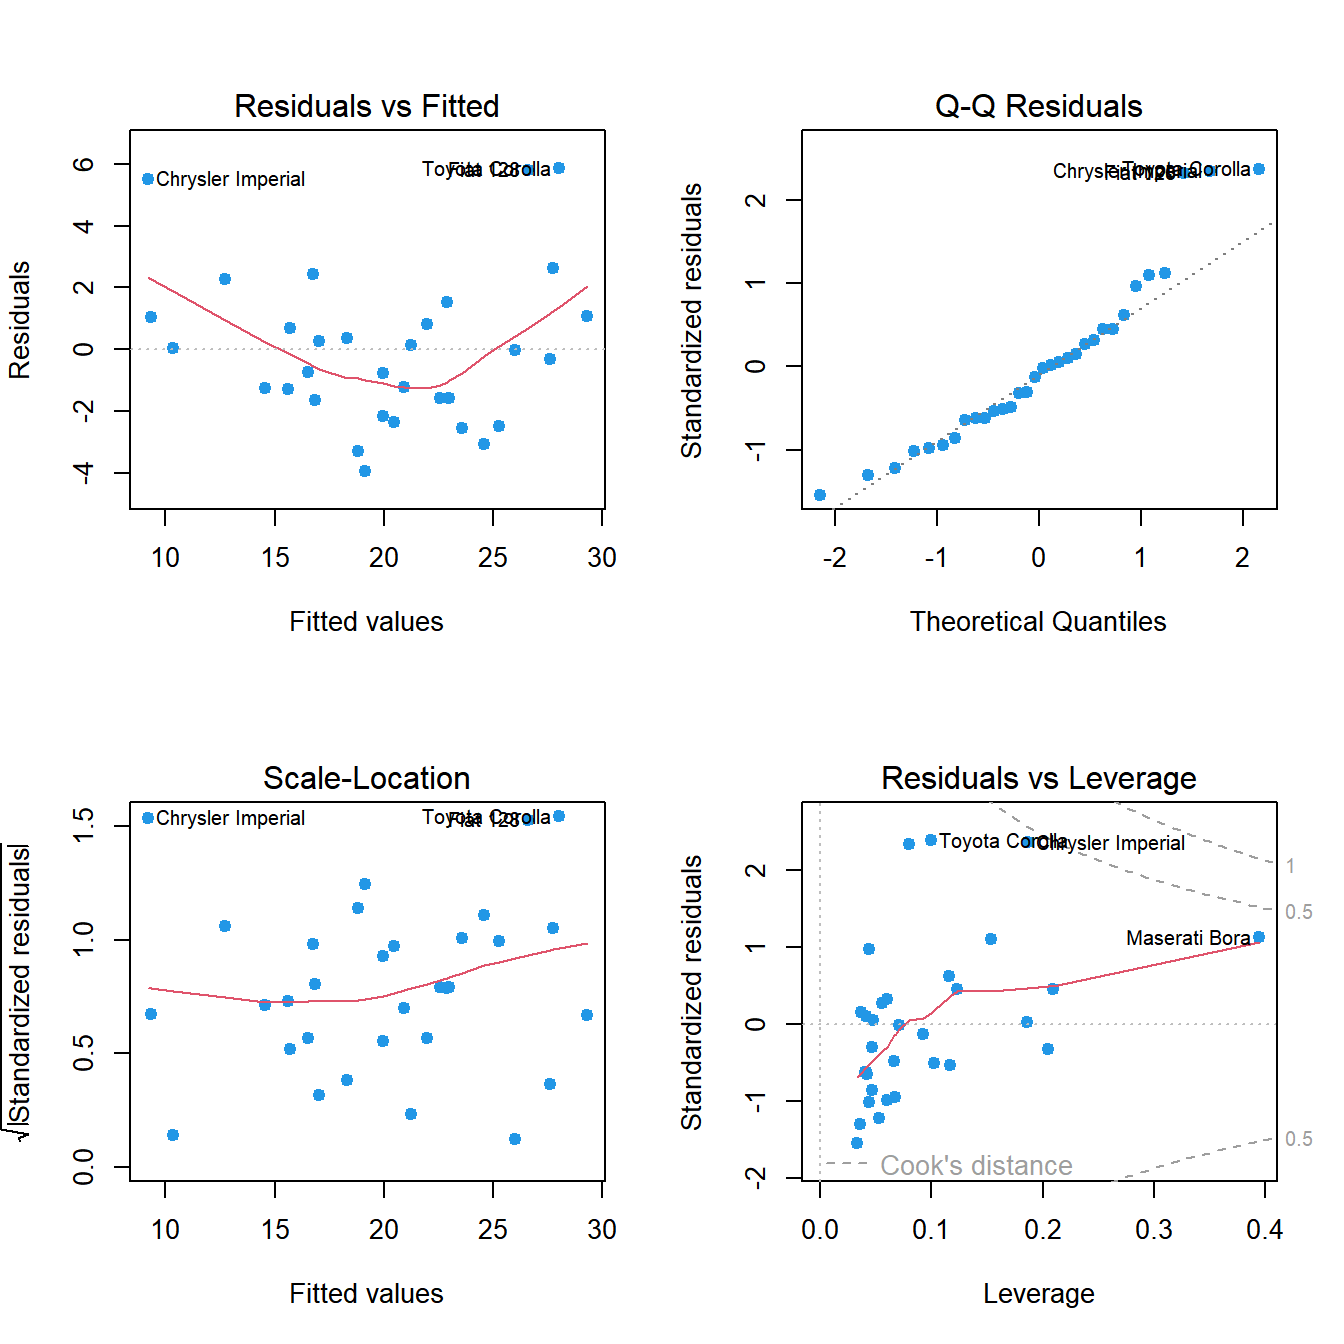
par(mfrow = c(1, 1))Así se lee cada panel:
- Residuals vs Fitted (arriba a la izquierda): comprueba la linealidad. Los puntos deben estar repartidos al azar alrededor del 0 y la línea roja debe ser plana. Aquí la línea roja tiene una clara forma de U: el modelo sobrestima el consumo de los coches del centro y lo infraestima en los extremos, señal de que la relación es curva.
- Q-Q Residuals (arriba a la derecha): comprueba la normalidad. Los puntos deben estar sobre la línea discontinua. La mayoría lo están, pero la cola superior se separa de ella.
- Scale-Location (abajo a la izquierda): comprueba la homocedasticidad. La línea roja debe ser aproximadamente horizontal y la dispersión de los puntos constante. Aquí sube ligeramente, pero nada grave.
- Residuals vs Leverage (abajo a la derecha): detecta observaciones influyentes. Los puntos más allá de las líneas discontinuas de la distancia de Cook (0.5 y 1) influyen mucho en los coeficientes. Chrysler Imperial y Maserati Bora son los coches más influyentes, pero ninguno cruza la línea de 1.
Los puntos etiquetados (Toyota Corolla, Fiat 128 y Chrysler Imperial) son las observaciones con los residuos más grandes. Merece la pena revisarlas, pero no elimines observaciones solo porque aparezcan etiquetadas.
Para comprobar la normalidad de manera formal, aplica el test de Shapiro-Wilk a los residuos:
shapiro.test(residuals(fit2)) Shapiro-Wilk normality test
data: residuals(fit2)
W = 0.92792, p-value = 0.03427El p-valor (0.034) es inferior a 0.05, así que hay cierta evidencia en contra de la normalidad, lo que concuerda con el gráfico Q-Q y con la curvatura del primer panel.
Qué hacer si no se cumplen los supuestos
La solución depende del problema:
- Curvatura: transforma la respuesta o los predictores (
log(y),log(x)) o añade un término cuadrático conI(x^2). - Varianza no constante o residuos asimétricos: una transformación de la respuesta, como el logaritmo o una transformación de Box-Cox, suele resolver ambos problemas. Otra opción es mantener el modelo y utilizar errores estándar robustos.
- Observaciones no independientes: necesitas otro tipo de modelo (modelos mixtos o modelos de series temporales).
Para este modelo, MASS::boxcox(fit2) sugiere un \(\lambda\) cercano a 0, que corresponde al logaritmo. Ajustar el modelo con log(mpg) elimina buena parte del problema:
fit_log <- lm(log(mpg) ~ wt + hp, data = mtcars)

coef(fit_log)
shapiro.test(residuals(fit_log))
(Intercept) wt hp
3.829102987 -0.200536801 -0.001543496
Shapiro-Wilk normality test
data: residuals(fit_log)
W = 0.95973, p-value = 0.2701Ahora los residuos son compatibles con la normalidad (p-valor = 0.27). Ten en cuenta que la interpretación cambia: con una respuesta en logaritmos, los coeficientes son aproximadamente cambios relativos. Como \(e^{-0.2005} = 0.818\), cada 1000 libras más de peso reducen las millas por galón en torno a un 18%, manteniendo constante la potencia. Además, el \(R^2\) de modelos con respuestas distintas (\(mpg\) y \(\log(mpg)\)) no se puede comparar directamente.
Comparar modelos anidados con anova
Para decidir si añadir variables mejora un modelo de forma significativa, ajusta ambos modelos y pásalos a anova. Los modelos deben estar anidados (el pequeño contiene un subconjunto de las variables del grande) y ajustados sobre las mismas observaciones:
anova(fit, fit2)Analysis of Variance Table
Model 1: mpg ~ wt
Model 2: mpg ~ wt + hp
Res.Df RSS Df Sum of Sq F Pr(>F)
1 30 278.32
2 29 195.05 1 83.274 12.381 0.001451 **
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1RSS es la suma de cuadrados residual de cada modelo. Añadir hp la reduce de 278.32 a 195.05, y el contraste F indica que esta reducción es significativa (p-valor = 0.0015), así que el modelo con ambas variables es mejor. Cuando añades una única variable, este p-valor coincide con el de su contraste t en summary(fit2). La comparación es más útil cuando añades varias variables o un factor de una vez.
lm vs aov vs glm
lm es la función general para modelos lineales, pero hay funciones relacionadas para casos concretos:
| Función | Cuándo usarla |
|---|---|
lm |
La respuesta es numérica y quieres los coeficientes, el \(R^2\) y predicciones |
aov |
Los predictores son factores y el objetivo es comparar medias de grupos (ANOVA) |
glm |
La respuesta es binaria, un conteo, etc. Para una respuesta sí/no utiliza una regresión logística |
Un ANOVA es en realidad un modelo lineal con predictores categóricos: aov llama internamente a lm, y anova(lm(y ~ grupo)) da la misma tabla que summary(aov(y ~ grupo)).
Errores comunes con lm
Usar data$ dentro de la fórmula
Es muy habitual escribir la fórmula como lm(mtcars$mpg ~ mtcars$wt). El modelo se ajusta bien, pero ahora las variables se llaman mtcars$wt, así que predict no las encuentra en newdata y devuelve sin más los 32 valores ajustados en lugar de tus predicciones, con solo un aviso:
mal_ajuste <- lm(mtcars$mpg ~ mtcars$wt)
predict(mal_ajuste, newdata = data.frame(wt = c(2.5, 3.5)))
Warning message:
'newdata' had 2 rows but variables found have 32 rowsUtiliza siempre los nombres de las columnas en la fórmula y el data frame en el argumento data: lm(mpg ~ wt, data = mtcars).
Olvidar el argumento data
Si usas los nombres de las columnas pero olvidas data, R busca las variables en el entorno global y no las encuentra:
lm(mpg ~ wt)Error in eval(predvars, data, env) : object 'mpg' not foundSi trabajas con pipes, recuerda que los datos van en el segundo argumento, así que necesitas un marcador de posición, como se explica en el tutorial del operador pipe: mtcars |> lm(mpg ~ wt, data = _).
Factores codificados como números
Si una variable categórica está codificada con números, lm la trata como numérica y ajusta una única pendiente. lm(mpg ~ wt + cyl, data = mtcars) devuelve un único coeficiente para cyl (-1.51), lo que supone que pasar de 4 a 6 cilindros tiene exactamente el mismo efecto que pasar de 6 a 8. Utiliza factor(cyl) como viste antes y comprueba que el número de coeficientes es el número de niveles menos uno.
Valores faltantes
Por defecto lm elimina las filas con valores faltantes en cualquiera de las variables del modelo (na.action = na.omit). summary te avisa, pero es fácil pasarlo por alto:
fit_aq <- lm(Ozone ~ Temp, data = airquality)
summary(fit_aq)
Call:
lm(formula = Ozone ~ Temp, data = airquality)
Residuals:
Min 1Q Median 3Q Max
-40.729 -17.409 -0.587 11.306 118.271
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) -146.9955 18.2872 -8.038 9.37e-13 ***
Temp 2.4287 0.2331 10.418 < 2e-16 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 23.71 on 114 degrees of freedom
(37 observations deleted due to missingness)
Multiple R-squared: 0.4877, Adjusted R-squared: 0.4832
F-statistic: 108.5 on 1 and 114 DF, p-value: < 2.2e-16El modelo se ha ajustado con 116 de las 153 filas, así que el vector de residuos solo tiene 116 elementos y no puedes añadirlo como nueva columna del data frame:
df <- airquality
df$res <- residuals(fit_aq)
Error in `$<-.data.frame`(`*tmp*`, res, value = c(`1` = 25.2723695469062, :
replacement has 116 rows, data has 153La solución es ajustar el modelo con na.action = na.exclude. El modelo es el mismo, pero residuals y fitted se rellenan con NA en las posiciones de las filas eliminadas:
fit_aq <- lm(Ozone ~ Temp, data = airquality, na.action = na.exclude)

df$res <- residuals(fit_aq)
head(df)
Ozone Solar.R Wind Temp Month Day res
1 41 190 7.4 67 5 1 25.272370
2 36 118 8.0 72 5 2 8.128853
3 12 149 12.6 74 5 3 -20.728554
4 18 313 11.5 62 5 4 14.415886
5 NA NA 14.3 56 5 5 NA
6 28 NA 14.9 66 5 6 14.701073Ten cuidado también al comparar modelos con anova: si las variables del modelo grande tienen más valores faltantes, ambos modelos se ajustan con filas distintas y anova se detiene con el error “models were not all fitted to the same size of dataset”. Elimina antes las filas con valores faltantes en todas las variables de los modelos, como se explica en el tutorial sobre valores NA en R.


