Valores NA en R: detectar, contar, eliminar y reemplazar
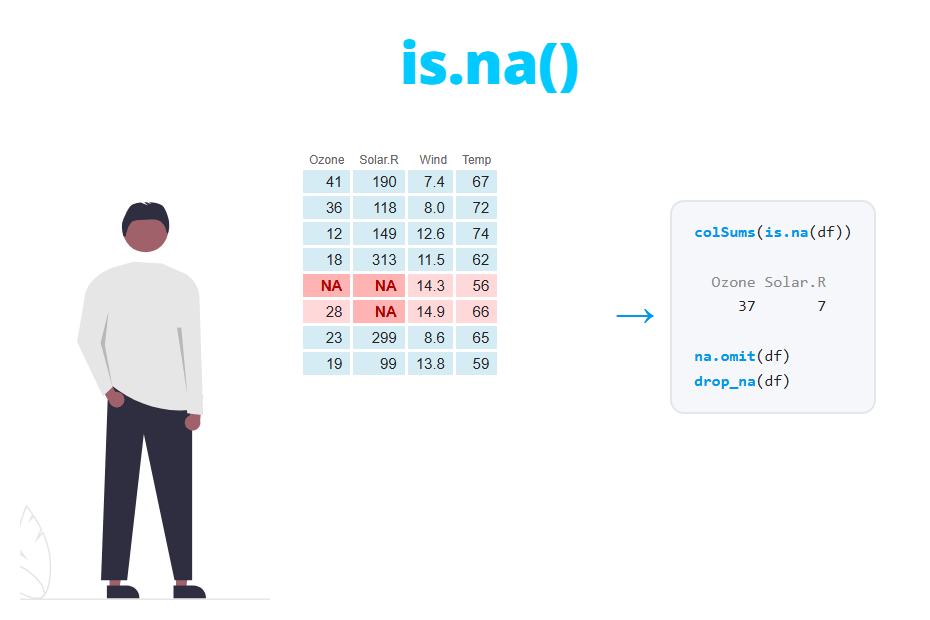
En R, los valores faltantes o perdidos se representan con NA (Not Available). En este tutorial aprenderás a detectar valores NA con is.na, a contarlos por columna y por fila, por qué funciones como mean devuelven NA y cómo solucionarlo con na.rm = TRUE, a eliminar filas con NA usando na.omit, complete.cases o drop_na y a reemplazar los NA por 0, la media o la mediana, tanto en R base como con dplyr y tidyr.
¿Qué es NA en R?
NA es un valor especial que indica que el dato existe pero se desconoce. Por ejemplo, un sensor que falló un día o una pregunta que alguien dejó en blanco en una encuesta. Es importante no confundirlo con otros valores parecidos:
NA: valor faltante. Puede aparecer en cualquier tipo de vector (numérico, de texto, lógico…).NaN: Not a Number, el resultado de una operación matemática indefinida, como0/0.NULL: la ausencia de objeto. Tiene longitud 0, por lo que no ocupa ninguna posición dentro de un vector."NA": una cadena de texto con las letras N y A. Para R no es un valor faltante.
0/0
is.na(NaN)   # NaN también se considera NA
is.nan(NA)   # pero NA no es NaN

length(NULL)
length(NA)
c(1, NULL, 3) # NULL desaparece

y <- c("a", "NA", NA)
is.na(y)      # solo el NA real es TRUE
[1] NaN
[1] TRUE
[1] FALSE
[1] 0
[1] 1
[1] 1 3
[1] FALSE FALSE TRUEEl último ejemplo es muy habitual al importar datos: el texto "NA" dentro de una columna de caracteres no se detecta como faltante. Verás cómo resolverlo al leer un CSV.
Por qué x == NA no funciona
El error más común al buscar valores faltantes es compararlos con ==. Como NA es un valor desconocido, cualquier comparación con NA devuelve NA, ya que R no puede saber si un valor desconocido es igual a 5 o no.
x <- c(5, NA, 3, NA, 8)

# Incorrecto
x == NA

# Correcto
is.na(x)
[1] NA NA NA NA NA
[1] FALSE TRUE FALSE TRUE FALSELo mismo ocurre al filtrar: x[x > 4] devuelve 5 NA NA 8, porque en las posiciones con NA la condición también es NA. Usa x[which(x > 4)] o elimina antes los valores faltantes si solo quieres los valores que cumplen la condición.
Detectar valores NA
En el resto del tutorial utilizaremos el conjunto de datos airquality, que contiene mediciones diarias de la calidad del aire en Nueva York entre mayo y septiembre de 1973. Tiene 153 filas y valores faltantes en dos de sus columnas: Ozone (ozono) y Solar.R (radiación solar).
head(airquality) Ozone Solar.R Wind Temp Month Day
1 41 190 7.4 67 5 1
2 36 118 8.0 72 5 2
3 12 149 12.6 74 5 3
4 18 313 11.5 62 5 4
5 NA NA 14.3 56 5 5
6 28 NA 14.9 66 5 6La función is.na devuelve TRUE para cada elemento faltante y FALSE en caso contrario. Si solo quieres saber si hay algún NA en todo el objeto, anyNA es más rápida y directa:
anyNA(airquality)

# Posiciones de los NA de una columna
which(is.na(airquality$Ozone))
[1] TRUE
[1] 5 10 25 26 27 32 33 34 35 36 37 39 42 43 45 46 52 53 54
[20] 55 56 57 58 59 60 61 65 72 75 83 84 102 103 107 115 119 150Ten en cuenta que la función summary también indica el número de valores faltantes de cada columna numérica en el campo NA's:
summary(airquality$Ozone) Min. 1st Qu. Median Mean 3rd Qu. Max. NA's
1.00 18.00 31.50 42.13 63.25 168.00 37Contar valores NA
Como TRUE cuenta como 1 y FALSE como 0, puedes contar los valores faltantes sumando la salida de is.na. El número total de NA del data frame es:
sum(is.na(airquality))[1] 44Contar NA por columna
Al aplicarla sobre un data frame, is.na devuelve una matriz lógica, por lo que puedes usar colSums para obtener el número de NA de cada columna y colMeans para obtener la proporción:
# Número de NA por columna
colSums(is.na(airquality))

# Porcentaje de NA por columna
round(colMeans(is.na(airquality)) * 100, 1)
Ozone Solar.R Wind Temp Month Day
37 7 0 0 0 0
Ozone Solar.R Wind Temp Month Day
24.2 4.6 0.0 0.0 0.0 0.0La salida indica que falta el 24.2% de los valores de ozono, mientras que Solar.R solo tiene 7 valores faltantes (4.6%). Esta diferencia es clave para decidir qué hacer: eliminar todas las filas con NA en Ozone supone perder casi una cuarta parte de los datos.
Contar NA por fila
Del mismo modo, rowSums devuelve cuántos valores faltantes tiene cada fila. Combinándola con table obtienes un resumen de las filas:
na_fila <- rowSums(is.na(airquality))

table(na_fila)
na_fila
0 1 2
111 40 2Hay 111 filas completas, 40 filas con un valor faltante y 2 filas con valores faltantes tanto en Ozone como en Solar.R.
Si necesitas contar los valores faltantes por grupo (por ejemplo, por mes) puedes usar group_by y summarise:
library(dplyr)

airquality %>%
  group_by(Month) %>%
  summarise(n_na = sum(is.na(Ozone)),
            media_ozono = mean(Ozone, na.rm = TRUE))
# A tibble: 5 × 3
Month n_na media_ozono
<int> <int> <dbl>
1 5 5 23.6
2 6 21 29.4
3 7 5 59.1
4 8 5 60.0
5 9 1 31.4Junio concentra 21 de los 37 valores de ozono faltantes, así que los datos faltantes no están repartidos de manera uniforme en el tiempo.
Cálculos con NA: el argumento na.rm
Si un vector contiene al menos un NA, la mayoría de funciones de resumen como mean, sum, median, max o sd devuelven NA. No es un fallo: si un valor es desconocido, la media de todos los valores también lo es.
Para calcular el resultado ignorando los valores faltantes tendrás que indicar na.rm = TRUE (NA remove):
mean(airquality$Ozone)
mean(airquality$Ozone, na.rm = TRUE)
median(airquality$Ozone, na.rm = TRUE)
sum(airquality$Solar.R, na.rm = TRUE)
[1] NA
[1] 42.12931
[1] 31.5
[1] 27146No todas las funciones usan na.rm. Por ejemplo, cor usa el argumento use y por defecto devuelve NA si hay valores faltantes:
cor(airquality$Ozone, airquality$Temp)
cor(airquality$Ozone, airquality$Temp, use = "complete.obs")
[1] NA
[1] 0.6983603Cuidado cuando todos los valores son faltantes: mean(c(NA, NA), na.rm = TRUE) devuelve NaN y sum(c(NA, NA), na.rm = TRUE) devuelve 0. Al trabajar por grupos, un grupo con solo NA puede producir estos valores sin ningún mensaje de error.
Eliminar valores NA
Eliminar NA de un vector
La forma más sencilla de eliminar los valores faltantes de un vector es quedarte con los elementos que no son NA, negando is.na con !:
x <- c(5, NA, 3, NA, 8)

x[!is.na(x)]
[1] 5 3 8También puedes usar na.omit, pero ten en cuenta que añade un atributo con las posiciones de los valores eliminados. Si quieres un vector limpio, envuélvelo con as.vector:
na.omit(x)

as.vector(na.omit(x))
[1] 5 3 8
attr(,"na.action")
[1] 2 4
attr(,"class")
[1] "omit"
[1] 5 3 8Eliminar filas con NA en cualquier columna
na.omit aplicada a un data frame elimina todas las filas que contienen al menos un NA, en cualquier columna. complete.cases devuelve TRUE para las filas sin valores faltantes, por lo que puedes usarla para filtrar y obtener el mismo resultado:
aq <- na.omit(airquality)
dim(aq)

aq2 <- airquality[complete.cases(airquality), ]
nrow(aq2)

# Número de filas incompletas
sum(!complete.cases(airquality))
[1] 111 6
[1] 111
[1] 42El nuevo data frame tiene 111 filas: has perdido 42 de las 153 observaciones (un 27%). Fíjate en que se conservan los nombres de fila originales (faltan la 5 y la 6 en la salida de abajo). Si quieres volver a numerarlas usa rownames(aq) <- NULL.
head(aq) Ozone Solar.R Wind Temp Month Day
1 41 190 7.4 67 5 1
2 36 118 8.0 72 5 2
3 12 149 12.6 74 5 3
4 18 313 11.5 62 5 4
7 23 299 8.6 65 5 7
8 19 99 13.8 59 5 8Eliminar filas con NA en columnas concretas
A menudo solo te interesan los valores faltantes de las columnas que vas a analizar. Si estás estudiando el ozono, no tiene sentido eliminar una fila porque le falte Solar.R. En R base, filtra por la columna:
aq_ozono <- airquality[!is.na(airquality$Ozone), ]
nrow(aq_ozono)
[1] 116La función drop_na de tidyr hace lo mismo de forma más legible. Sin argumentos revisa todas las columnas (como na.omit) y si le pasas uno o varios nombres de columna solo revisa esas:
library(tidyr)

nrow(drop_na(airquality))                  # todas las columnas
nrow(drop_na(airquality, Ozone))           # solo Ozone
nrow(drop_na(airquality, Ozone, Solar.R))  # Ozone y Solar.R
[1] 111
[1] 116
[1] 111Quedándote solo con las filas con un valor válido de Ozone conservas 116 filas en lugar de 111. También puedes usar filter con !is.na(Ozone), que es equivalente.
Reemplazar valores NA
En lugar de eliminar las filas, puedes reemplazar los valores faltantes. Para los ejemplos usaremos las seis primeras filas de airquality, que contienen tres NA:
df <- head(airquality, 6)Reemplazar NA por 0
En R base puedes asignar un valor a todas las posiciones en las que is.na es TRUE. Esto funciona tanto con vectores como con data frames completos:
df0 <- df
df0[is.na(df0)] <- 0

df0
Ozone Solar.R Wind Temp Month Day
1 41 190 7.4 67 5 1
2 36 118 8.0 72 5 2
3 12 149 12.6 74 5 3
4 18 313 11.5 62 5 4
5 0 0 14.3 56 5 5
6 28 0 14.9 66 5 6Para un vector, ifelse es otra opción: ifelse(is.na(x), 0, x) devuelve 5 0 3 0 8.
Reemplaza NA por 0 solo cuando el valor faltante signifique realmente cero (por ejemplo, ninguna venta en un día sin registros). En airquality un NA significa que no se tomó la medida, no que el ozono fuera 0, por lo que este reemplazo sesgaría la media a la baja.
Reemplazar NA por la media o la mediana
Para imputar una sola columna, calcula el estadístico con na.rm = TRUE y asígnalo a las posiciones faltantes:
df1 <- df
df1$Ozone[is.na(df1$Ozone)] <- mean(df1$Ozone, na.rm = TRUE)

df1
Ozone Solar.R Wind Temp Month Day
1 41 190 7.4 67 5 1
2 36 118 8.0 72 5 2
3 12 149 12.6 74 5 3
4 18 313 11.5 62 5 4
5 27 NA 14.3 56 5 5
6 28 NA 14.9 66 5 6Si quieres hacerlo en varias columnas, recórrelas con un bucle. En este caso usamos la mediana, que es más robusta cuando la variable es asimétrica:
df2 <- df
for (col in c("Ozone", "Solar.R")) {
  df2[[col]][is.na(df2[[col]])] <- median(df2[[col]], na.rm = TRUE)
}

df2
Ozone Solar.R Wind Temp Month Day
1 41 190.0 7.4 67 5 1
2 36 118.0 8.0 72 5 2
3 12 149.0 12.6 74 5 3
4 18 313.0 11.5 62 5 4
5 28 169.5 14.3 56 5 5
6 28 169.5 14.9 66 5 6Imputar con la media es rápido, pero tiene un coste que debes conocer: mantiene la media pero reduce la variabilidad, ya que todos los valores faltantes toman el mismo valor. Con la columna Ozone completa, la desviación típica pasa de 32.99 a 28.69 tras la imputación:
aqm <- airquality
aqm$Ozone[is.na(aqm$Ozone)] <- mean(aqm$Ozone, na.rm = TRUE)

sd(airquality$Ozone, na.rm = TRUE)
sd(aqm$Ozone)
[1] 32.98788
[1] 28.69337Los siguientes histogramas muestran el efecto: los 37 valores imputados se acumulan en una sola barra alrededor de 42, creando un pico que no existía en los datos originales.
aqm <- airquality
aqm$Ozone[is.na(aqm$Ozone)] <- mean(aqm$Ozone, na.rm = TRUE)

par(mfrow = c(1, 2))
hist(airquality$Ozone, breaks = 20, col = 4,
     main = "Original (sin NA)", xlab = "Ozono")
hist(aqm$Ozone, breaks = 20, col = 2,
     main = "NA reemplazados por la media", xlab = "Ozono")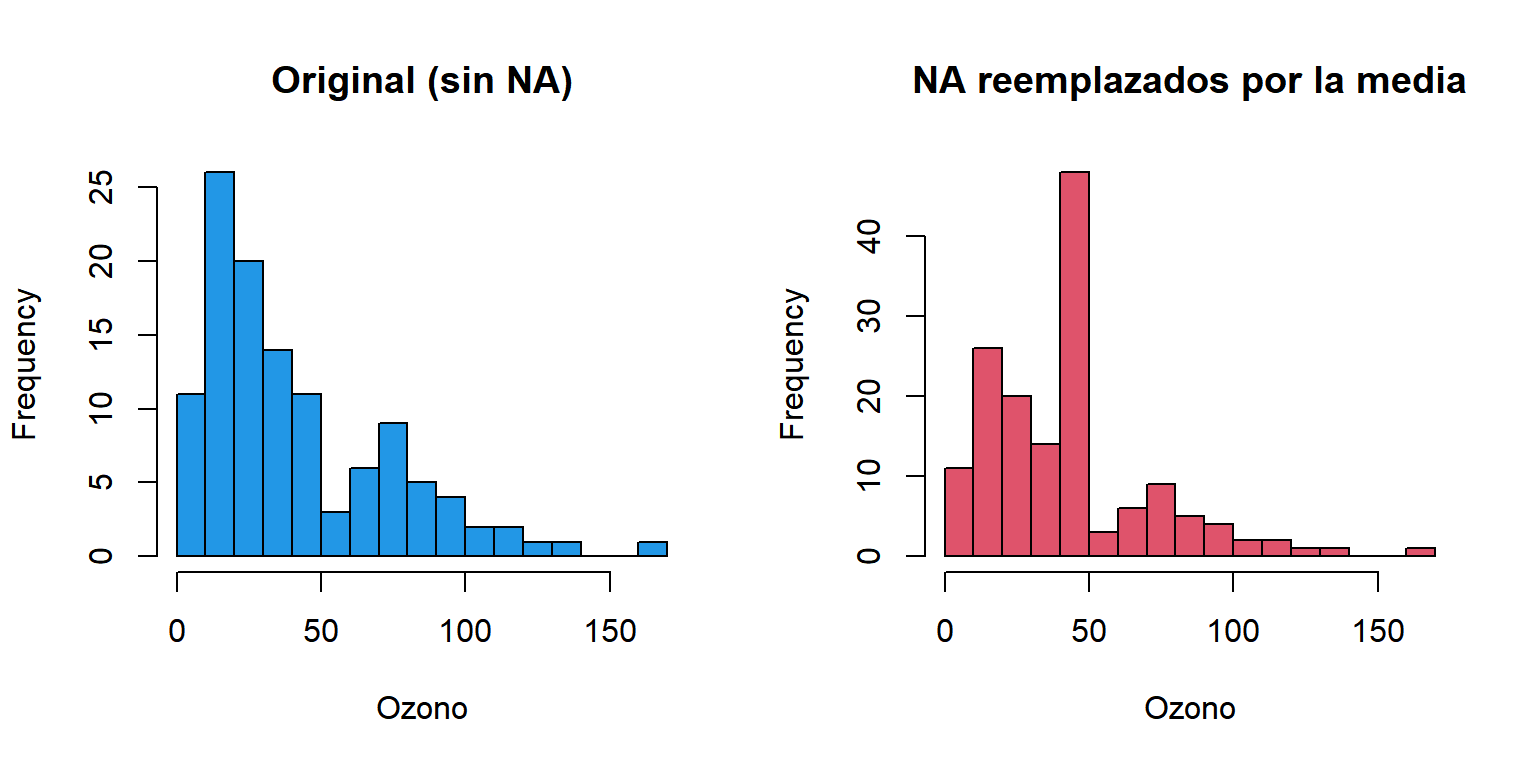
Por eso imputar con la media o la mediana está bien para explorar los datos o cuando hay pocos valores faltantes, pero con un porcentaje alto de NA (como el 24% de Ozone) puede distorsionar varianzas, correlaciones y contrastes.
Reemplazar NA con dplyr y tidyr
La función replace_na de tidyr permite indicar un valor de reemplazo diferente para cada columna con una lista con nombres:
library(dplyr)
library(tidyr)

df %>%
  replace_na(list(Ozone = 0, Solar.R = 0))
Ozone Solar.R Wind Temp Month Day
1 41 190 7.4 67 5 1
2 36 118 8.0 72 5 2
3 12 149 12.6 74 5 3
4 18 313 11.5 62 5 4
5 0 0 14.3 56 5 5
6 28 0 14.9 66 5 6También puede usarse dentro de mutate sobre una sola columna, y combinarse con across para reemplazar los NA de varias columnas por su mediana:
df %>%
  mutate(across(c(Ozone, Solar.R),
                ~ replace_na(as.numeric(.x), median(.x, na.rm = TRUE))))
Ozone Solar.R Wind Temp Month Day
1 41 190.0 7.4 67 5 1
2 36 118.0 8.0 72 5 2
3 12 149.0 12.6 74 5 3
4 18 313.0 11.5 62 5 4
5 28 169.5 14.3 56 5 5
6 28 169.5 14.9 66 5 6Necesitas as.numeric porque Ozone y Solar.R son columnas de enteros y la mediana de Solar.R es 169.5. Sin él, replace_na se niega a cambiar el tipo de la columna y falla con el error Can't convert from 'replace' <double> to 'data' <integer> due to loss of precision.
Por último, coalesce de dplyr devuelve, para cada posición, el primer valor que no es NA entre varios vectores. Con un único valor como último argumento funciona como un reemplazo, y con varios vectores te permite rellenar los huecos de una columna con los valores de otra:
coalesce(c(NA, 2, NA), c(10, 20, NA), 0)[1] 10 2 0El primer elemento toma el 10 del segundo vector, el segundo conserva su 2 y el tercero es NA en ambos vectores, así que toma el 0.
NA al importar un archivo CSV
Cuando lees un archivo CSV, R solo considera faltantes las celdas que contienen NA. Las celdas vacías de las columnas de texto, o códigos como n/a o -99, se leen como valores normales. Considera este archivo:
writeLines(c("id,nota,ciudad",
             "1,8.5,Madrid",
             "2,,París",
             "3,-99,",
             "4,n/a,Roma"), "notas.csv")

d <- read.csv("notas.csv")
str(d)
'data.frame': 4 obs. of 3 variables:
$ id : int 1 2 3 4
$ nota : chr "8.5" "" "-99" "n/a"
$ ciudad: chr "Madrid" "París" "" "Roma"La columna nota se ha leído como texto en lugar de numérica por culpa del n/a, y ningún valor se reconoce como faltante. La solución es indicar todos los códigos que significan “faltante” en el argumento na.strings:
d2 <- read.csv("notas.csv", na.strings = c("", "NA", "n/a", "-99"))
str(d2)
'data.frame': 4 obs. of 3 variables:
$ id : int 1 2 3 4
$ nota : num 8.5 NA NA NA
$ ciudad: chr "Madrid" "París" NA "Roma"Ahora nota es numérica y los valores faltantes se detectan correctamente. Si usas readr::read_csv, el argumento equivalente es na.
¿Qué método debo usar?
La siguiente tabla resume las opciones vistas en este tutorial:
| Objetivo | R base | dplyr / tidyr |
|---|---|---|
| Saber si hay algún NA | anyNA(df) |
|
| Contar NA por columna | colSums(is.na(df)) |
summarise(across(everything(), ~ sum(is.na(.x)))) |
| Ignorar NA en un cálculo | mean(x, na.rm = TRUE) |
summarise(m = mean(x, na.rm = TRUE)) |
| Eliminar filas con NA en cualquier columna | na.omit(df) o df[complete.cases(df), ] |
drop_na(df) |
| Eliminar filas con NA en algunas columnas | df[!is.na(df$col), ] |
drop_na(df, col) o filter(!is.na(col)) |
| Reemplazar NA por 0 | df[is.na(df)] <- 0 |
replace_na(list(col = 0)) |
| Reemplazar NA por la media/mediana | x[is.na(x)] <- mean(x, na.rm = TRUE) |
mutate(col = replace_na(col, mean(col, na.rm = TRUE))) |
| Rellenar NA con valores de otra columna | ifelse(is.na(a), b, a) |
coalesce(a, b) |
Como regla general:
- Si el porcentaje de NA es pequeño y los valores faltantes son aleatorios, eliminar las filas (revisando solo las columnas que necesitas) es la opción más sencilla y honesta.
- Si eliminarlas supone perder muchos datos, plantéate imputar, pero ten en cuenta que la media o la mediana reducen la variabilidad.
- Reemplaza por 0 solo cuando el valor faltante signifique realmente cero.