Distribución t de Student en R
La distribución t de Student es la que está detrás del t-test y del intervalo de confianza para la media. En este tutorial aprenderás a usar las funciones dt, pt, qt y rt en R, a calcular un p-valor a partir del estadístico t, a obtener valores críticos de la t y a construir un intervalo de confianza a mano, comprobando cada resultado con la salida de t.test.
La distribución t de Student
La distribución t aparece cuando tipificas una media muestral usando la desviación típica de la muestra en lugar de la verdadera, que es desconocida. Si \(\bar{x}\) es la media de una muestra de tamaño \(n\) de una población normal con media \(\mu\), entonces
\[t = \frac{\bar{x} - \mu}{s / \sqrt{n}}\]
sigue una distribución t con \(n - 1\) grados de libertad (gl). Los grados de libertad son el único parámetro de la distribución.
Sea \(X \sim t_{\nu}\), es decir, una variable aleatoria con distribución t de \(\nu\) grados de libertad:
- Es simétrica respecto al 0 y tiene forma de campana, como la normal estándar.
- Tiene colas más pesadas que la normal: los valores extremos son más probables, porque estimar la desviación típica añade incertidumbre.
- La esperanza y la varianza son \(E(X) = 0\) (si \(\nu > 1\)) y \(Var(X) = \frac{\nu}{\nu - 2}\) (si \(\nu > 2\)).
- A medida que \(\nu\) aumenta, la t se aproxima a la normal estándar.
En R tienes cuatro funciones para la distribución t, con la misma lógica de nombres que las funciones de la distribución normal:
| Función | Descripción | Uso habitual |
|---|---|---|
| dt | Densidad t (Función de densidad de probabilidad) |
Dibujar la curva |
| pt | Distribución t (Función de distribución acumulada) |
p-valores |
| qt | Función cuantil de la distribución t | Valores críticos e intervalos de confianza |
| rt | Generación de números pseudoaleatorios t |
Simulación |
A diferencia de dnorm y compañía, el argumento df no tiene valor por defecto. Si te olvidas de él, R devolverá el error argument “df” is missing, with no default (el argumento “df” está ausente, sin valor por omisión si tienes R en español).
La función dt
La función dt devuelve la densidad de la distribución t para un vector de valores x. Su sintaxis es la siguiente:
dt(x,          # Vector de valores (cuantiles)
   df,         # Grados de libertad (> 0, pueden ser no enteros)
   ncp,        # Parámetro de no centralidad (opcional)
   log = FALSE) # Si es TRUE, las densidades se devuelven en logaritmo
Por ejemplo, puedes comparar la densidad de una t con 5 grados de libertad con la de una normal estándar en -2, 0 y 2:
dt(c(-2, 0, 2), df = 5)
dnorm(c(-2, 0, 2))
[1] 0.06509031 0.37960669 0.06509031
[1] 0.05399097 0.39894228 0.05399097La densidad de la t es menor en el centro (0.380 frente a 0.399) y mayor en las colas (0.065 frente a 0.054). Eso es justo lo que significa tener “colas más pesadas”.
Dibujar la distribución t en R
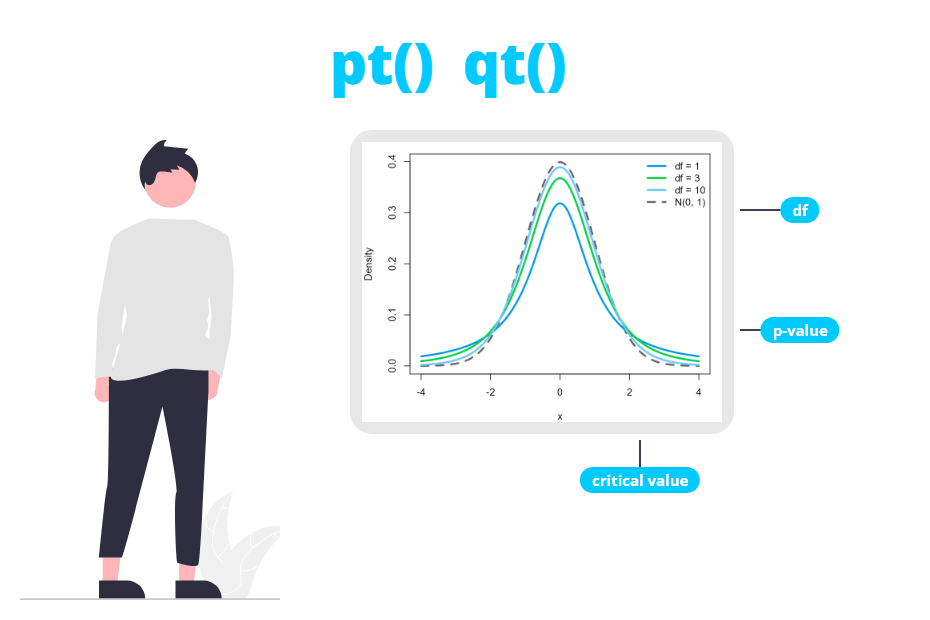
En el siguiente gráfico tienes la densidad de la t con 1, 3 y 10 grados de libertad junto a la densidad de la normal estándar (línea discontinua). Fíjate en cómo la curva se acerca a la normal al aumentar los grados de libertad:
# Rejilla de valores del eje X
x <- seq(-4, 4, length = 200)

# Normal estándar (discontinua)
plot(x, dnorm(x), type = "l", lwd = 2, lty = 2, col = "black",
     ylab = "Densidad", xlab = "x", ylim = c(0, 0.4))

# Distribuciones t
lines(x, dt(x, df = 1), lwd = 2, col = "red")
lines(x, dt(x, df = 3), lwd = 2, col = "orange")
lines(x, dt(x, df = 10), lwd = 2, col = "blue")

legend("topright", legend = c("gl = 1", "gl = 3", "gl = 10", "N(0, 1)"),
       col = c("red", "orange", "blue", "black"), lty = c(1, 1, 1, 2),
       lwd = 2, box.lty = 0)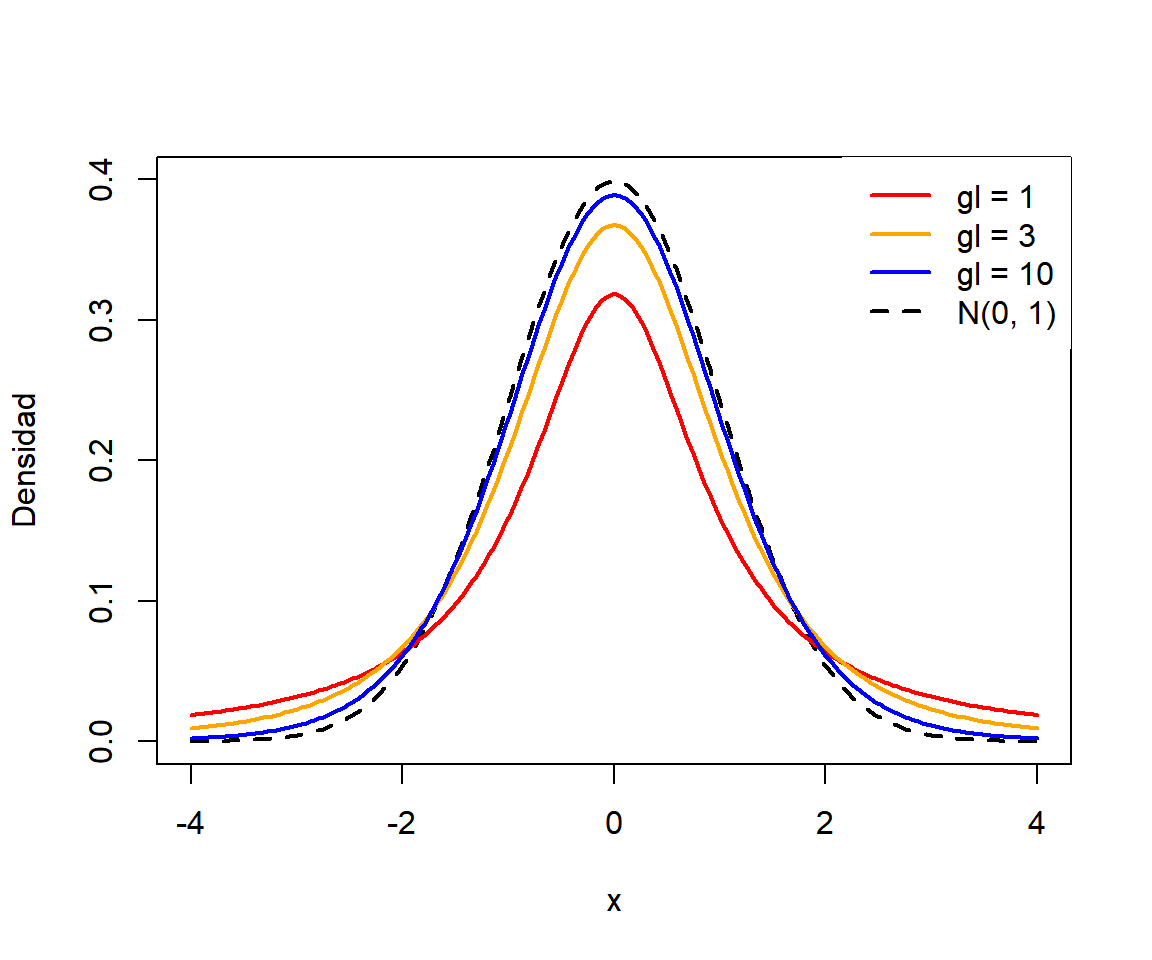
Con 10 grados de libertad la curva t ya es muy parecida a la normal, pero la diferencia en las colas es la que importa cuando calculas p-valores y valores críticos, como verás en las siguientes secciones.
La función pt
La función pt devuelve la función de distribución acumulada de la t, es decir, la probabilidad \(P(X \leq q)\). Con lower.tail = FALSE obtienes la cola superior, \(P(X > q)\).
pt(q,                 # Vector de cuantiles
   df,                # Grados de libertad
   ncp,               # Parámetro de no centralidad (opcional)
   lower.tail = TRUE, # Si es TRUE, P(X <= q); si no, P(X > q)
   log.p = FALSE)     # Si es TRUE, las probabilidades se devuelven en logaritmo
Como ejemplo, la probabilidad de que una t con 10 grados de libertad tome un valor menor que 2 y mayor que 2 es:
pt(2, df = 10)                     # P(X <= 2)
pt(2, df = 10, lower.tail = FALSE) # P(X > 2)
1 - pt(2, df = 10)                 # Equivalente
[1] 0.963306
[1] 0.03669402
[1] 0.03669402Para el mismo valor, pnorm(2, lower.tail = FALSE) devuelve 0.02275, así que la probabilidad de superar el 2 es mayor con la distribución t.
Si necesitas la probabilidad de un intervalo, resta las dos probabilidades acumuladas. Por ejemplo, \(P(-1 < X < 1)\) con 10 gl:
pt(1, df = 10) - pt(-1, df = 10)[1] 0.6591069p-valor a partir del estadístico t
Este es el uso más habitual de pt. Supón que quieres contrastar si el consumo medio de los coches de mtcars es igual a 18 millas por galón. El t-test devuelve:
t.test(mtcars$mpg, mu = 18) One Sample t-test
data: mtcars$mpg
t = 1.9622, df = 31, p-value = 0.05876
alternative hypothesis: true mean is not equal to 18
95 percent confidence interval:
17.91768 22.26357
sample estimates:
mean of x
20.09062Puedes reproducir el estadístico y el p-valor a mano. Primero, calcula el estadístico t con la media y la desviación típica de la muestra:
x <- mtcars$mpg
n <- length(x)

# Estadístico t
t_stat <- (mean(x) - 18) / (sd(x) / sqrt(n))
t_stat
[1] 1.962247El p-valor depende de la hipótesis alternativa. En un contraste bilateral necesitas la probabilidad de las dos colas, así que duplicas la probabilidad de la cola que queda más allá de \(|t|\):
# p-valor bilateral (alternative = "two.sided")
2 * pt(-abs(t_stat), df = n - 1)

# Equivalente
2 * pt(abs(t_stat), df = n - 1, lower.tail = FALSE)
[1] 0.05876422
[1] 0.05876422El resultado coincide con el p-valor de t.test. En los contrastes unilaterales solo necesitas una cola:
# alternative = "greater": P(T > t)
pt(t_stat, df = n - 1, lower.tail = FALSE)

# alternative = "less": P(T < t)
pt(t_stat, df = n - 1)
[1] 0.02938211
[1] 0.9706179Son los mismos valores que obtendrías con t.test(x, mu = 18, alternative = "greater") y con alternative = "less". Fíjate en que el contraste bilateral no es significativo al 5% (0.0588), mientras que el unilateral “greater” sí lo es (0.0294). La hipótesis alternativa se elige antes de mirar los datos, no para conseguir un p-valor más bajo.
Dos errores muy comunes: escribir 2 * pt(t_stat, df) sin abs(), que con un estadístico positivo devuelve un “p-valor” mayor que 1 (aquí, 1.941), y usar pnorm en lugar de pt. Con 2 * pnorm(-abs(t_stat)) obtendrías 0.0497 en lugar de 0.0588 y rechazarías por error la hipótesis nula al 5%.
La función qt
La función qt es la inversa de pt: dada una probabilidad \(p\), devuelve el valor \(q\) tal que \(P(X \leq q) = p\). La usarás sobre todo para obtener valores críticos e intervalos de confianza.
qt(p,                 # Vector de probabilidades
   df,                # Grados de libertad
   ncp,               # Parámetro de no centralidad (opcional)
   lower.tail = TRUE, # Si es TRUE, P(X <= x); si no, P(X > x)
   log.p = FALSE)     # Si es TRUE, las probabilidades se dan en logaritmo
Valores críticos de la t
En un contraste bilateral con nivel de significación \(\alpha\), el valor crítico deja \(\alpha/2\) en cada cola, así que necesitas el cuantil \(1 - \alpha/2\). Para \(\alpha = 0.05\) y 31 grados de libertad:
qt(0.975, df = 31) # Bilateral, alpha = 0.05
qt(0.025, df = 31) # Valor crítico inferior (simétrico)
qt(0.95, df = 31)  # Unilateral, alpha = 0.05
[1] 2.039513
[1] -2.039513
[1] 1.695519En el ejemplo anterior \(|t| = 1.962 < 2.0395\), así que no rechazas \(H_0\) en el contraste bilateral, lo que concuerda con el p-valor de 0.0588. Con la normal, el valor crítico habría sido qnorm(0.975) = 1.96, menor que el de la t.
El error más frecuente con qt es usar qt(0.95, df) en un contraste bilateral al 5%. Para contrastes bilaterales e intervalos de confianza al 95% necesitas qt(0.975, df).
También puedes crear tu propia tabla de valores críticos con sapply. El siguiente código devuelve los valores críticos bilaterales para varios grados de libertad y niveles de significación. Con df = Inf obtienes los cuantiles de la normal:
dfs <- c(1, 2, 5, 10, 20, 30, 50, 100, Inf)
alpha <- c(0.10, 0.05, 0.01)

# Valores críticos bilaterales
crit <- sapply(alpha, function(a) qt(1 - a / 2, df = dfs))
dimnames(crit) <- list(df = dfs, alpha = alpha)
round(crit, 3)
alpha
df 0.1 0.05 0.01
1 6.314 12.706 63.657
2 2.920 4.303 9.925
5 2.015 2.571 4.032
10 1.812 2.228 3.169
20 1.725 2.086 2.845
30 1.697 2.042 2.750
50 1.676 2.009 2.678
100 1.660 1.984 2.626
Inf 1.645 1.960 2.576Con pocos grados de libertad los valores críticos son mucho mayores que los de la normal (12.706 frente a 1.96 con 1 gl). A partir de unos 30 gl la diferencia es pequeña, pero en R no tiene sentido usar la aproximación normal: qt es igual de fácil de usar.
Intervalo de confianza para la media a mano
El intervalo de confianza para la media con nivel de confianza \(1 - \alpha\) es
\[\bar{x} \pm t_{1 - \alpha/2,\, n-1} \frac{s}{\sqrt{n}}\]
Por tanto, puedes calcular el intervalo al 95% de la variable mpg así:
x <- mtcars$mpg
n <- length(x)

se <- sd(x) / sqrt(n)              # Error estándar
t_crit <- qt(0.975, df = n - 1)    # Valor crítico

c(mean(x) - t_crit * se, mean(x) + t_crit * se)

# Comparación con t.test
t.test(x)$conf.int
[1] 17.91768 22.26357
[1] 17.91768 22.26357
attr(,"conf.level")
[1] 0.95Los dos intervalos son idénticos. Para un intervalo al 99% basta con cambiar 0.975 por 0.995. Recuerda que el intervalo se basa en los mismos supuestos que el t-test: observaciones independientes y una población aproximadamente normal (o una muestra suficientemente grande).
La función rt
La función rt genera valores aleatorios de una distribución t. Como con cualquier función de generación aleatoria, fija una semilla para que los resultados sean reproducibles:
rt(n,   # Número de observaciones a generar
   df,  # Grados de libertad
   ncp) # Parámetro de no centralidad (opcional)
set.seed(1)
rt(5, df = 10)[1] -0.6329433 -0.6401328 0.4306047 -0.3110855 -0.2373372La simulación es una buena forma de comprobar las propiedades teóricas. Con 5 grados de libertad la varianza debería ser \(5 / (5 - 2) = 1.667\), mayor que la de la normal estándar:
set.seed(1)
y <- rt(100000, df = 5)

mean(y)
var(y)
[1] -0.005257564
[1] 1.657237Puedes usar rt para generar datos con valores atípicos (colas pesadas) cuando quieras comprobar lo robusto que es un método, por ejemplo, comparando el t-test con el test de Wilcoxon.
Distribución t no central
Todas las funciones aceptan el argumento ncp (parámetro de no centralidad). La distribución t no central es la distribución del estadístico t cuando la hipótesis nula es falsa, por lo que se usa para calcular la potencia de un t-test.
Por ejemplo, la potencia de un t-test bilateral de una muestra con \(n = 20\) y una diferencia real de media desviación típica (\(\delta = 0.5\)) es la probabilidad de superar el valor crítico bajo una t con \(ncp = \delta \sqrt{n}\):
n <- 20
d <- 0.5
t_crit <- qt(0.975, df = n - 1)

pt(t_crit, df = n - 1, ncp = d * sqrt(n), lower.tail = FALSE)
[1] 0.5644829Es el mismo valor que devuelve power.t.test(n = 20, delta = 0.5, sd = 1, type = "one.sample"), así que con 20 observaciones solo detectarías esa diferencia en torno al 56% de las veces.