ANOVA en R: análisis de la varianza de una y dos vías
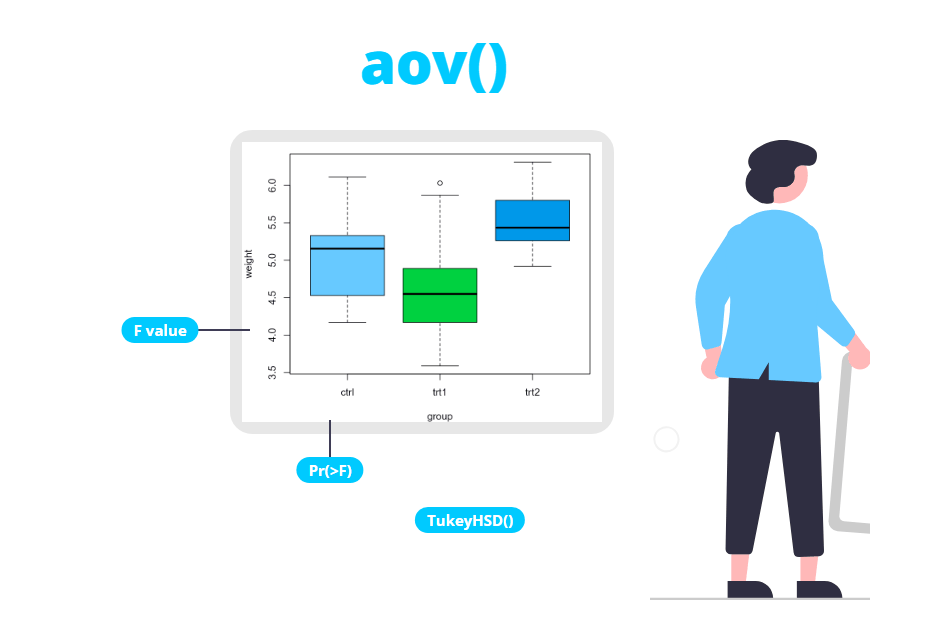
El análisis de la varianza (ANOVA) se utiliza para contrastar si las medias de tres o más grupos independientes son iguales. En R puedes ajustarlo con la función aov y mostrar la tabla ANOVA con summary. En este tutorial aprenderás a hacer un ANOVA de una y de dos vías, a leer cada columna de la salida, a comprobar los supuestos, qué hacer cuando no se cumplen y cómo averiguar qué grupos son distintos con el test post-hoc de Tukey.
Cuándo usar un ANOVA
Utiliza un ANOVA de una vía cuando tengas una variable respuesta numérica y una variable categórica (factor) con tres o más grupos, y quieras saber si la media de la respuesta cambia entre grupos. Si solo tienes dos grupos, el ANOVA de una vía equivale a la prueba t con varianzas iguales.
Un error habitual es hacer varias pruebas t (una por cada pareja de grupos) en lugar de un ANOVA: con tres grupos necesitas tres pruebas y la probabilidad de obtener al menos un falso positivo sube muy por encima del 5%. El ANOVA compara todas las medias con un único contraste.
Las hipótesis del ANOVA de una vía son:
- \(H_0\): todas las medias de los grupos son iguales, \(\mu_1 = \mu_2 = \dots = \mu_k\).
- \(H_1\): al menos la media de un grupo es diferente de las demás.
El contraste supone que las observaciones son independientes, que los residuos siguen una distribución normal y que la varianza es la misma en todos los grupos (homocedasticidad). Más adelante verás cómo comprobar los dos últimos supuestos.
ANOVA de una vía en R con aov
Para este ejemplo vamos a utilizar el conjunto de datos PlantGrowth, que contiene el peso seco de 30 plantas (weight) obtenidas con un grupo de control y dos tratamientos distintos (group, con los niveles ctrl, trt1 y trt2), con 10 plantas en cada grupo.
El primer paso es un análisis exploratorio. Un box plot por grupo te da una primera idea de las diferencias entre grupos y de su dispersión:
# Datos de muestra
df <- PlantGrowth

# Box plot
boxplot(weight ~ group, data = df, col = 4, xlab = "Grupo", ylab = "Peso seco")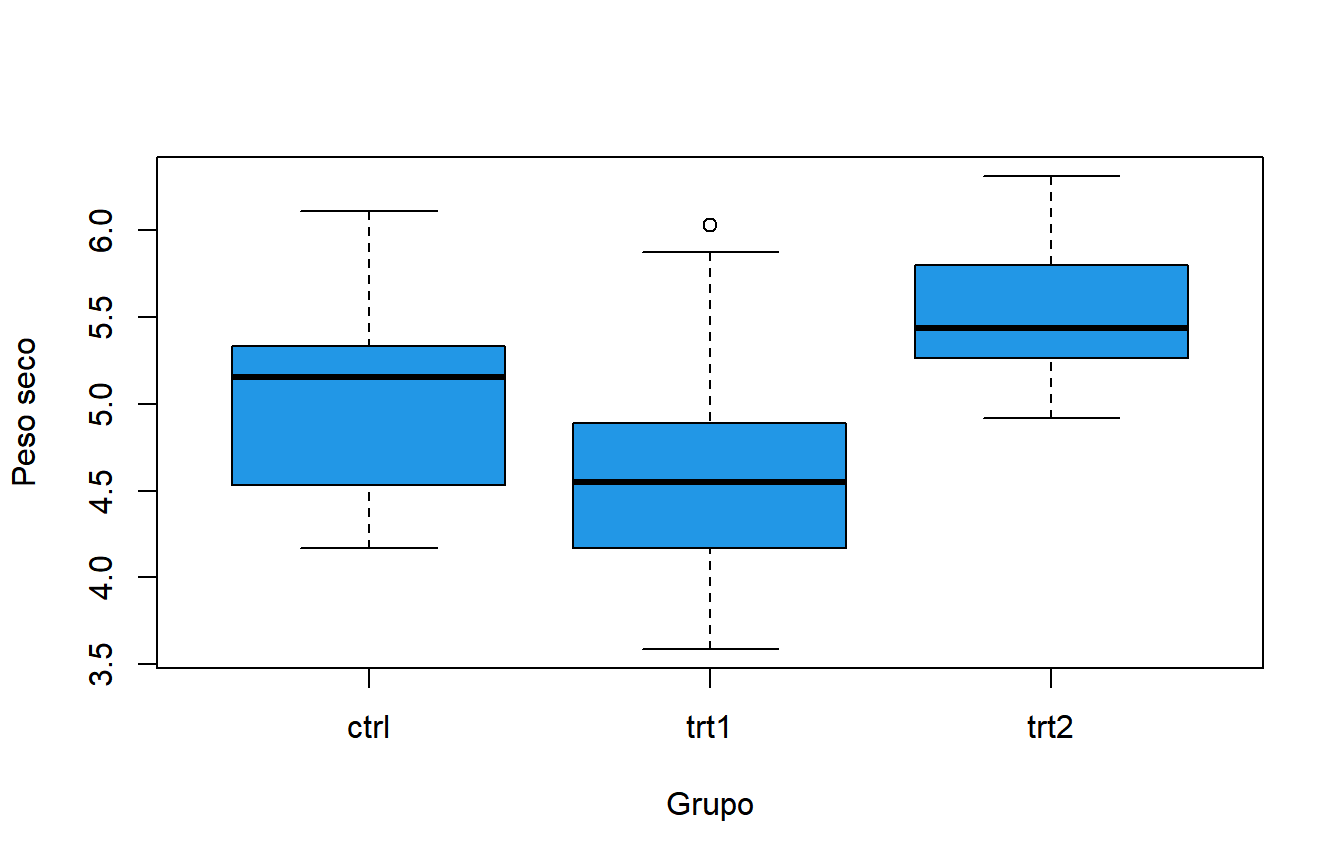
El tratamiento 2 parece producir plantas más pesadas y el tratamiento 1 más ligeras que el control. También puedes calcular la media y la desviación típica de cada grupo con aggregate (o con tapply):
# Datos de muestra
df <- PlantGrowth

aggregate(weight ~ group, data = df,
          FUN = function(x) c(mean = mean(x), sd = sd(x)))
group weight.mean weight.sd
1 ctrl 5.0320000 0.5830914
2 trt1 4.6610000 0.7936757
3 trt2 5.5260000 0.4425733La pregunta es si estas diferencias entre medias son mayores de lo que cabría esperar por azar. Para responderla, ajusta el modelo con aov utilizando una fórmula (respuesta a la izquierda, factor a la derecha) y pasa el resultado a summary:
# Datos de muestra
df <- PlantGrowth

# ANOVA de una vía
fit <- aov(weight ~ group, data = df)

summary(fit)
Df Sum Sq Mean Sq F value Pr(>F)
group 2 3.766 1.8832 4.846 0.0159 *
Residuals 27 10.492 0.3886
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1La variable que define los grupos tiene que ser un factor o un vector de texto. Si los grupos están codificados con números (por ejemplo 1, 2 y 3), conviértelos antes con factor(). De lo contrario, aov tratará la variable como numérica y ajustará una recta con un solo grado de libertad en lugar de comparar grupos.
Cómo interpretar la tabla ANOVA
La salida de summary(aov) es la clásica tabla ANOVA. La fila group describe la variabilidad entre grupos y la fila Residuals la variabilidad dentro de los grupos. Cada columna significa lo siguiente:
- Df (grados de libertad): número de grupos menos uno para
group(\(3 - 1 = 2\)) y número de observaciones menos número de grupos para los residuos (\(30 - 3 = 27\)). - Sum Sq (suma de cuadrados): la variabilidad que explican los grupos (3.766) y la que queda dentro de los grupos (10.492).
- Mean Sq (cuadrados medios): cada suma de cuadrados dividida entre sus grados de libertad, \(3.766 / 2 = 1.8832\) y \(10.492 / 27 = 0.3886\). El cuadrado medio residual es la estimación de la varianza común de los grupos.
- F value: el cociente entre los dos cuadrados medios, \(F = 1.8832 / 0.3886 = 4.846\). Si \(H_0\) es cierta, debería estar cerca de 1. Cuanto mayor sea F, mayores son las diferencias entre grupos en comparación con el ruido dentro de los grupos.
- Pr(>F): el p-valor, la probabilidad de obtener un estadístico F tan grande si todas las medias fueran iguales. Se calcula a partir de una distribución F con 2 y 27 grados de libertad, la misma distribución que utiliza el test F para comparar dos varianzas.
El p-valor es 0.0159, menor que el nivel de significación habitual de 0.05, así que hay evidencia estadística de que al menos una de las medias es diferente. El asterisco junto al p-valor es solo una ayuda visual basada en los códigos de significación que aparecen debajo de la tabla.
Un ANOVA significativo no te dice qué grupos son distintos, solo que no todas las medias son iguales. Para identificar los grupos necesitas un test post-hoc, como el test de Tukey que se explica más abajo.
Comprobación de los supuestos
Los supuestos del ANOVA se comprueban sobre los residuos del modelo, es decir, sobre la diferencia entre cada observación y la media de su grupo.
Normalidad de los residuos
Puedes comprobar la normalidad visualmente con un gráfico Q-Q de los residuos. Si son normales, los puntos deberían quedar cerca de la recta.
df <- PlantGrowth
fit <- aov(weight ~ group, data = df)

qqnorm(residuals(fit), pch = 19, col = 4,
       main = "Gráfico Q-Q normal", xlab = "Cuantiles teóricos", ylab = "Cuantiles muestrales")
qqline(residuals(fit), lwd = 2)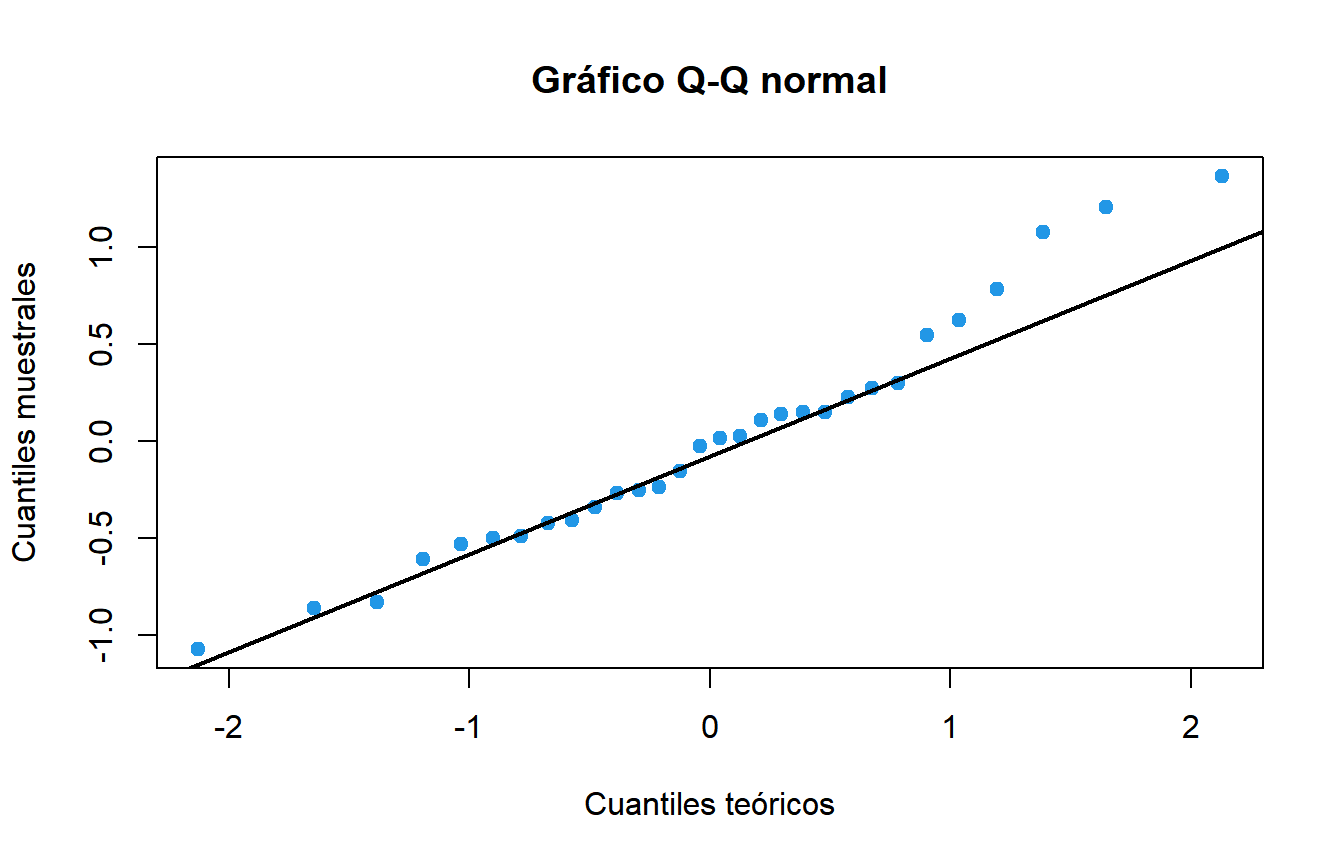
Los puntos siguen la recta razonablemente bien. Para confirmarlo de manera formal, aplica el test de Shapiro-Wilk a los residuos:
shapiro.test(residuals(fit)) Shapiro-Wilk normality test
data: residuals(fit)
W = 0.96607, p-value = 0.4379El p-valor (0.4379) es mayor que 0.05, así que no hay evidencia en contra de la normalidad de los residuos.
Homogeneidad de varianzas
Para comprobar si las varianzas son iguales entre grupos puedes utilizar el test de Levene (leveneTest del paquete car), que es robusto frente a la falta de normalidad, o el test de Bartlett (bartlett.test), que es más potente cuando los datos son normales. En ambos casos la hipótesis nula es que todas las varianzas son iguales.
library(car)
leveneTest(weight ~ group, data = PlantGrowth)
Levene's Test for Homogeneity of Variance (center = median)
Df F value Pr(>F)
group 2 1.1192 0.3412
27bartlett.test(weight ~ group, data = PlantGrowth) Bartlett test of homogeneity of variances
data: weight by group
Bartlett's K-squared = 2.8786, df = 2, p-value = 0.2371Los dos p-valores (0.3412 y 0.2371) son mayores que 0.05, así que el supuesto de varianzas iguales es razonable y el resultado del ANOVA clásico es válido.
Qué hacer si no se cumplen los supuestos
La elección depende del supuesto que falle:
| Situación | Alternativa | Función |
|---|---|---|
| Residuos normales, varianzas distintas | ANOVA de Welch | oneway.test(y ~ g, data) |
| Residuos lejos de la normalidad o con atípicos | Test de Kruskal-Wallis | kruskal.test(y ~ g, data) |
| Se cumplen ambos supuestos | ANOVA clásico | aov(y ~ g, data) |
El ANOVA de Welch no supone varianzas iguales. Es la opción por defecto de oneway.test (var.equal = FALSE):
oneway.test(weight ~ group, data = PlantGrowth) One-way analysis of means (not assuming equal variances)
data: weight and group
F = 5.181, num df = 2.000, denom df = 17.128, p-value = 0.01739Fíjate en que los grados de libertad del denominador no son un número entero: es la corrección por varianzas distintas. Si indicas var.equal = TRUE obtendrás exactamente el mismo F y el mismo p-valor que con aov.
Cuando los residuos claramente no son normales, utiliza el test de Kruskal-Wallis, que es no paramétrico y compara los grupos mediante rangos:
kruskal.test(weight ~ group, data = PlantGrowth) Kruskal-Wallis rank sum test
data: weight by group
Kruskal-Wallis chi-squared = 7.9882, df = 2, p-value = 0.01842En este ejemplo los tres contrastes llevan a la misma conclusión, algo habitual cuando los supuestos se cumplen razonablemente. Con muestras pequeñas, datos asimétricos o varianzas muy distintas pueden no coincidir, y entonces son las alternativas las que debes tener en cuenta.
Comparaciones post-hoc con TukeyHSD
Una vez que el ANOVA es significativo, el test HSD de Tukey (Honestly Significant Difference) compara todas las parejas de grupos controlando la tasa de error global, así que no tienes que corregir tú los p-valores. Pasa el objeto ajustado con aov a la función TukeyHSD:
TukeyHSD(fit) Tukey multiple comparisons of means
95% family-wise confidence level
Fit: aov(formula = weight ~ group, data = df)
$group
diff lwr upr p adj
trt1-ctrl -0.371 -1.0622161 0.3202161 0.3908711
trt2-ctrl 0.494 -0.1972161 1.1852161 0.1979960
trt2-trt1 0.865 0.1737839 1.5562161 0.0120064Cada fila es una comparación entre dos grupos:
diff: diferencia entre las medias de los dos grupos, en el orden que indica el nombre. Por ejemplo, las plantas con el tratamiento 2 pesan de media 0.865 más que las plantas con el tratamiento 1.lwryupr: límites inferior y superior del intervalo de confianza al 95% para esa diferencia. Si el intervalo no contiene el 0, la diferencia es significativa.p adj: p-valor ajustado por comparaciones múltiples.
Solo la comparación trt2-trt1 es significativa (p-valor = 0.012 y un intervalo de 0.17 a 1.56 que no incluye el 0). Ninguno de los tratamientos difiere significativamente del control. Dicho de otro modo, el ANOVA salió significativo porque los dos tratamientos son distintos entre sí, no porque alguno de ellos difiera del control.
Tamaño del efecto: eta cuadrado
El p-valor te dice si hay una diferencia, pero no lo grande que es. El tamaño del efecto más utilizado en el ANOVA es eta cuadrado (\(\eta^2\)), la proporción de la variabilidad total que explican los grupos:
\[\eta^2 = \frac{SC_{entre}}{SC_{total}} = \frac{SC_{entre}}{SC_{entre} + SC_{residual}}\]
Puedes calcularlo directamente a partir de la tabla ANOVA. summary(fit) devuelve una lista cuyo primer elemento es la tabla, así que puedes extraer la columna Sum Sq:
tab <- summary(fit)[[1]]
ss <- tab[["Sum Sq"]]

# Eta cuadrado
ss[1] / sum(ss)
[1] 0.2641483El tratamiento explica en torno al 26% de la variabilidad del peso de las plantas. Como referencia aproximada, valores de 0.01, 0.06 y 0.14 suelen considerarse efectos pequeños, medianos y grandes, así que se trata de un efecto grande.
ANOVA de dos vías con interacción
Un ANOVA de dos vías estudia el efecto de dos factores a la vez y, de manera opcional, su interacción: si el efecto de un factor depende del nivel del otro.
Para este ejemplo vamos a utilizar el conjunto de datos ToothGrowth, que contiene la longitud de los dientes (len) de 60 cobayas que recibieron vitamina C mediante dos métodos (supp: zumo de naranja OJ o ácido ascórbico VC) en tres dosis (dose: 0.5, 1 y 2 mg/día), con 10 animales por combinación.
La variable dose es numérica, así que tienes que convertirla en factor antes de ajustar el modelo. Después, utiliza supp * dose en la fórmula, que es un atajo de supp + dose + supp:dose (los dos efectos principales más la interacción).
# Datos de muestra
df2 <- ToothGrowth
df2$dose <- factor(df2$dose)

# ANOVA de dos vías con interacción
fit2 <- aov(len ~ supp * dose, data = df2)

summary(fit2)
Df Sum Sq Mean Sq F value Pr(>F)
supp 1 205.4 205.4 15.572 0.000231 ***
dose 2 2426.4 1213.2 92.000 < 2e-16 ***
supp:dose 2 108.3 54.2 4.107 0.021860 *
Residuals 54 712.1 13.2
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Ahora la tabla tiene una fila por término y cada fila tiene su propia hipótesis nula:
supp: la longitud media es la misma con ambos suplementos. Se rechaza (p = 0.000231).dose: la longitud media es la misma para las tres dosis. Se rechaza (p < 2e-16).supp:dose: no hay interacción, es decir, el efecto del suplemento es el mismo en todas las dosis. Se rechaza (p = 0.0219).
Mira siempre primero la interacción. Cuando es significativa, los efectos principales no se pueden interpretar por separado, porque la diferencia entre suplementos cambia con la dosis. Un gráfico de interacción lo muestra con claridad:
df2 <- ToothGrowth
df2$dose <- factor(df2$dose)

interaction.plot(x.factor = df2$dose, trace.factor = df2$supp,
                 response = df2$len, col = c(2, 4), lwd = 2,
                 xlab = "Dosis (mg/día)", ylab = "Longitud media del diente",
                 trace.label = "Suplemento")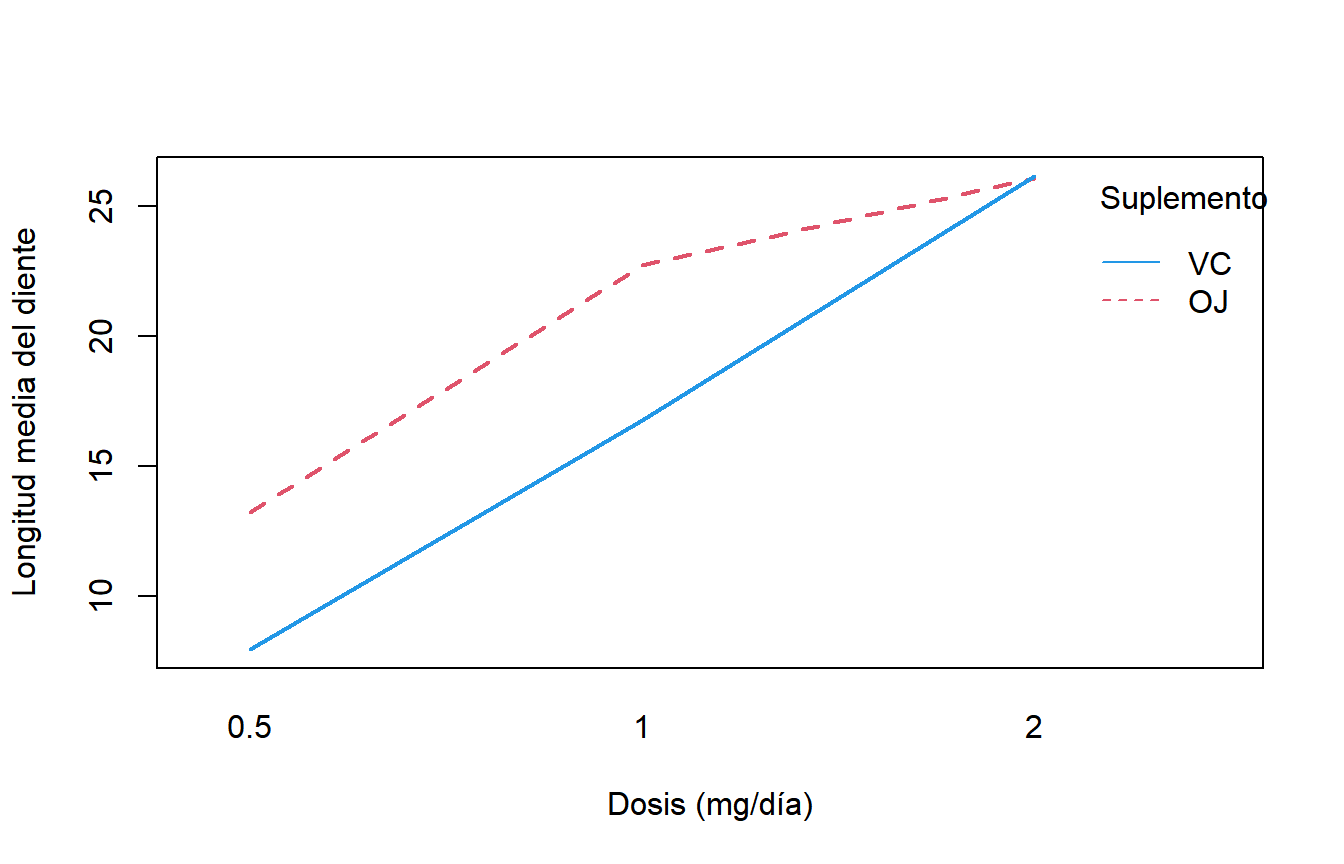
Si no hubiera interacción, las líneas serían más o menos paralelas. Aquí el zumo de naranja produce dientes más largos con 0.5 y 1 mg/día, pero con 2 mg/día los dos suplementos dan prácticamente el mismo resultado. Por tanto, la conclusión correcta no es “el zumo de naranja es mejor”, sino “el zumo de naranja es mejor con dosis bajas y medias”.
La interacción es significativa, pero ¿cómo de importante es? Calcular eta cuadrado para cada término lo pone en perspectiva:
ss2 <- summary(fit2)[[1]][["Sum Sq"]]
eta2 <- ss2 / sum(ss2)
names(eta2) <- c("supp", "dose", "supp:dose", "Residuals")

round(eta2, 3)
supp dose supp:dose Residuals
0.059 0.703 0.031 0.206La dosis explica el 70% de la variabilidad de la longitud de los dientes, mientras que el suplemento y la interacción explican mucho menos. Para comparar los niveles de un factor, puedes usar TukeyHSD con el argumento which:
TukeyHSD(fit2, which = "dose") Tukey multiple comparisons of means
95% family-wise confidence level
Fit: aov(formula = len ~ supp * dose, data = df2)
$dose
diff lwr upr p adj
1-0.5 9.130 6.362488 11.897512 0.0e+00
2-0.5 15.495 12.727488 18.262512 0.0e+00
2-1 6.365 3.597488 9.132512 2.7e-06Todas las dosis son distintas entre sí: cada aumento de la dosis produce dientes significativamente más largos.
Error habitual: un factor numérico
Si te olvidas de convertir dose en factor, aov la trata como una variable numérica. Fíjate en los grados de libertad de dose: hay solo 1 en lugar de 2, porque el modelo ajusta una recta en lugar de comparar tres grupos.
summary(aov(len ~ supp * dose, data = ToothGrowth)) Df Sum Sq Mean Sq F value Pr(>F)
supp 1 205.4 205.4 12.317 0.000894 ***
dose 1 2224.3 2224.3 133.415 < 2e-16 ***
supp:dose 1 88.9 88.9 5.333 0.024631 *
Residuals 56 933.6 16.7
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Revisa siempre la columna Df: para un factor tiene que ser el número de niveles menos uno.
Ten en cuenta también que aov calcula sumas de cuadrados secuenciales (tipo I), así que con datos no balanceados (distinto número de observaciones en cada combinación de factores) el resultado depende del orden de los factores en la fórmula. ToothGrowth está balanceado, por lo que aquí no es un problema. Con datos no balanceados lo habitual es utilizar la función Anova del paquete car con type = 2 o type = 3.
aov frente a lm y anova
El ANOVA es un caso particular del modelo lineal, y aov no es más que una capa sobre lm. Puedes obtener exactamente la misma tabla ajustando el modelo con lm y pasándolo a anova:
fit_lm <- lm(weight ~ group, data = PlantGrowth)
anova(fit_lm)
Analysis of Variance Table
Response: weight
Df Sum Sq Mean Sq F value Pr(>F)
group 2 3.7663 1.8832 4.8461 0.01591 *
Residuals 27 10.4921 0.3886
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Utiliza aov cuando tu objetivo sea comparar grupos, porque funciona directamente con TukeyHSD. Utiliza lm cuando además quieras los coeficientes del modelo: summary(fit_lm) muestra la diferencia de cada grupo respecto al nivel de referencia (ctrl) y el \(R^2\), que coincide con el eta cuadrado calculado antes (0.2641).