Regresión logística en R con glm()
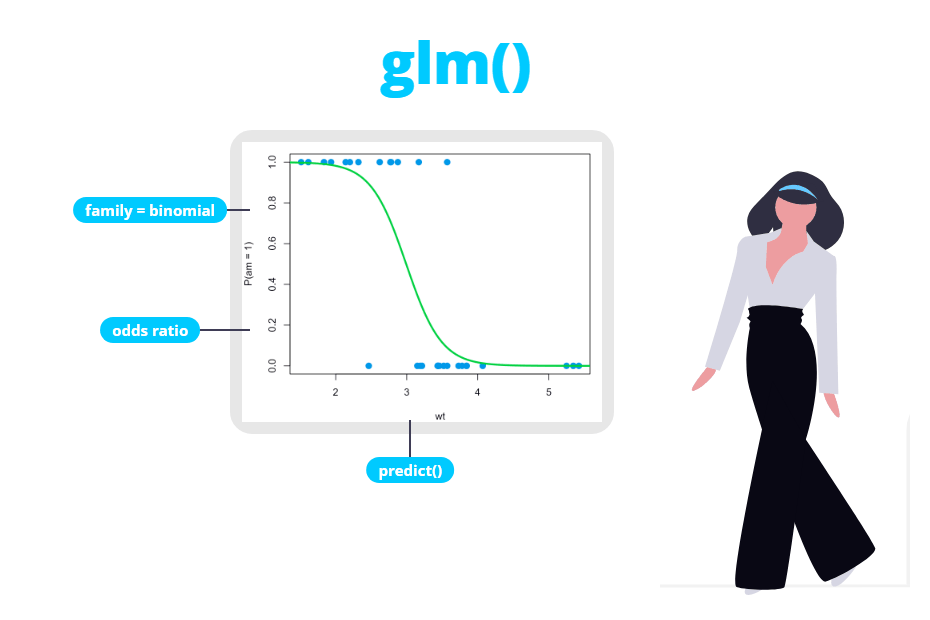
La regresión logística se utiliza para modelizar una variable respuesta binaria (sí/no, éxito/fracaso, 1/0) en función de una o varias variables explicativas. En R puedes ajustarla con la función glm y family = binomial. En este tutorial aprenderás a ajustar el modelo, a leer cada parte de la salida de summary, a calcular y explicar los odds ratios, a obtener probabilidades predichas con predict, a construir una matriz de confusión, a comparar modelos y qué significa el aviso “fitted probabilities numerically 0 or 1 occurred”.
Cuándo usar una regresión logística
Utiliza una regresión logística cuando la variable que quieres explicar solo tiene dos valores posibles: si un paciente tiene una enfermedad, si un cliente compra un producto, si un correo es spam… Las variables explicativas pueden ser numéricas, categóricas o de ambos tipos.
Un modelo lineal no es adecuado para este tipo de datos, porque puede predecir “probabilidades” menores que 0 o mayores que 1, y la varianza de una variable binaria no es constante. La regresión logística resuelve los dos problemas porque modeliza la probabilidad del suceso en una escala que siempre queda entre 0 y 1.
Si solo quieres saber si dos variables categóricas están asociadas, sin un modelo, te basta con un test chi-cuadrado o un test exacto de Fisher sobre la tabla de contingencia. La regresión logística es la herramienta adecuada cuando quieres cuantificar el efecto de varias variables a la vez o predecir la probabilidad para nuevas observaciones.
El modelo logístico
Sea \(p\) la probabilidad del suceso (\(Y = 1\)). Los odds (también llamados ventaja o momio) son el cociente entre la probabilidad de que ocurra el suceso y la de que no ocurra, \(p / (1 - p)\). Por ejemplo, una probabilidad de 0.8 corresponde a unos odds de \(0.8 / 0.2 = 4\) (“4 a 1”). La regresión logística modeliza el logaritmo de los odds, llamado logit o log-odds, como una función lineal de las variables explicativas:
\[\log\left(\frac{p}{1-p}\right) = \beta_0 + \beta_1 x_1 + \dots + \beta_k x_k\]
Si despejas \(p\) obtienes la función logística, que transforma cualquier valor del predictor lineal en una probabilidad entre 0 y 1:
\[p = \frac{1}{1 + e^{-(\beta_0 + \beta_1 x_1 + \dots + \beta_k x_k)}}\]
La idea clave para interpretar la salida es que los coeficientes están en la escala de los log-odds, no en la de la probabilidad. Necesitarás la función exponencial para convertirlos en odds ratios.
Ajustar una regresión logística con glm
Para este ejemplo vamos a utilizar el conjunto de datos Pima.tr del paquete MASS (incluido en cualquier instalación de R), que contiene 200 mujeres de origen indio pima. La variable respuesta es type, un factor que indica si la mujer tiene diabetes (Yes) o no (No). Como variables explicativas utilizaremos la concentración de glucosa en plasma (glu), el índice de masa corporal (bmi) y la edad en años (age).
library(MASS)

# Datos de muestra
df <- Pima.tr
head(df, 3)
table(df$type)
npreg glu bp skin bmi ped age type
1 5 86 68 28 30.2 0.364 24 No
2 7 195 70 33 25.1 0.163 55 Yes
3 5 77 82 41 35.8 0.156 35 No
No Yes
132 68Para ajustar el modelo, utiliza glm con una fórmula (la respuesta a la izquierda y las variables explicativas a la derecha, separadas por +) y family = binomial:
library(MASS)
df <- Pima.tr

# Regresión logística
fit <- glm(type ~ glu + bmi + age, data = df, family = binomial)

summary(fit)
Call:
glm(formula = type ~ glu + bmi + age, family = binomial, data = df)
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) -9.405120 1.477177 -6.367 1.93e-10 ***
glu 0.030850 0.006448 4.784 1.72e-06 ***
bmi 0.091871 0.032242 2.849 0.00438 **
age 0.052569 0.016970 3.098 0.00195 **
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
(Dispersion parameter for binomial family taken to be 1)
Null deviance: 256.41 on 199 degrees of freedom
Residual deviance: 188.39 on 196 degrees of freedom
AIC: 196.39
Number of Fisher Scoring iterations: 5La respuesta puede ser un factor con dos niveles, un vector lógico o un vector numérico de 0 y 1. Con un factor, R modeliza la probabilidad del segundo nivel, en este caso Yes (por defecto los niveles se ordenan alfabéticamente). Si quieres modelizar el otro nivel, cambia la referencia con relevel.
Si olvidas family = binomial, glm ajusta un modelo lineal normal (la familia por defecto es gaussian) y con una respuesta de tipo factor obtendrás un error. Y si la respuesta es un vector de texto en lugar de un factor, glm falla con el error y values must be 0 <= y <= 1. Conviértela antes con factor() o crea una variable 0/1 con ifelse.
Cómo interpretar la salida de summary
Tabla de coeficientes
Cada fila de la tabla Coefficients corresponde a un término del modelo:
- Estimate: el coeficiente estimado, en la escala de los log-odds. El coeficiente de
glu(0.030850) significa que, para mujeres con el mismo IMC y la misma edad, cada unidad adicional de glucosa aumenta los log-odds de tener diabetes en 0.031. Todos los coeficientes son positivos, así que más glucosa, más IMC y más edad se asocian con una mayor probabilidad de diabetes. - (Intercept): los log-odds cuando todas las variables explicativas valen 0. Aquí no tiene significado práctico, porque nadie tiene una glucosa, un IMC y una edad de 0.
- Std. Error: el error estándar de la estimación, su precisión.
- z value: el estadístico de Wald, la estimación dividida entre su error estándar (\(0.030850 / 0.006448 = 4.784\)). En una regresión logística se compara con una distribución normal estándar, por eso verás
zen lugar de latde un modelo lineal. - Pr(>|z|): el p-valor del contraste \(H_0: \beta_j = 0\), es decir, la variable no tiene efecto sobre los log-odds una vez incluidas las demás variables. Las tres variables son significativas al 5%.
Deviance y AIC
La parte inferior de la salida resume el ajuste del modelo:
- Dispersion parameter: en un modelo binomial vale siempre 1. Puedes ignorarlo.
- Null deviance: la deviance (o desvianza) de un modelo que solo tiene la constante (256.41 con \(n - 1 = 199\) grados de libertad). Mide lo mal que predices la respuesta sin usar ninguna variable.
- Residual deviance: la deviance de tu modelo (188.39 con \(200 - 4 = 196\) grados de libertad). Cuanto menor, mejor. La reducción de 256.41 a 188.39 es lo que explican las tres variables.
- AIC: el criterio de información de Akaike, la deviance residual más dos veces el número de parámetros (\(188.39 + 2 \cdot 4 = 196.39\)). Solo sirve para comparar modelos ajustados sobre los mismos datos: se prefiere el modelo con el AIC más bajo.
- Number of Fisher Scoring iterations: las iteraciones que ha necesitado el algoritmo de ajuste. Un número muy alto (por ejemplo, 25) es señal de problemas, como verás en el último apartado.
La diferencia entre ambas deviances sigue una distribución chi-cuadrado con tantos grados de libertad como variables añadidas (3). Puedes usarla para contrastar si el modelo en conjunto es mejor que un modelo sin variables:
with(fit, pchisq(null.deviance - deviance, df.null - df.residual,
                 lower.tail = FALSE))
[1] 1.13209e-14El p-valor es prácticamente 0, así que el modelo explica la respuesta significativamente mejor que el modelo nulo.
Odds ratios con exp(coef)
Los log-odds son difíciles de explicar. Si calculas la exponencial de un coeficiente obtienes un odds ratio (OR, o razón de odds): el factor por el que se multiplican los odds del suceso cuando la variable aumenta una unidad, manteniendo constantes las demás variables. Para obtener los odds ratios con sus intervalos de confianza al 95%, aplica exp a coef y a confint:
exp(cbind(OR = coef(fit), confint(fit)))Waiting for profiling to be done...
OR 2.5 % 97.5 %
(Intercept) 8.230159e-05 3.661449e-06 0.001234031
glu 1.031331e+00 1.018923e+00 1.045154319
bmi 1.096223e+00 1.030776e+00 1.170482427
age 1.053975e+00 1.020132e+00 1.090750279Un odds ratio se interpreta así:
- OR = 1: la variable no cambia los odds.
- OR > 1: los odds aumentan. Un OR de 1.096 para
bmisignifica que cada unidad adicional de IMC multiplica los odds de diabetes por 1.096, es decir, los aumenta un 9.6%, para mujeres con la misma glucosa y la misma edad. - OR < 1: los odds disminuyen. Un OR de 0.80 supondría una reducción de los odds del 20% por cada unidad.
En el caso de age, cada año adicional aumenta los odds de diabetes un 5.4% (IC al 95% entre el 2.0% y el 9.1%). Si el intervalo de confianza de un odds ratio no contiene el 1, la variable es significativa al 5%.
Cuando una unidad es un cambio muy pequeño, es más informativo dar el odds ratio para un aumento mayor. El OR para \(c\) unidades es \(e^{c \beta}\), así que para 10 unidades de glucosa:
exp(10 * coef(fit)["glu"]) glu
1.361384Cada aumento de 10 unidades en la concentración de glucosa multiplica los odds de diabetes por 1.36 (un aumento del 36%).
Un odds ratio no es un cociente de probabilidades. “Los odds aumentan un 9.6%” es correcto; “la probabilidad de diabetes aumenta un 9.6%” no lo es. El cambio en la probabilidad depende del punto de partida, por eso es mejor mostrar probabilidades predichas, como en el siguiente apartado. confint calcula intervalos de verosimilitud perfilada, mientras que confint.default calcula los intervalos de Wald, más rápidos; con muestras grandes ambos son muy parecidos.
Probabilidades predichas con predict
La función predict devuelve predicciones para las observaciones usadas en el ajuste o, con el argumento newdata, para observaciones nuevas. El error más habitual es olvidar el argumento type. Por defecto (type = "link"), predict devuelve log-odds, no probabilidades:
# Nuevas observaciones: dos mujeres con IMC 30 y 40 años
nuevas <- data.frame(glu = c(100, 150), bmi = c(30, 30), age = c(40, 40))

# Log-odds (por defecto)
predict(fit, newdata = nuevas)

# Probabilidades
predict(fit, newdata = nuevas, type = "response")
1 2
-1.46121960 0.08128981
1 2
0.1882809 0.5203113Los primeros valores pueden ser negativos y no son probabilidades. Con type = "response" obtienes la probabilidad estimada de tener diabetes: un 18.8% para una mujer con una glucosa de 100 y un 52.0% para una mujer con una glucosa de 150, con el mismo IMC y la misma edad. Fíjate en que aquí un aumento de 50 unidades de glucosa sube la probabilidad 33 puntos porcentuales, pero el mismo aumento produciría un cambio distinto partiendo de otro nivel de glucosa. Si ya tienes los log-odds, plogis() los transforma en probabilidades.
El siguiente gráfico muestra la curva en forma de S de la probabilidad de diabetes para un modelo que solo incluye la glucosa. Los puntos son los valores observados (0 = no, 1 = sí) y la línea discontinua marca una probabilidad de 0.5:
library(MASS)
df <- Pima.tr
fit_glu <- glm(type ~ glu, data = df, family = binomial)

plot(df$glu, as.numeric(df$type == "Yes"), pch = 19, col = 4,
     xlab = "Glucosa en plasma", ylab = "Probabilidad de diabetes")
curve(predict(fit_glu, newdata = data.frame(glu = x), type = "response"),
      add = TRUE, lwd = 2, col = 2)
abline(h = 0.5, lty = 2)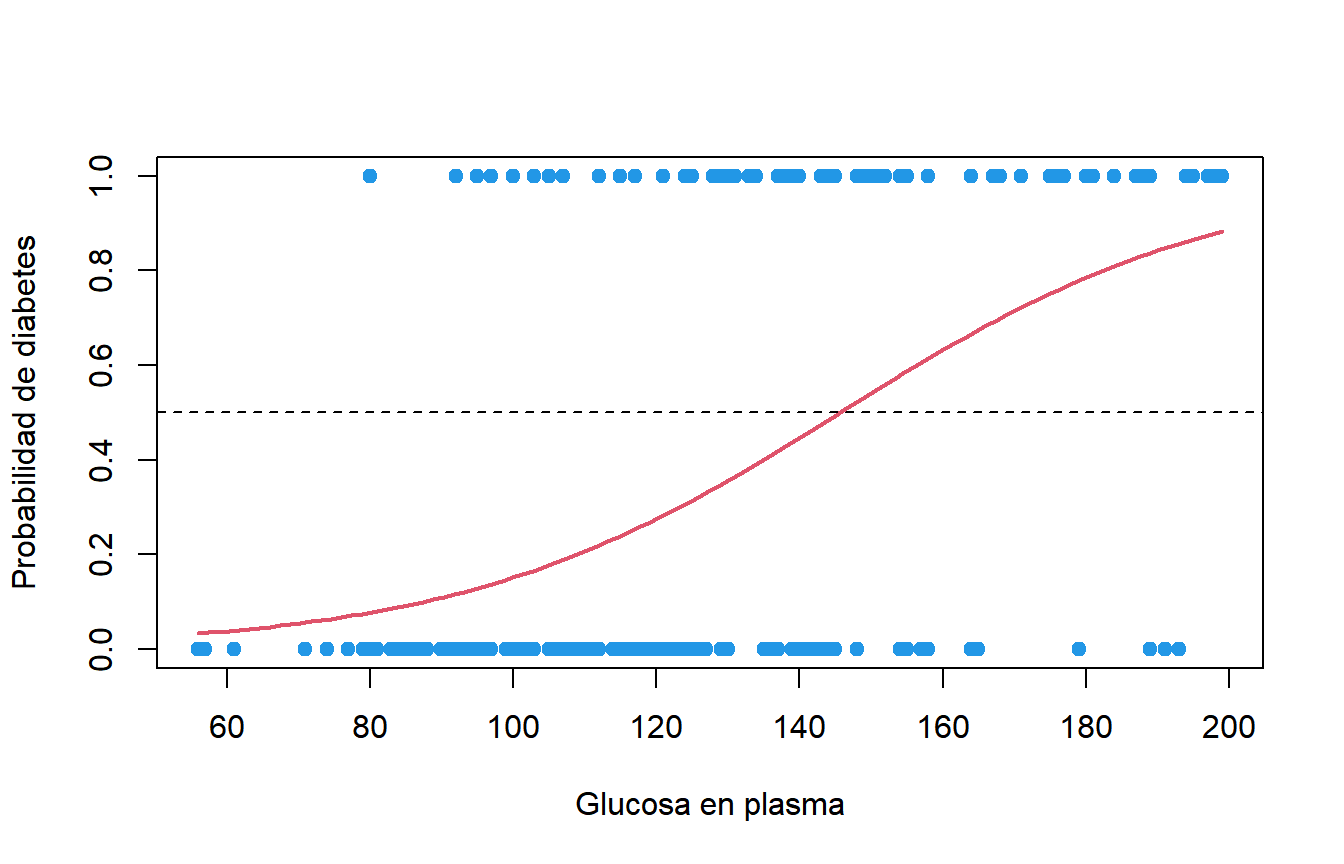
Con este modelo sencillo, la probabilidad predicha supera 0.5 para valores de glucosa por encima de 146.
Clasificación y matriz de confusión
Para convertir las probabilidades en una clase, elige un umbral: el habitual es 0.5. Después compara las clases predichas con las observadas con table, que te da una tabla de contingencia conocida como matriz de confusión:
# Probabilidades y clases predichas
prob <- predict(fit, type = "response")
pred <- ifelse(prob > 0.5, "Yes", "No")
table(Predicted = pred, Observed = df$type)

# Tasa de acierto
mean(pred == df$type)
Observed
Predicted No Yes
No 113 29
Yes 19 39
[1] 0.76La diagonal contiene las predicciones correctas: 113 mujeres sin diabetes y 39 con diabetes están bien clasificadas, así que la tasa de acierto (accuracy) es \((113 + 39) / 200 = 0.76\). Las celdas fuera de la diagonal son los errores: 19 falsos positivos y 29 falsos negativos.
La tasa de acierto calculada sobre los mismos datos del ajuste es optimista. El paquete MASS también incluye Pima.te, 332 mujeres distintas con las mismas variables, que puedes usar como conjunto de test:
prob_te <- predict(fit, newdata = Pima.te, type = "response")
pred_te <- ifelse(prob_te > 0.5, "Yes", "No")
table(Predicted = pred_te, Observed = Pima.te$type)
Observed
Predicted No Yes
No 199 46
Yes 24 63La tasa de acierto en el conjunto de test es \((199 + 63) / 332 = 0.789\). Sin embargo, el modelo solo detecta el \(63 / 109 = 57.8\%\) de las mujeres con diabetes (sensibilidad), mientras que clasifica bien el \(199 / 223 = 89.2\%\) de las mujeres sin diabetes (especificidad).
El umbral de 0.5 no es obligatorio. Si no detectar un caso de diabetes es peor que una falsa alarma, puedes bajarlo. Con un umbral de 0.3 sobre el mismo conjunto de test, la matriz de confusión es:
         Observed
Predicted  No Yes
      No  173  27
      Yes  50  82
La sensibilidad sube al \(82 / 109 = 75.2\%\) a costa de más falsos positivos (la especificidad baja al \(173 / 223 = 77.6\%\)). El mejor umbral depende del coste de cada tipo de error en tu problema.
Comparar modelos anidados con anova
Para decidir si añadir variables mejora el modelo, compara dos modelos anidados (el pequeño contiene un subconjunto de las variables del grande) con anova y test = "Chisq". Es el contraste de razón de verosimilitudes, que compara las deviances residuales:
fit_glu <- glm(type ~ glu, data = df, family = binomial)

anova(fit_glu, fit, test = "Chisq")
Analysis of Deviance Table
Model 1: type ~ glu
Model 2: type ~ glu + bmi + age
Resid. Df Resid. Dev Df Deviance Pr(>Chi)
1 198 207.37
2 196 188.39 2 18.98 7.561e-05 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Añadir bmi y age reduce la deviance en 18.98 con 2 grados de libertad, y el p-valor (7.561e-05) indica que el modelo grande es significativamente mejor. A diferencia del ANOVA de un modelo lineal, aquí el contraste utiliza la distribución chi-cuadrado en lugar de la distribución F. En versiones de R anteriores a la 4.4.0, anova muestra las deviances pero no el p-valor si no añades test = "Chisq", así que es buena costumbre escribirlo siempre.
Si los modelos no están anidados, compara su AIC. Cuanto menor, mejor:
fit_full <- glm(type ~ glu + bmi + age + ped + npreg, data = df, family = binomial)

AIC(fit_glu, fit, fit_full)
df AIC
fit_glu 2 211.3727
fit 4 196.3929
fit_full 6 190.4705Añadir la función de pedigrí de diabetes (ped) y el número de embarazos (npreg) vuelve a bajar el AIC, así que también merece la pena incluirlas.
Aviso: fitted probabilities numerically 0 or 1 occurred
Este aviso aparece cuando el modelo predice probabilidades extremadamente cercanas a 0 o a 1 para algunas observaciones. La causa más habitual es la separación: una variable (o una combinación de variables) separa perfectamente las dos clases, de modo que el estimador de máxima verosimilitud no existe y los coeficientes tienden a infinito. Mira este pequeño ejemplo, en el que todas las observaciones con x mayor que 5 valen 1:
dd <- data.frame(x = 1:10, y = c(0, 0, 0, 0, 0, 1, 1, 1, 1, 1))

sep <- glm(y ~ x, data = dd, family = binomial)
summary(sep)
Warning messages:
1: glm.fit: algorithm did not converge
2: glm.fit: fitted probabilities numerically 0 or 1 occurred
Call:
glm(formula = y ~ x, family = binomial, data = dd)
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) -245.8 337834.2 -0.001 0.999
x 44.7 61172.1 0.001 0.999
(Dispersion parameter for binomial family taken to be 1)
Null deviance: 1.3863e+01 on 9 degrees of freedom
Residual deviance: 7.8648e-10 on 8 degrees of freedom
AIC: 4
Number of Fisher Scoring iterations: 25Los síntomas de la separación son fáciles de reconocer: coeficientes y errores estándar enormes, p-valores cercanos a 1, una deviance residual casi nula y muchas iteraciones. Aunque x predice y a la perfección, el p-valor dice que no es significativa, así que estos resultados no se pueden interpretar.
Qué hacer depende de la causa:
- Comprueba si alguna variable es en realidad otra versión de la respuesta (por ejemplo, una variable creada a partir de ella). Es una fuga de información y tienes que eliminar la variable.
- Revisa la tabla cruzada de la respuesta con las variables categóricas. Una categoría con solo ceros o solo unos produce separación; agrupar categorías suele resolverlo.
- Si la separación es real y necesitas el modelo, utiliza una regresión logística penalizada, como el método de Firth (paquete
logistf).
El aviso también puede aparecer sin separación cuando unas pocas observaciones son muy extremas. En ese caso los coeficientes son razonables y el modelo es válido, pero conviene revisar esas observaciones.