Test de correlación en R con cor.test()
La función cor.test contrasta si la correlación entre dos variables numéricas es significativamente distinta de cero. Calcula el coeficiente de Pearson, Spearman o Kendall junto con un p-valor y, en el caso de Pearson, un intervalo de confianza. En este tutorial aprenderás a realizar los tres contrastes, a leer cada línea de la salida, a elegir el método adecuado, a resolver el aviso “Cannot compute exact p-value with ties” y a contrastar varios pares de variables a la vez.
Hipótesis del test de correlación
La función cor devuelve un coeficiente de correlación, pero ese número se calcula a partir de una muestra. Aunque dos variables no tengan ninguna relación en la población, la correlación muestral casi nunca será exactamente 0. El test de correlación responde a la pregunta: ¿es la correlación de mi muestra lo bastante grande como para concluir que en la población no es cero? Si solo necesitas el coeficiente, consulta el tutorial de covarianza y correlación.
Las hipótesis del contraste bilateral son:
- \(H_0\): la correlación poblacional es cero, \(\rho = 0\) (no hay relación lineal o monótona).
- \(H_1\): la correlación poblacional no es cero, \(\rho \neq 0\).
La sintaxis de la función es la siguiente:
cor.test(x, y,
         alternative = c("two.sided", "less", "greater"),
         method = c("pearson", "kendall", "spearman"),
         exact = NULL, conf.level = 0.95, continuity = FALSE, ...)

# Con una fórmula:
cor.test(formula, data, subset, na.action, ...)
Siendo x e y dos vectores numéricos de la misma longitud, alternative la hipótesis alternativa, method el coeficiente de correlación que quieres contrastar, exact si se calcula un p-valor exacto (solo para Spearman y Kendall) y conf.level el nivel de confianza del intervalo (solo para Pearson).
Test de correlación de Pearson
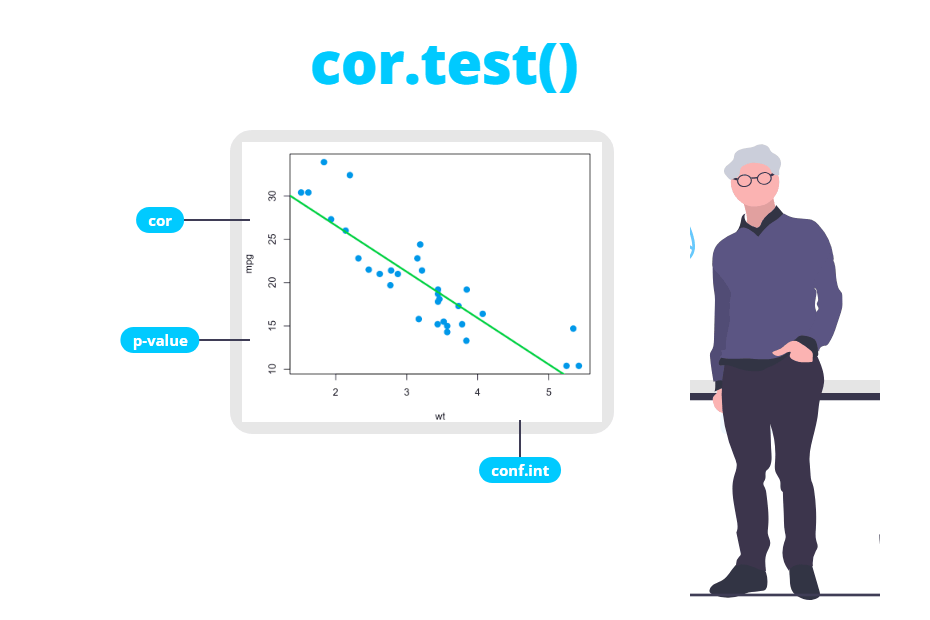
Para este ejemplo vamos a utilizar el conjunto de datos mtcars, que contiene información de 32 coches. La pregunta es si el peso de un coche (wt, en miles de libras) está correlacionado con su consumo (mpg, millas por galón). Por defecto, cor.test utiliza el método de Pearson:
# ¿Es cero la correlación entre el peso y las millas por galón?
cor.test(mtcars$wt, mtcars$mpg)
Pearson's product-moment correlation
data: mtcars$wt and mtcars$mpg
t = -9.559, df = 30, p-value = 1.294e-10
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
-0.9338264 -0.7440872
sample estimates:
cor
-0.8676594Cómo interpretar la salida
Cada línea de la salida significa lo siguiente:
- data: las dos variables que se contrastan.
- t: el estadístico del contraste. En el test de Pearson se calcula como \(t = \frac{r\sqrt{n-2}}{\sqrt{1-r^2}}\). Con \(r = -0.8677\) y \(n = 32\) obtienes \(t = -9.559\). Su signo coincide con el de la correlación.
- df: los grados de libertad, \(n - 2 = 30\). Bajo \(H_0\) el estadístico sigue una distribución t de Student con estos grados de libertad.
- p-value: la probabilidad de observar una correlación al menos así de fuerte (en valor absoluto) si la correlación real fuese 0. Aquí vale \(1.294 \cdot 10^{-10}\), así que puedes rechazar la hipótesis nula: el peso y el consumo están correlacionados.
- alternative hypothesis: te recuerda qué hipótesis se ha contrastado, bilateral en este caso.
- 95 percent confidence interval: los valores plausibles de la correlación poblacional, entre -0.934 y -0.744. Como no contiene el 0, la conclusión es la misma que con el p-valor. El intervalo también te sirve para ver lo precisa que es la estimación.
- sample estimates: el coeficiente de correlación de Pearson, \(r = -0.868\), el mismo valor que devuelve
cor(mtcars$wt, mtcars$mpg).
La conclusión es que existe una correlación fuerte, negativa y significativa entre el peso y las millas por galón: los coches más pesados recorren menos millas con cada galón.
Puedes extraer cada elemento del resultado con $, algo útil si quieres usar los valores en tu código o en un informe. Los elementos disponibles son statistic, parameter, p.value, estimate, null.value, alternative, method, data.name y conf.int:
res <- cor.test(mtcars$wt, mtcars$mpg)

res$estimate
res$p.value
res$conf.int
cor
-0.8676594
[1] 1.293959e-10
[1] -0.9338264 -0.7440872
attr(,"conf.level")
[1] 0.95Si necesitas otro nivel de confianza, utiliza el argumento conf.level, por ejemplo conf.level = 0.99.
Supuestos del test de Pearson
El test de Pearson mide la relación lineal entre dos variables y su p-valor supone que:
- Las observaciones son independientes (cada fila es un coche, una persona, una planta… distinta).
- La relación es lineal. Si es curva, Pearson infravalora su intensidad.
- Las dos variables son aproximadamente normales (en rigor, normales bivariantes). Con muestras grandes el test es bastante robusto frente a este supuesto.
- No hay valores atípicos fuertes, ya que un único punto extremo puede crear o esconder una correlación.
La forma más rápida de comprobar la linealidad y los atípicos es un gráfico de dispersión. Compara la relación de mpg con el peso y con la potencia (hp):
par(mfrow = c(1, 2))

plot(mtcars$wt, mtcars$mpg, pch = 19, col = 4,
     xlab = "Peso (miles de libras)", ylab = "Millas por galón")
plot(mtcars$hp, mtcars$mpg, pch = 19, col = 4,
     xlab = "Potencia (CV)", ylab = "Millas por galón")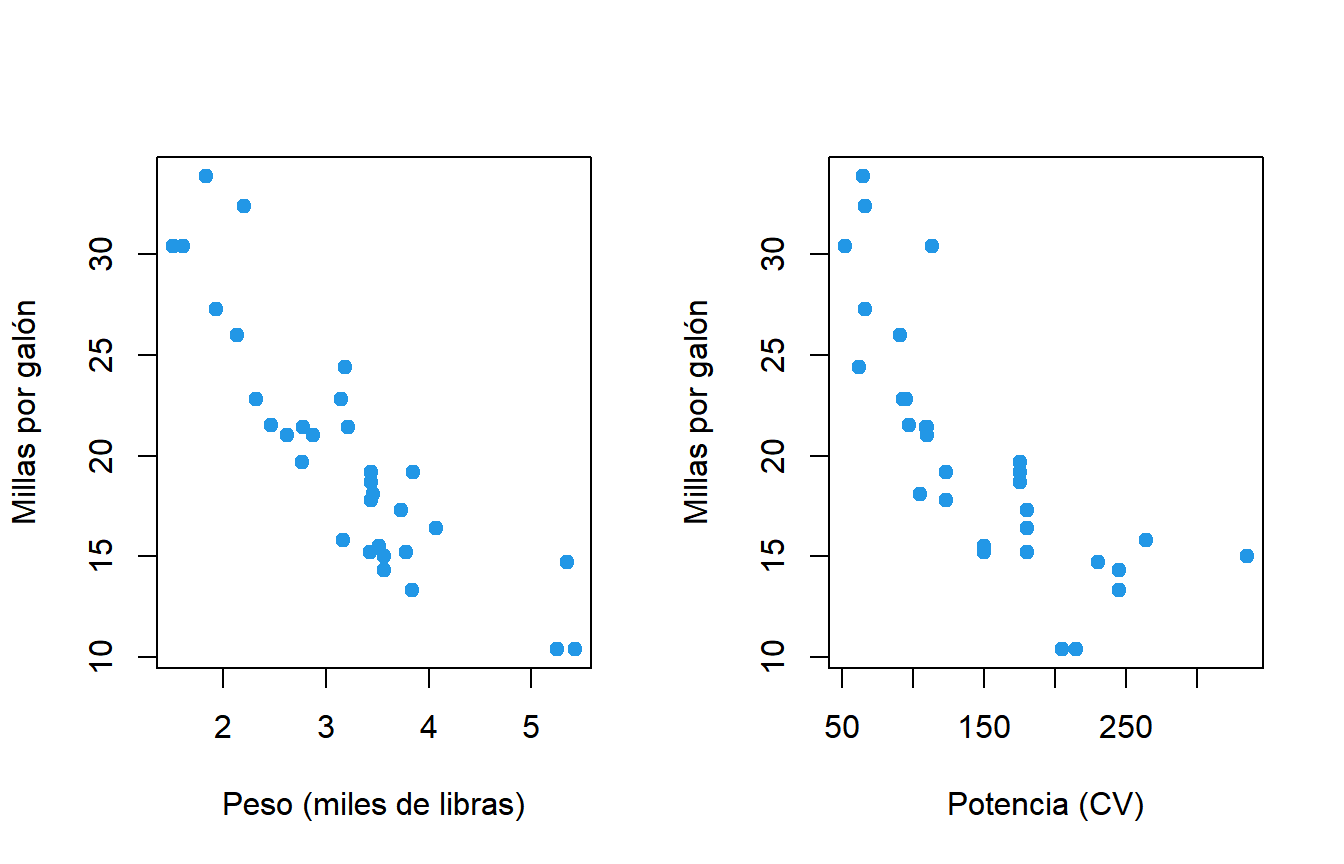
par(mfrow = c(1, 1))La relación con el peso es aproximadamente lineal, pero la relación con la potencia es curva: las millas por galón caen rápido al principio y después se estabilizan. Para comprobar la normalidad puedes aplicar el test de Shapiro-Wilk a cada variable:
shapiro.test(mtcars$wt)
shapiro.test(mtcars$hp)
Shapiro-Wilk normality test
data: mtcars$wt
W = 0.94326, p-value = 0.09265
Shapiro-Wilk normality test
data: mtcars$hp
W = 0.93342, p-value = 0.04881El peso es compatible con la normalidad (p-valor = 0.093), pero la potencia no (p-valor = 0.049) y, además, su relación con mpg no es lineal. Para el par hp y mpg es mejor utilizar un método basado en rangos.
Test de correlación de Spearman y de Kendall
La \(\rho\) de Spearman y la \(\tau\) de Kendall se calculan a partir de los rangos de los datos en lugar de sus valores, por lo que no necesitan normalidad, son robustas frente a atípicos y detectan cualquier relación monótona (siempre creciente o siempre decreciente), no solo las lineales. Para utilizarlas, cambia el argumento method:
# Test de correlación de Spearman
cor.test(mtcars$hp, mtcars$mpg, method = "spearman")
Spearman's rank correlation rho
data: mtcars$hp and mtcars$mpg
S = 10337, p-value = 5.086e-12
alternative hypothesis: true rho is not equal to 0
sample estimates:
rho
-0.8946646
Warning message:
In cor.test.default(mtcars$hp, mtcars$mpg, method = "spearman") :
Cannot compute exact p-value with tiesLa salida se parece a la de Pearson, pero no hay intervalo de confianza y el estadístico ahora es S, que se basa en la suma de las diferencias al cuadrado entre los rangos. El coeficiente de Spearman vale -0.895, más fuerte que el de Pearson para el mismo par (-0.776), porque a Pearson le penaliza la curvatura de la relación.
El test de Kendall funciona igual:
# Test de correlación de Kendall
cor.test(mtcars$hp, mtcars$mpg, method = "kendall", exact = FALSE)
Kendall's rank correlation tau
data: mtcars$hp and mtcars$mpg
z = -5.871, p-value = 4.332e-09
alternative hypothesis: true tau is not equal to 0
sample estimates:
tau
-0.7428125La \(\tau\) de Kendall es la diferencia entre la proporción de pares de observaciones concordantes y discordantes, así que sus valores suelen ser menores en valor absoluto que los de Spearman (aquí -0.743 frente a -0.895). Eso no significa que la relación sea más débil: los dos coeficientes están en escalas distintas y no conviene compararlos directamente. El estadístico z es la aproximación normal que se usa para calcular el p-valor.
El aviso “Cannot compute exact p-value with ties”
Con muestras pequeñas, cor.test intenta calcular un p-valor exacto para Spearman (hasta 1290 observaciones) y para Kendall (menos de 50 observaciones). El cálculo exacto supone que todos los valores son distintos. Cuando hay empates (valores repetidos, algo muy habitual con datos enteros o redondeados como hp), no se puede hacer, así que R recurre a una aproximación y muestra el aviso.
El aviso no es un error y el resultado es válido. Para que no aparezca, indica a R que use la aproximación desde el principio con exact = FALSE:
cor.test(mtcars$hp, mtcars$mpg, method = "spearman", exact = FALSE) Spearman's rank correlation rho
data: mtcars$hp and mtcars$mpg
S = 10337, p-value = 5.086e-12
alternative hypothesis: true rho is not equal to 0
sample estimates:
rho
-0.8946646El p-valor es exactamente el mismo que antes, porque ya se había calculado con la aproximación. Si tienes muchos empates y una muestra pequeña, la \(\tau\) de Kendall los trata mejor que la \(\rho\) de Spearman.
Qué método elegir
| Método | Mide | Úsalo cuando | Argumento |
|---|---|---|---|
| \(r\) de Pearson | Relación lineal | Las dos variables son numéricas, aproximadamente normales, la relación es lineal y no hay atípicos fuertes | method = "pearson" (por defecto) |
| \(\rho\) de Spearman | Relación monótona | Los datos no son normales, la relación es curva pero monótona, hay atípicos o las variables son ordinales | method = "spearman" |
| \(\tau\) de Kendall | Relación monótona (pares concordantes) | Los mismos casos que Spearman, pero con muestras pequeñas o muchos empates | method = "kendall" |
Si Pearson y Spearman dan valores muy distintos, mira el gráfico de dispersión: probablemente hay una relación curva o un atípico que condiciona el resultado.
A diferencia de cor, que devuelve NA cuando hay valores faltantes, cor.test elimina automáticamente los pares incompletos. Por ejemplo, cor.test(airquality$Ozone, airquality$Temp) muestra df = 114, porque solo 116 de las 153 filas tienen los dos valores. Revisa los grados de libertad para saber cuántas observaciones se han usado realmente y consulta el tutorial de valores NA si prefieres tratarlos tú.
Tests de correlación unilaterales
Si antes de ver los datos ya esperabas que la correlación fuese en un sentido concreto, puedes hacer un contraste unilateral con el argumento alternative:
alternative = "greater": \(H_1: \rho > 0\) (correlación positiva).alternative = "less": \(H_1: \rho < 0\) (correlación negativa).
Por ejemplo, es razonable esperar que los coches más pesados recorran menos millas por galón, así que la hipótesis alternativa es una correlación negativa:
cor.test(mtcars$wt, mtcars$mpg, alternative = "less") Pearson's product-moment correlation
data: mtcars$wt and mtcars$mpg
t = -9.559, df = 30, p-value = 6.47e-11
alternative hypothesis: true correlation is less than 0
95 percent confidence interval:
-1.0000000 -0.7690872
sample estimates:
cor
-0.8676594El p-valor es la mitad del bilateral y el intervalo de confianza ahora es unilateral: va de -1 a -0.769. Elige el sentido antes de ver los datos. Si lo eliges después de mirar el signo del coeficiente, el p-valor deja de ser válido.
Significación no es fuerza (y correlación no es causalidad)
El p-valor solo te dice si la correlación es distinta de cero. No te dice si la correlación es fuerte y depende mucho del tamaño de la muestra. En el siguiente ejemplo la correlación real es muy débil, pero la muestra tiene 5000 observaciones:
set.seed(1)
x <- rnorm(5000)
y <- 0.05 * x + rnorm(5000)

cor.test(x, y)
Pearson's product-moment correlation
data: x and y
t = 3.5217, df = 4998, p-value = 0.0004327
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
0.02206331 0.07736478
sample estimates:
cor
0.04975218El contraste es claramente significativo (p-valor = 0.0004), pero \(r = 0.05\) y \(r^2 = 0.0025\): x explica solo el 0.25% de la variabilidad de y. La relación existe, pero en la práctica es despreciable. También ocurre lo contrario: con solo 8 observaciones, un coeficiente de 0.51 no es significativo.
set.seed(1)
x2 <- rnorm(8)
y2 <- 0.6 * x2 + rnorm(8)

cor.test(x2, y2)
Pearson's product-moment correlation
data: x2 and y2
t = 1.457, df = 6, p-value = 0.1954
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
-0.3023781 0.8938808
sample estimates:
cor
0.5112256El intervalo de confianza, de -0.30 a 0.89, muestra que la muestra es demasiado pequeña para concluir nada: la correlación podría ser negativa, nula o muy fuerte. Por eso conviene dar siempre el coeficiente y su intervalo de confianza, no solo el p-valor.
Una correlación significativa no implica causalidad. Los coches más pesados consumen más, pero la correlación por sí sola no te dice si una variable causa la otra, si la relación va en sentido contrario o si una tercera variable (por ejemplo, el tamaño del motor) influye en las dos. Para demostrar causalidad necesitas un experimento controlado o un análisis causal cuidadoso.
Contrastar varios pares: matriz de correlación con p-valores
cor acepta un data frame y devuelve la matriz de correlación completa, pero cor.test solo acepta dos variables. Si quieres el p-valor de cada par, puedes aplicar cor.test a todas las combinaciones de columnas. Con dos llamadas anidadas a sapply obtienes una matriz de p-valores con la misma forma que la matriz de correlación:
# Datos de muestra
df <- mtcars[, c("mpg", "wt", "hp", "qsec")]

# Matriz de p-valores
p <- sapply(df, function(x) sapply(df, function(y) cor.test(x, y)$p.value))
diag(p) <- NA

signif(p, 3)
mpg wt hp qsec
mpg NA 1.29e-10 1.79e-07 1.71e-02
wt 1.29e-10 NA 4.15e-05 3.39e-01
hp 1.79e-07 4.15e-05 NA 5.77e-06
qsec 1.71e-02 3.39e-01 5.77e-06 NALa diagonal se fija a NA porque la correlación de una variable consigo misma siempre vale 1 y no tiene sentido contrastarla. Todos los pares son significativos al 5% salvo wt y qsec (p-valor = 0.339).
Cuando contrastas muchos pares, la probabilidad de obtener al menos un falso positivo aumenta, igual que con las comparaciones múltiples después de un ANOVA. Una alternativa más ordenada es construir una tabla con una fila por par y ajustar los p-valores con p.adjust:
# Datos de muestra
df <- mtcars[, c("mpg", "wt", "hp", "qsec")]

# Todos los pares de variables
pares <- combn(names(df), 2)

res <- data.frame(var1 = pares[1, ], var2 = pares[2, ])
tests <- lapply(seq_len(ncol(pares)), function(k) {
  cor.test(df[[pares[1, k]]], df[[pares[2, k]]])
})
res$r <- sapply(tests, function(t) t$estimate)
res$p_valor <- sapply(tests, function(t) t$p.value)
res$p_ajust <- p.adjust(res$p_valor, method = "holm")

res
var1 var2 r p_valor p_ajust
1 mpg wt -0.8676594 1.293959e-10 7.763752e-10
2 mpg hp -0.7761684 1.787835e-07 8.939176e-07
3 mpg qsec 0.4186840 1.708199e-02 3.416398e-02
4 wt hp 0.6587479 4.145827e-05 1.243748e-04
5 wt qsec -0.1747159 3.388683e-01 3.388683e-01
6 hp qsec -0.7082234 5.766253e-06 2.306501e-05combn crea los 6 pares posibles de las 4 variables, lapply realiza un contraste por par y el ajuste de Holm aumenta cada p-valor para tener en cuenta los 6 contrastes. Después del ajuste, el par mpg y qsec sigue siendo significativo (0.034). Si quieres visualizar la matriz, consulta el tutorial de gráficos de correlación.
Uso con fórmula
cor.test también admite una fórmula. A diferencia de la mayoría de contrastes, las dos variables van a la derecha de la fórmula, separadas por +, y el lado izquierdo queda vacío:
cor.test(~ wt + mpg, data = mtcars) Pearson's product-moment correlation
data: wt and mpg
t = -9.559, df = 30, p-value = 1.294e-10
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
-0.9338264 -0.7440872
sample estimates:
cor
-0.8676594El resultado es el mismo que antes. La ventaja de la fórmula es el argumento subset, que te permite hacer el contraste sobre una parte de los datos sin crear un nuevo data frame. Por ejemplo, solo para los coches con cambio manual (am == 1):
cor.test(~ wt + mpg, data = mtcars, subset = am == 1) Pearson's product-moment correlation
data: wt and mpg
t = -7.2294, df = 11, p-value = 1.688e-05
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
-0.9727488 -0.7170043
sample estimates:
cor
-0.9089148Un error habitual es escribir cor.test(mpg ~ wt, data = mtcars), con una variable respuesta a la izquierda, que devuelve el error 'formula' missing or invalid. Por último, recuerda que las dos variables tienen que ser numéricas: si pasas un factor obtendrás el error 'x' must be a numeric vector.