Distribución F en R
La distribución F de Snedecor es la que está detrás del ANOVA, del test F para comparar dos varianzas y del contraste global de un modelo de regresión. En este tutorial aprenderás a usar las funciones df, pf, qf y rf en R, a calcular un p-valor a partir del estadístico F, a obtener valores críticos de la F y a entender por qué el cuadrado de un estadístico t sigue una distribución F, comprobando cada resultado con la salida de aov y var.test.
La distribución F
Si \(U\) y \(V\) son dos variables aleatorias chi-cuadrado independientes con \(d_1\) y \(d_2\) grados de libertad, el cociente entre ambas, divididas por sus grados de libertad,
\[F = \frac{U / d_1}{V / d_2}\]
sigue una distribución F (o de Fisher-Snedecor) con \(d_1\) y \(d_2\) grados de libertad (gl), lo que se denota como \(F \sim F_{d_1, d_2}\). A diferencia de la t o de la chi-cuadrado, la F tiene dos parámetros: \(d_1\) son los grados de libertad del numerador y \(d_2\) los del denominador.
En la práctica, un estadístico F es casi siempre un cociente de dos varianzas. En el ANOVA es la varianza entre grupos dividida por la varianza dentro de los grupos, y en el test F es la varianza de una muestra dividida por la de la otra. Si las dos varianzas estiman lo mismo, el cociente debería estar cerca de 1.
Sea \(X \sim F_{d_1, d_2}\):
- Solo toma valores no negativos, ya que es un cociente de sumas de cuadrados.
- Es asimétrica a la derecha, y la asimetría disminuye al aumentar los dos grados de libertad.
- La esperanza es \(E(X) = \frac{d_2}{d_2 - 2}\) (si \(d_2 > 2\)), que solo depende del denominador y siempre es mayor que 1.
- La varianza es \(Var(X) = \frac{2 d_2^2 (d_1 + d_2 - 2)}{d_1 (d_2 - 2)^2 (d_2 - 4)}\) (si \(d_2 > 4\)).
- Si \(X \sim F_{d_1, d_2}\), entonces \(1/X \sim F_{d_2, d_1}\), y si \(T \sim t_{\nu}\), entonces \(T^2 \sim F_{1, \nu}\).
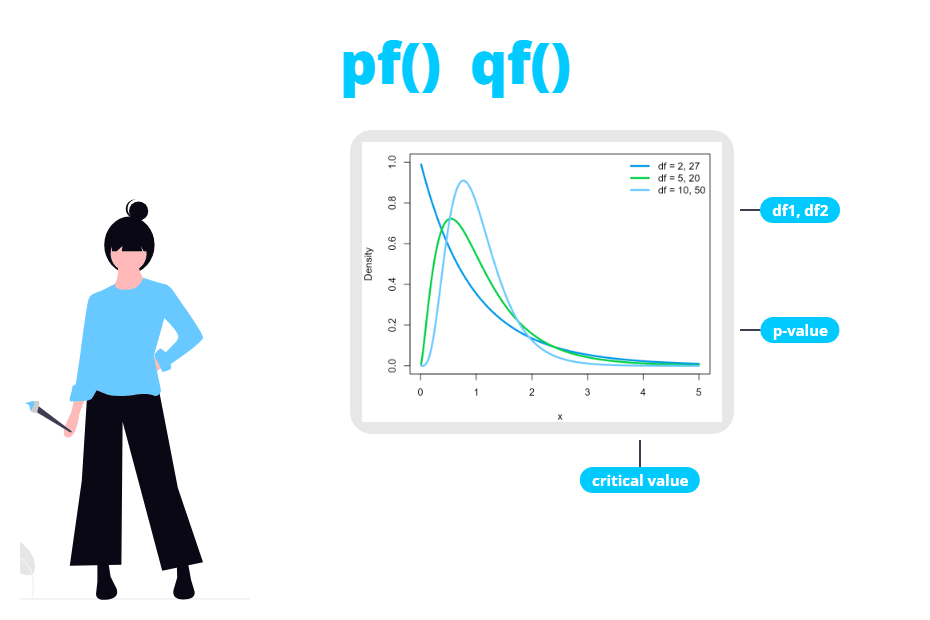
En R tienes cuatro funciones para la distribución F, con la misma lógica de nombres que las funciones de la distribución normal:
| Función | Descripción | Uso habitual |
|---|---|---|
| df | Densidad F (Función de densidad de probabilidad) |
Dibujar la curva |
| pf | Distribución F (Función de distribución acumulada) |
p-valores |
| qf | Función cuantil de la distribución F | Valores críticos |
| rf | Generación de números pseudoaleatorios F |
Simulación |
Los argumentos se llaman df1 y df2 y ninguno tiene valor por defecto. El orden importa: df1 es siempre el numerador y df2 el denominador. Por ejemplo, qf(0.95, 2, 27) vale 3.35, pero qf(0.95, 27, 2) vale 19.46.
La función df
La función df devuelve la densidad de la distribución F para un vector de valores x. Su sintaxis es la siguiente:
df(x,           # Vector de valores (cuantiles)
   df1,         # Grados de libertad del numerador
   df2,         # Grados de libertad del denominador
   ncp,         # Parámetro de no centralidad (opcional)
   log = FALSE) # Si es TRUE, las densidades se devuelven en logaritmo
Por ejemplo, la densidad de una F con 5 y 10 grados de libertad en 0.5, 1 y 2 es:
df(c(0.5, 1, 2), df1 = 5, df2 = 10)[1] 0.6876070 0.4954798 0.1620057Como en cualquier distribución continua, estos valores no son probabilidades, sino la altura de la curva. Usarás df sobre todo para dibujar la distribución.
Dibujar la distribución F en R
En el siguiente gráfico tienes la densidad F para varias combinaciones de grados de libertad. La rejilla de valores del eje X la puedes crear con seq:
# Rejilla de valores del eje X
x <- seq(0, 4, length = 400)

plot(x, df(x, df1 = 1, df2 = 10), type = "l", lwd = 2, col = "red",
     ylab = "Densidad", xlab = "x", ylim = c(0, 1.5))
lines(x, df(x, df1 = 5, df2 = 10), lwd = 2, col = "orange")
lines(x, df(x, df1 = 10, df2 = 30), lwd = 2, col = "blue")
lines(x, df(x, df1 = 50, df2 = 50), lwd = 2, col = "darkgreen")

legend("topright", legend = c("gl1 = 1, gl2 = 10", "gl1 = 5, gl2 = 10",
                              "gl1 = 10, gl2 = 30", "gl1 = 50, gl2 = 50"),
       col = c("red", "orange", "blue", "darkgreen"), lwd = 2, box.lty = 0)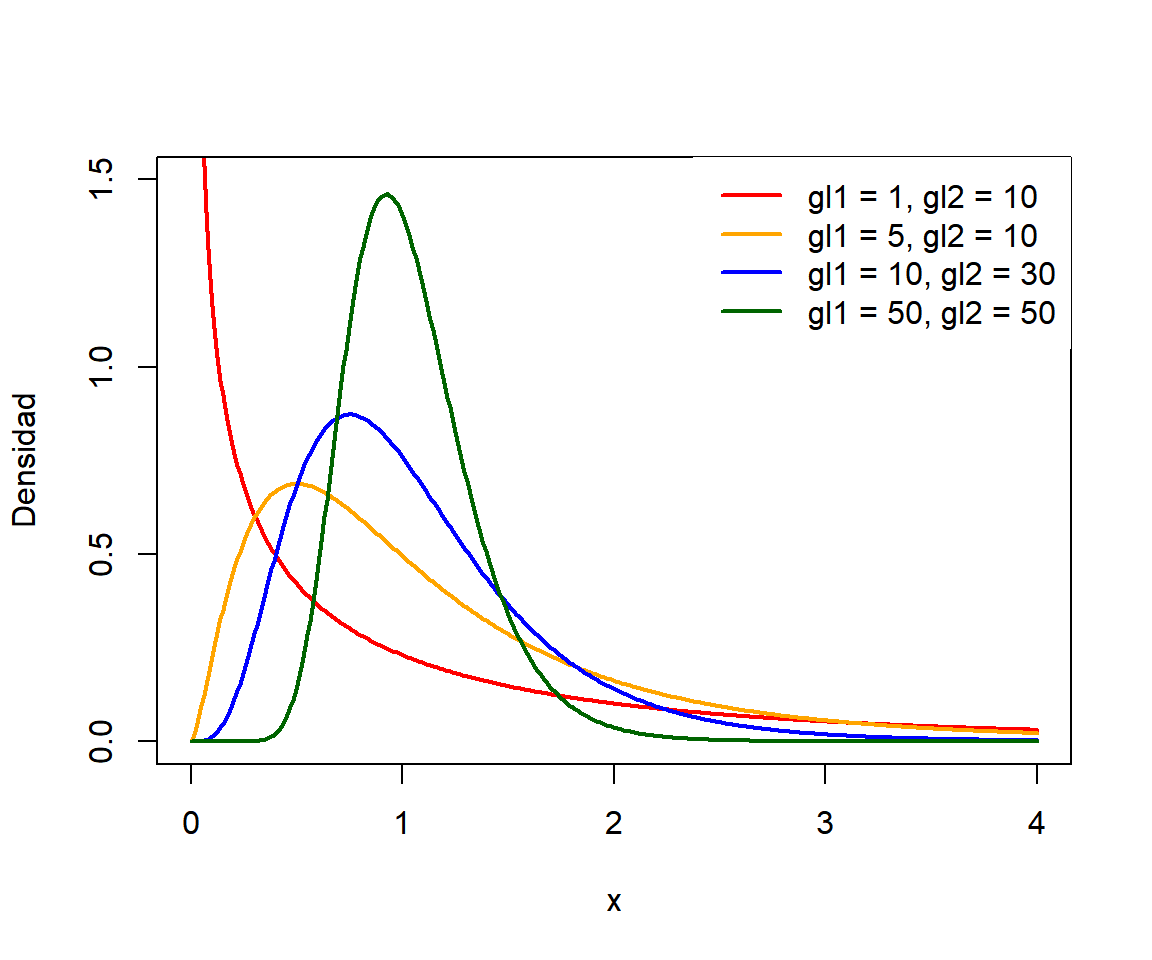
Con \(d_1 = 1\) (y también con \(d_1 = 2\)) la densidad es decreciente, con el máximo en 0. Con más grados de libertad la curva tiene un pico por debajo de 1 y, a medida que crecen los dos grados de libertad, se concentra alrededor del 1: con muestras grandes, el cociente de dos estimaciones de la misma varianza rara vez se aleja mucho de 1.
df como nombre de un data frame
Muchos tutoriales (incluidos algunos de esta web, como el de ANOVA en R) guardan los datos en un objeto llamado df. Eso no rompe la función de densidad: cuando llamas a df(...), R busca un objeto llamado df que sea una función y se salta tu data frame.
df <- PlantGrowth

class(df)
df(1, df1 = 2, df2 = 27) # Sigue siendo la densidad F
[1] "data.frame"
[1] 0.3548163El problema aparece en el caso contrario. Si te olvidas de crear el data frame (o empiezas una sesión nueva) y ejecutas df$weight, R encuentra la función df y devuelve este error tan confuso:
Error in df$weight : object of type 'closure' is not subsettable“Closure” significa “función”: estás intentando extraer un elemento de la función df. Crea antes el data frame o, mejor aún, ponle un nombre más descriptivo.
La función pf
La función pf devuelve la función de distribución acumulada de la F, es decir, la probabilidad \(P(X \leq q)\). Con lower.tail = FALSE obtienes la cola superior, \(P(X > q)\), que es la que necesitas para los p-valores.
pf(q,                 # Vector de cuantiles
   df1,               # Grados de libertad del numerador
   df2,               # Grados de libertad del denominador
   ncp,               # Parámetro de no centralidad (opcional)
   lower.tail = TRUE, # Si es TRUE, P(X <= q); si no, P(X > q)
   log.p = FALSE)     # Si es TRUE, las probabilidades se devuelven en logaritmo
Como ejemplo, la probabilidad de que una F con 5 y 10 grados de libertad tome un valor menor que 2 y mayor que 2 es:
pf(2, df1 = 5, df2 = 10)                     # P(X <= 2)
pf(2, df1 = 5, df2 = 10, lower.tail = FALSE) # P(X > 2)
1 - pf(2, df1 = 5, df2 = 10)                 # Equivalente
[1] 0.835805
[1] 0.164195
[1] 0.164195p-valor a partir del estadístico F
Este es el uso más habitual de pf. Considera el ANOVA de un factor del conjunto de datos PlantGrowth, que compara el peso seco de las plantas en tres grupos (un control y dos tratamientos, con 10 plantas cada uno):
fit <- aov(weight ~ group, data = PlantGrowth)
summary(fit)
Df Sum Sq Mean Sq F value Pr(>F)
group 2 3.766 1.8832 4.846 0.0159 *
Residuals 27 10.492 0.3886
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1El valor F es el cociente de las dos medias cuadráticas, \(1.8832 / 0.3886 = 4.846\), y los grados de libertad están en la columna Df: 2 en el numerador (número de grupos menos 1) y 27 en el denominador (observaciones menos número de grupos). El p-valor de Pr(>F) es la probabilidad de obtener un valor F mayor que el observado, así que puedes reproducirlo con pf y lower.tail = FALSE:
# Estadístico F exacto de la tabla ANOVA
F_stat <- summary(fit)[[1]][1, "F value"]
F_stat

# p-valor: cola superior
pf(F_stat, df1 = 2, df2 = 27, lower.tail = FALSE)
[1] 4.846088
[1] 0.01590996El resultado es el 0.0159 de la tabla. En el ANOVA el p-valor es siempre la cola superior: los valores F pequeños (cercanos a 0 o a 1) indican que las medias de los grupos son parecidas, así que solo los valores grandes son evidencia en contra de la hipótesis nula. Si escribes pf(F_stat, 2, 27) sin lower.tail = FALSE obtendrás 0.984, que es el complementario del p-valor.
Si copias el valor F redondeado de la tabla impresa (pf(4.846, 2, 27, lower.tail = FALSE)) obtendrás 0.01591099 en lugar de 0.01590996. La diferencia no cambia ninguna decisión, pero si quieres que coincida exactamente con la salida, extrae el estadístico del objeto, como en el código anterior.
Lo mismo vale para el estadístico F que aparece al final de summary(lm(...)) y para el test de Levene, que también es un ANOVA (sobre las desviaciones absolutas respecto a la mediana de cada grupo).
p-valor del test F para dos varianzas
El test F compara las varianzas de dos muestras con el estadístico \(F = s_1^2 / s_2^2\), con \(n_1 - 1\) y \(n_2 - 1\) grados de libertad. Por ejemplo, puedes comparar las varianzas de los dos grupos tratados de PlantGrowth:
x <- PlantGrowth$weight[PlantGrowth$group == "trt1"]
y <- PlantGrowth$weight[PlantGrowth$group == "trt2"]

var.test(x, y)
F test to compare two variances
data: x and y
F = 3.216, num df = 9, denom df = 9, p-value = 0.0968
alternative hypothesis: true ratio of variances is not equal to 1
95 percent confidence interval:
0.7988084 12.9475894
sample estimates:
ratio of variances
3.215998Aquí el contraste es bilateral por defecto, así que necesitas las dos colas. Como la distribución F no es simétrica, no puedes usar abs() como con la t. La forma más segura es duplicar la menor de las dos colas:
F_stat <- var(x) / var(y)
F_stat

# p-valor bilateral
2 * min(pf(F_stat, 9, 9), pf(F_stat, 9, 9, lower.tail = FALSE))
[1] 3.215998
[1] 0.09680353El p-valor coincide con el de var.test (0.0968), así que con un nivel de significación de 0.05 no hay evidencia suficiente para decir que las varianzas son distintas, aunque la varianza de trt1 sea más del triple que la de trt2. Con 10 observaciones por grupo el test F tiene poca potencia.
No uses 2 * pf(F_stat, df1, df2, lower.tail = FALSE) sin comprobar cuál es la cola más pequeña. Solo funciona cuando el estadístico F es mayor que 1. Si intercambias las muestras, var.test(y, x) da F = 0.311 y el mismo p-valor, 0.0968, pero 2 * pf(0.311, 9, 9, lower.tail = FALSE) devuelve 1.903, que no es una probabilidad válida.
La función qf
La función qf es la inversa de pf: dada una probabilidad \(p\), devuelve el valor \(q\) tal que \(P(X \leq q) = p\). La usarás para obtener valores críticos.
qf(p,                 # Vector de probabilidades
   df1,               # Grados de libertad del numerador
   df2,               # Grados de libertad del denominador
   ncp,               # Parámetro de no centralidad (opcional)
   lower.tail = TRUE, # Si es TRUE, P(X <= x); si no, P(X > x)
   log.p = FALSE)     # Si es TRUE, las probabilidades se dan en logaritmo
Valores críticos de la F
En el ANOVA rechazas la hipótesis nula cuando el estadístico F es mayor que el valor crítico que deja \(\alpha\) en la cola superior. Para \(\alpha = 0.05\) y los grados de libertad del ejemplo anterior (2 y 27):
qf(0.95, df1 = 2, df2 = 27)
qf(0.05, df1 = 2, df2 = 27, lower.tail = FALSE) # Equivalente
[1] 3.354131
[1] 3.354131Como \(F = 4.846 > 3.354\), rechazas \(H_0\), lo que concuerda con el p-valor de 0.0159. Fíjate en que el ANOVA es unilateral, así que se usa qf(0.95, ...) y no qf(0.975, ...), aunque la hipótesis alternativa (“al menos una media es distinta”) no tenga dirección.
En un test F bilateral de varianzas necesitas dos valores críticos, uno en cada cola. Con 9 y 9 grados de libertad y \(\alpha = 0.05\):
qf(c(0.025, 0.975), df1 = 9, df2 = 9)[1] 0.2483859 4.0259942El estadístico de la sección anterior (3.216) queda entre los dos valores, así que no rechazas la igualdad de varianzas. El valor crítico inferior es el inverso del superior con los grados de libertad intercambiados: 1 / qf(0.975, 9, 9) también devuelve 0.2483859.
También puedes crear tu propia tabla de valores críticos de la F con sapply. El siguiente código devuelve los valores críticos para \(\alpha = 0.05\) con varios grados de libertad del numerador (columnas) y del denominador (filas):
d1 <- c(1, 2, 3, 4, 5, 10)
d2 <- c(5, 10, 20, 30, 60, 120, Inf)

# Valores críticos para alpha = 0.05
crit <- sapply(d1, function(a) qf(0.95, df1 = a, df2 = d2))
dimnames(crit) <- list(df2 = d2, df1 = d1)
round(crit, 3)
df1
df2 1 2 3 4 5 10
5 6.608 5.786 5.409 5.192 5.050 4.735
10 4.965 4.103 3.708 3.478 3.326 2.978
20 4.351 3.493 3.098 2.866 2.711 2.348
30 4.171 3.316 2.922 2.690 2.534 2.165
60 4.001 3.150 2.758 2.525 2.368 1.993
120 3.920 3.072 2.680 2.447 2.290 1.910
Inf 3.841 2.996 2.605 2.372 2.214 1.831Los valores críticos disminuyen al aumentar los grados de libertad. La primera columna es especialmente interesante: con df2 = Inf obtienes 3.841, que es el cuadrado de 1.96, el valor crítico de la normal. No es casualidad, como verás en la siguiente sección.
Relación entre la distribución t y la F
Si \(T\) sigue una distribución t con \(\nu\) grados de libertad, entonces \(T^2\) sigue una distribución F con 1 y \(\nu\) grados de libertad. Por eso el cuadrado del valor crítico bilateral de la t es el valor crítico de la F:
qt(0.975, df = 27)^2
qf(0.95, df1 = 1, df2 = 27)
[1] 4.210008
[1] 4.210008Y el p-valor bilateral de un estadístico t es el p-valor de la cola superior de su cuadrado. Por ejemplo, para \(t = 2.1\) con 27 grados de libertad:
t_stat <- 2.1

2 * pt(-abs(t_stat), df = 27)
pf(t_stat^2, df1 = 1, df2 = 27, lower.tail = FALSE)
[1] 0.04520873
[1] 0.04520873Esto explica por qué un t-test con varianzas iguales y un ANOVA con dos grupos dan exactamente el mismo p-valor. Con el conjunto de datos ToothGrowth, que tiene dos tipos de suplemento:
tt <- t.test(len ~ supp, data = ToothGrowth, var.equal = TRUE)
tt$statistic^2
tt$p.value

summary(aov(len ~ supp, data = ToothGrowth))
t
3.668253
[1] 0.06039337
Df Sum Sq Mean Sq F value Pr(>F)
supp 1 205 205.35 3.668 0.0604 .
Residuals 58 3247 55.98
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1El estadístico t al cuadrado es el valor F del ANOVA (3.668) y los dos p-valores valen 0.0604. La única diferencia es que el t-test también permite alternativas unilaterales, mientras que el test F solo mira el tamaño de la diferencia, no su signo.
La función rf
La función rf genera valores aleatorios de una distribución F. Como con cualquier función de generación aleatoria, fija una semilla para que los resultados sean reproducibles:
rf(n,   # Número de observaciones a generar
   df1, # Grados de libertad del numerador
   df2, # Grados de libertad del denominador
   ncp) # Parámetro de no centralidad (opcional)
set.seed(1)
rf(5, df1 = 5, df2 = 10)[1] 0.3122938 1.5506509 1.7055359 1.4951191 0.6280872La simulación es una buena forma de comprobar la definición de la distribución. Puedes generar valores F directamente con rf o construirlos como un cociente de variables chi-cuadrado divididas por sus grados de libertad con rchisq. En los dos casos la media debería estar cerca de \(10 / (10 - 2) = 1.25\) y el cuantil 95% cerca de qf(0.95, 5, 10):
# Directamente con rf
set.seed(1)
f1 <- rf(100000, df1 = 5, df2 = 10)

# Como cociente de chi-cuadrado
set.seed(1)
f2 <- (rchisq(100000, df = 5) / 5) / (rchisq(100000, df = 10) / 10)

mean(f1)
mean(f2)
quantile(f1, 0.95)
quantile(f2, 0.95)
qf(0.95, df1 = 5, df2 = 10)
[1] 1.251399
[1] 1.248321
95%
3.31972
95%
3.31121
[1] 3.325835Los valores simulados concuerdan con la teoría. En el siguiente gráfico se compara el histograma de 10000 cocientes simulados con la densidad de la \(F_{5, 10}\):
set.seed(1)
f_sim <- (rchisq(10000, df = 5) / 5) / (rchisq(10000, df = 10) / 10)

hist(f_sim, breaks = 100, freq = FALSE, xlim = c(0, 6),
     main = "", xlab = "F", ylab = "Densidad", col = "lightgray", border = "white")
curve(df(x, df1 = 5, df2 = 10), from = 0, to = 6, n = 400,
      lwd = 2, col = "red", add = TRUE)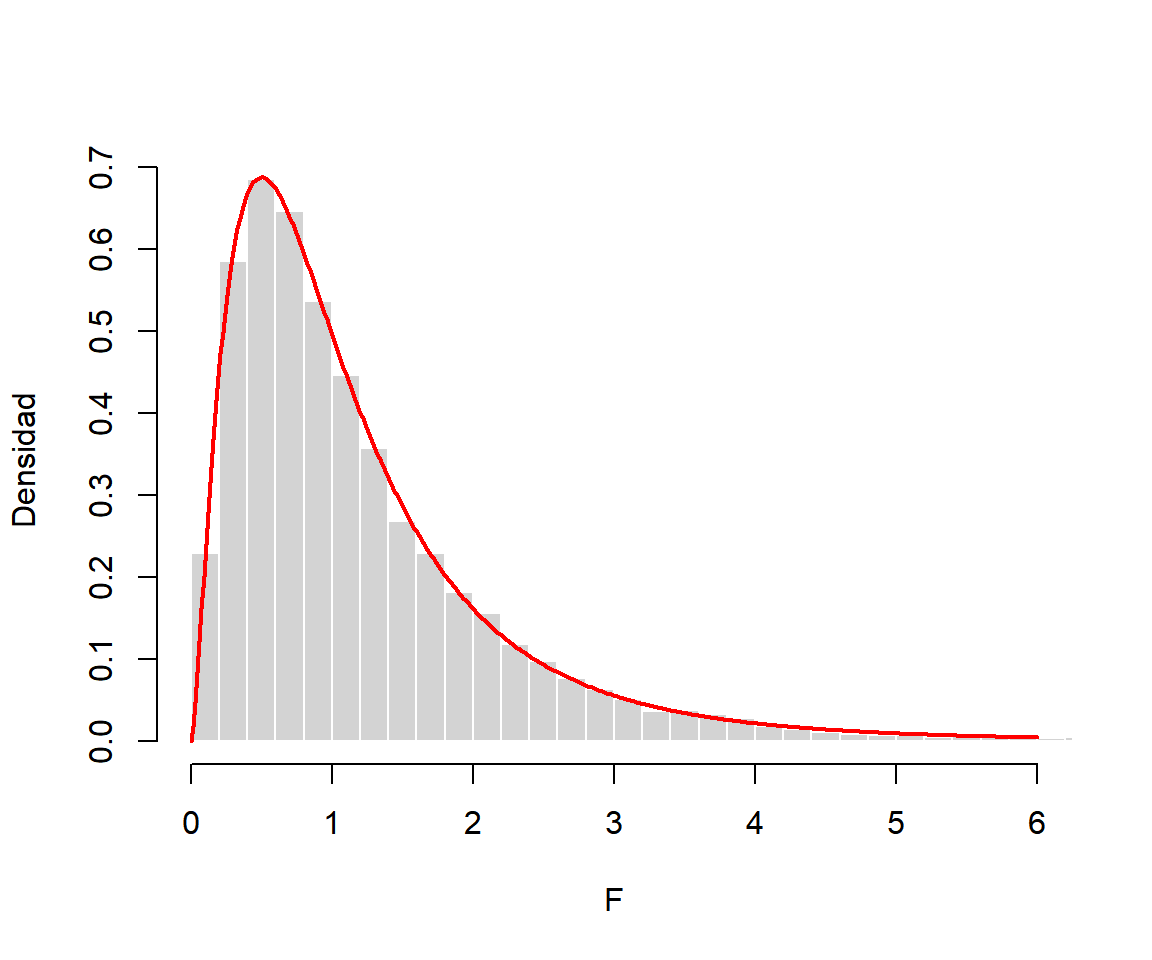
Un uso típico de rf y de este tipo de simulaciones es comprobar el error de tipo I de un procedimiento: si calculas la proporción de valores simulados por encima de qf(0.95, 5, 10) obtendrás un valor cercano a 0.05 (0.0496 con los 10000 valores anteriores).