Unir data frames en R con dplyr: left_join, inner_join, anti_join y más
dplyr ofrece una familia de funciones *_join para combinar dos data frames a partir de una o varias columnas clave. Los joins de mutación (inner_join, left_join, right_join y full_join) añaden columnas de una tabla a la otra, mientras que los joins de filtrado (semi_join y anti_join) solo conservan o descartan filas. En este tutorial aprenderás qué join elegir en cada caso, cómo unir tablas cuyas claves tienen nombres distintos y cómo resolver los problemas más habituales: claves duplicadas, el aviso “many-to-many”, filas de más y valores NA después del join.
Datos de ejemplo
En este tutorial utilizaremos dos data frames pequeños: una tabla de clientes y una tabla de pedidos. Ambas comparten la columna id, que identifica al cliente. Fíjate en que no todas las claves coinciden: David (id = 4) no tiene pedidos y el pedido 105 pertenece a un cliente (id = 5) que no está en la tabla de clientes. Además, Ana tiene dos pedidos.
library(dplyr)

clientes <- data.frame(id = c(1, 2, 3, 4),
                       nombre = c("Ana", "Ben", "Carla", "David"),
                       ciudad = c("Madrid", "Londres", "París", "Roma"))

pedidos <- data.frame(pedido_id = c(101, 102, 103, 104, 105),
                      id = c(1, 1, 2, 3, 5),
                      importe = c(50, 20, 35, 80, 15))

clientes
pedidos
id nombre ciudad
1 1 Ana Madrid
2 2 Ben Londres
3 3 Carla París
4 4 David Roma
pedido_id id importe
1 101 1 50
2 102 1 20
3 103 2 35
4 104 3 80
5 105 5 15Todas las funciones de join comparten la misma sintaxis básica: el primer data frame (x), el segundo (y) y las columnas clave, que se indican en el argumento by. También funcionan con el operador pipe, de modo que clientes %>% left_join(pedidos, by = "id") equivale a left_join(clientes, pedidos, by = "id").
left_join(x, y, by = NULL, suffix = c(".x", ".y"), ..., relationship = NULL)Indica siempre el argumento by. Si lo omites, dplyr une por todas las columnas que tengan el mismo nombre en ambas tablas y muestra un mensaje como Joining with by = join_by(id). Es cómodo para explorar, pero puede unir sin avisar por columnas que no esperabas.
Joins de mutación
Los joins de mutación combinan las columnas de los dos data frames. La diferencia entre ellos está en qué filas se conservan cuando una clave no tiene pareja en la otra tabla.
inner_join
inner_join conserva solo las filas cuya clave existe en las dos tablas. David (sin pedidos) y el pedido 105 (cliente desconocido) desaparecen.
inner_join(clientes, pedidos, by = "id") id nombre ciudad pedido_id importe
1 1 Ana Madrid 101 50
2 1 Ana Madrid 102 20
3 2 Ben Londres 103 35
4 3 Carla París 104 80left_join
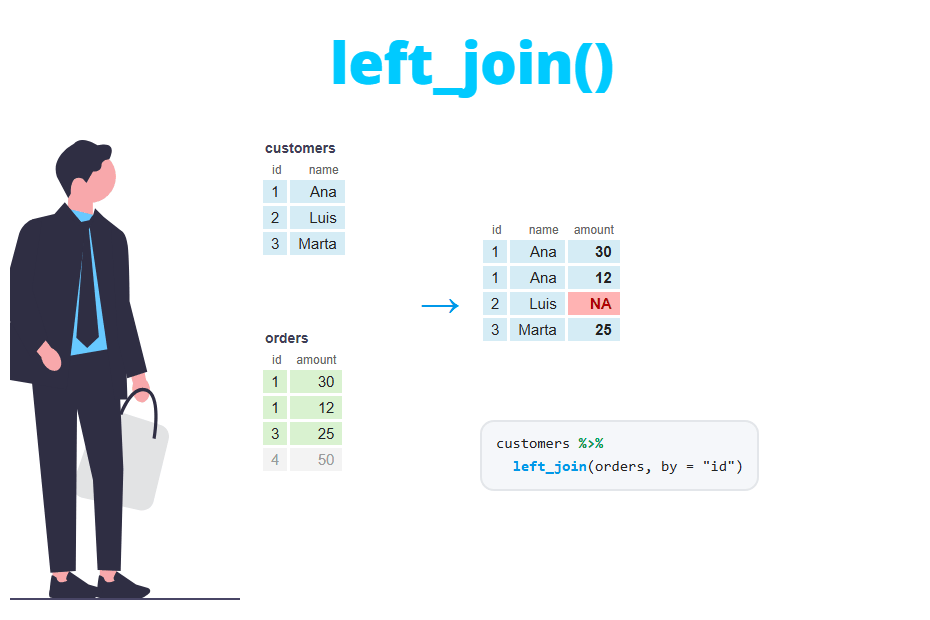
left_join es el join más utilizado. Conserva todas las filas de la primera tabla (x) y le añade la información correspondiente de la segunda (y). Cuando una fila de x no tiene pareja, las columnas nuevas se rellenan con NA, como ocurre con David.
left_join(clientes, pedidos, by = "id") id nombre ciudad pedido_id importe
1 1 Ana Madrid 101 50
2 1 Ana Madrid 102 20
3 2 Ben Londres 103 35
4 3 Carla París 104 80
5 4 David Roma NA NAright_join
right_join hace lo contrario: conserva todas las filas de la segunda tabla (y). Aquí se mantiene el pedido 105, pero su nombre y su ciudad son NA porque el cliente 5 no existe en clientes.
right_join(clientes, pedidos, by = "id") id nombre ciudad pedido_id importe
1 1 Ana Madrid 101 50
2 1 Ana Madrid 102 20
3 2 Ben Londres 103 35
4 3 Carla París 104 80
5 5 <NA> <NA> 105 15En la práctica, right_join(x, y) devuelve las mismas filas que left_join(y, x), solo que con las columnas en otro orden. Por eso mucha gente usa siempre left_join y simplemente cambia el orden de las tablas.
full_join
full_join conserva todas las filas de ambas tablas. Las filas sin pareja en cualquiera de los dos lados reciben NA en las columnas que proceden de la otra tabla.
full_join(clientes, pedidos, by = "id") id nombre ciudad pedido_id importe
1 1 Ana Madrid 101 50
2 1 Ana Madrid 102 20
3 2 Ben Londres 103 35
4 3 Carla París 104 80
5 4 David Roma NA NA
6 5 <NA> <NA> 105 15Joins de filtrado
Los joins de filtrado no añaden ninguna columna. Solo usan la segunda tabla para decidir qué filas de la primera se quedan, como un filtro basado en otro data frame. Además, nunca duplican filas.
semi_join
semi_join conserva las filas de x que tienen pareja en y. El siguiente código devuelve los clientes que han hecho al menos un pedido. Observa que Ana aparece una sola vez, aunque tenga dos pedidos.
semi_join(clientes, pedidos, by = "id") id nombre ciudad
1 1 Ana Madrid
2 2 Ben Londres
3 3 Carla Parísanti_join
anti_join conserva las filas de x que no tienen pareja en y. Es la forma más sencilla de responder a preguntas como “¿qué clientes no tienen pedidos?”.
# Clientes sin pedidos
anti_join(clientes, pedidos, by = "id")
id nombre ciudad
1 4 David RomaSi intercambias las tablas, anti_join te sirve para revisar la calidad de un join antes de hacerlo. El siguiente código encuentra los pedidos cuyo cliente no existe, que son justo las filas que tendrían NA en un right_join.
# Pedidos de un cliente desconocido
anti_join(pedidos, clientes, by = "id")
pedido_id id importe
1 105 5 15¿Qué join tienes que usar?
La siguiente tabla resume las filas que devuelve cada join con los datos de ejemplo (4 clientes y 5 pedidos).
| Función | Filas que conserva | Añade columnas de y |
Filas en el ejemplo |
|---|---|---|---|
inner_join(x, y) |
Filas con pareja en ambas tablas | Sí | 4 |
left_join(x, y) |
Todas las filas de x |
Sí | 5 |
right_join(x, y) |
Todas las filas de y |
Sí | 5 |
full_join(x, y) |
Todas las filas de ambas tablas | Sí | 6 |
semi_join(x, y) |
Filas de x con pareja en y |
No | 3 |
anti_join(x, y) |
Filas de x sin pareja en y |
No | 1 |
Como regla general, usa left_join cuando quieras añadir información a una tabla principal sin perder filas, inner_join cuando solo te interesen los casos completos y anti_join para encontrar lo que no encaja.
Unir por varias columnas
A veces una sola columna no identifica una fila. En el siguiente ejemplo, cada venta se identifica por la tienda y el año, así que tienes que pasar ambas columnas a by.
ventas <- data.frame(tienda = c("A", "A", "B", "B"),
                     anio = c(2023, 2024, 2023, 2024),
                     ventas = c(100, 120, 90, 95))

objetivos <- data.frame(tienda = c("A", "A", "B"),
                        anio = c(2023, 2024, 2024),
                        objetivo = c(110, 115, 100))

left_join(ventas, objetivos, by = c("tienda", "anio"))
tienda anio ventas objetivo
1 A 2023 100 110
2 A 2024 120 115
3 B 2023 90 NA
4 B 2024 95 100Si te olvidas de una de las columnas clave y unes solo por tienda, cada venta se empareja con todos los objetivos de esa tienda. El resultado tiene 6 filas en lugar de 4, dos columnas de año (anio.x y anio.y) y un aviso:
left_join(ventas, objetivos, by = "tienda") tienda anio.x ventas anio.y objetivo
1 A 2023 100 2023 110
2 A 2023 100 2024 115
3 A 2024 120 2023 110
4 A 2024 120 2024 115
5 B 2023 90 2024 100
6 B 2024 95 2024 100
Warning message:
In left_join(ventas, objetivos, by = "tienda") :
Detected an unexpected many-to-many relationship between `x` and `y`.
ℹ Row 1 of `x` matches multiple rows in `y`.
ℹ Row 1 of `y` matches multiple rows in `x`.
ℹ If a many-to-many relationship is expected, set `relationship =
"many-to-many"` to silence this warning.Unir por columnas con nombres distintos
Es muy habitual que la clave tenga un nombre diferente en cada tabla. Supón que la columna id de la tabla de pedidos se llama cliente_id. Podrías renombrar la columna antes del join, pero no hace falta.
pedidos2 <- rename(pedidos, cliente_id = id)
pedidos2
pedido_id cliente_id importe
1 101 1 50
2 102 1 20
3 103 2 35
4 104 3 80
5 105 5 15Puedes pasar a by un vector con nombre, con la columna de x a la izquierda y la columna de y a la derecha. Desde dplyr 1.1.0 también puedes usar la función auxiliar join_by, que es más legible y utiliza == como si fuera una condición. Las dos líneas siguientes devuelven el mismo resultado.
# Vector con nombre
left_join(clientes, pedidos2, by = c("id" = "cliente_id"))

# join_by (dplyr >= 1.1.0)
left_join(clientes, pedidos2, by = join_by(id == cliente_id))
id nombre ciudad pedido_id importe
1 1 Ana Madrid 101 50
2 1 Ana Madrid 102 20
3 2 Ben Londres 103 35
4 3 Carla París 104 80
5 4 David Roma NA NAEl resultado solo conserva la columna clave de x (id). Si necesitas varias claves con nombres distintos, sepáralas con comas: join_by(id == cliente_id, anio == anio_pedido).
Columnas con el mismo nombre: el argumento suffix
Cuando las dos tablas tienen una columna con el mismo nombre que no forma parte de la clave, dplyr conserva ambas y les añade los sufijos .x e .y. En el siguiente ejemplo las dos tablas tienen una columna ciudad.
tiendas <- data.frame(id = c(1, 2, 3),
                      ciudad = c("Madrid", "Berlín", "París"))

left_join(clientes, tiendas, by = "id")
id nombre ciudad.x ciudad.y
1 1 Ana Madrid Madrid
2 2 Ben Londres Berlín
3 3 Carla París París
4 4 David Roma <NA>Utiliza el argumento suffix para darles nombres con sentido:
left_join(clientes, tiendas,
          by = "id",
          suffix = c("_cliente", "_tienda"))
id nombre ciudad_cliente ciudad_tienda
1 1 Ana Madrid Madrid
2 2 Ben Londres Berlín
3 3 Carla París París
4 4 David Roma <NA>Si las dos columnas contienen realmente la misma información, normalmente es mejor añadirla a la clave (by = c("id", "ciudad")) o eliminarla de una de las tablas con select antes de unirlas.
¿Por qué un left join devuelve más filas?
Una sorpresa frecuente es que left_join devuelva más filas que la tabla original. La tabla de clientes tiene 4 filas, pero el resultado del left join tiene 5:
nrow(clientes)
nrow(left_join(clientes, pedidos, by = "id"))
[1] 4
[1] 5left_join garantiza que no se pierde ninguna fila de x, pero no que el número de filas se mantenga. Si una clave de x coincide con varias filas de y, la fila de x se repite una vez por cada coincidencia. Ana tiene dos pedidos, así que aparece dos veces. Esto es correcto en una relación clientes-pedidos (uno a muchos), pero es un error si esperabas una fila por cliente.
Para encontrar las claves repetidas en la segunda tabla puedes contarlas:
pedidos %>%
  count(id) %>%
  filter(n > 1)
id n
1 1 2Si quieres una fila por cliente, resume primero los pedidos (por ejemplo, el importe total por cliente con group_by y summarise) y después une la tabla resumida.
El aviso “many-to-many relationship”
Desde dplyr 1.1.0, los joins te avisan cuando una clave está duplicada en las dos tablas, porque cada fila duplicada de x se combina con cada fila duplicada de y y el número de filas puede crecer muy rápido. Considera una tabla de stock y una tabla de precios en la que el precio del boli se introdujo dos veces por error:
precios <- data.frame(producto = c("boli", "boli", "libro"),
                      precio = c(1, 1.2, 10))

stock <- data.frame(producto = c("boli", "boli", "libro"),
                    tienda = c("T1", "T2", "T1"))

left_join(stock, precios, by = "producto")
producto tienda precio
1 boli T1 1.0
2 boli T1 1.2
3 boli T2 1.0
4 boli T2 1.2
5 libro T1 10.0
Warning message:
In left_join(stock, precios, by = "producto") :
Detected an unexpected many-to-many relationship between `x` and `y`.
ℹ Row 1 of `x` matches multiple rows in `y`.
ℹ Row 1 of `y` matches multiple rows in `x`.
ℹ If a many-to-many relationship is expected, set `relationship =
"many-to-many"` to silence this warning.El aviso indica que la fila 1 de x coincide con varias filas de y y viceversa. Cada boli de la tabla de stock se ha emparejado con los dos precios, así que el resultado tiene 5 filas en lugar de 3. Hay dos soluciones posibles, según si los duplicados son un error o no:
- Los duplicados son un error (lo habitual). Elimínalos de la tabla de referencia, por ejemplo con
distinct(tienes más detalles en cómo eliminar duplicados en R), o añade abyla columna clave que falta. - La relación muchos a muchos es esperada. Indica
relationship = "many-to-many"para silenciar el aviso.
# Conserva el primer precio de cada producto
precios_limpio <- precios %>%
  distinct(producto, .keep_all = TRUE)

# Join con la tabla limpia
left_join(stock, precios_limpio, by = "producto")
producto tienda precio
1 boli T1 1
2 boli T2 1
3 libro T1 10No uses relationship = "many-to-many" solo para que desaparezca el aviso. En la mayoría de los casos el aviso significa que la clave no identifica de forma única las filas de la tabla de referencia y el resultado contiene filas duplicadas que distorsionarán cualquier suma o media posterior.
El argumento relationship también es útil para validar tus supuestos. Si cada producto debería tener un único precio, indica relationship = "many-to-one" y dplyr lanzará un error en lugar de devolver filas duplicadas:
left_join(stock, precios, by = "producto", relationship = "many-to-one")Error in `left_join()`:
! Each row in `x` must match at most 1 row in `y`.
ℹ Row 1 of `x` matches multiple rows in `y`.Los valores posibles son "one-to-one", "one-to-many", "many-to-one" y "many-to-many".
Valores NA después de un join
Los joins externos (left_join, right_join y full_join) rellenan con NA las columnas de las filas sin pareja. Por eso David tiene NA en pedido_id e importe después del left join. Estos NA no significan que los datos estén mal, pero tienes que tenerlos en cuenta antes de calcular estadísticos. Si un cliente sin pedidos significa “importe cero”, puedes reemplazar los NA con coalesce dentro de mutate:
clientes %>%
  left_join(pedidos, by = "id") %>%
  mutate(importe = coalesce(importe, 0))
id nombre ciudad pedido_id importe
1 1 Ana Madrid 101 50
2 1 Ana Madrid 102 20
3 2 Ben Londres 103 35
4 3 Carla París 104 80
5 4 David Roma NA 0Si obtienes muchos más NA de los esperados, probablemente las claves no coinciden por su formato: un número guardado como texto en una tabla y como numérico en la otra, espacios en blanco de más o mayúsculas distintas. Compruébalo con anti_join, como has visto antes. Aprende más sobre los datos faltantes en el tutorial sobre valores NA en R.
merge() frente a los joins de dplyr
R base permite hacer los mismos joins con la función merge. La siguiente tabla muestra las equivalencias:
| R base | dplyr |
|---|---|
merge(x, y, by = "id") |
inner_join(x, y, by = "id") |
merge(x, y, by = "id", all.x = TRUE) |
left_join(x, y, by = "id") |
merge(x, y, by = "id", all.y = TRUE) |
right_join(x, y, by = "id") |
merge(x, y, by = "id", all = TRUE) |
full_join(x, y, by = "id") |
merge(x, y, by.x = "id", by.y = "cliente_id") |
inner_join(x, y, by = join_by(id == cliente_id)) |
x[x$id %in% y$id, ] |
semi_join(x, y, by = "id") |
x[!x$id %in% y$id, ] |
anti_join(x, y, by = "id") |
Las principales diferencias prácticas son que merge ordena el resultado por la clave por defecto, mientras que los joins de dplyr mantienen el orden original de las filas de x, y que merge no te avisa de las relaciones muchos a muchos.