Agrupar datos en R con la función group_by() de dplyr
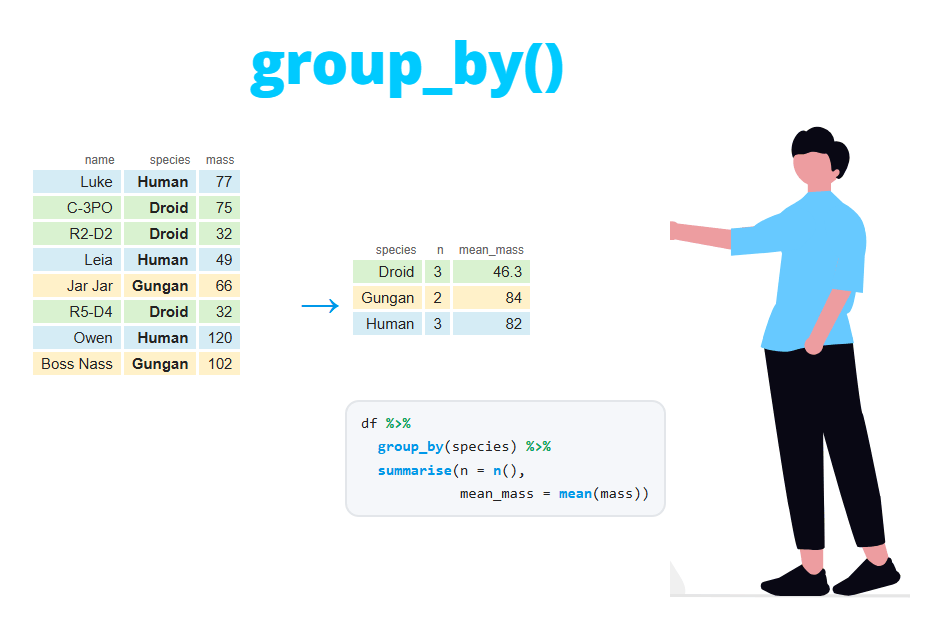
La función group_by de dplyr divide un data frame en grupos según los valores de una o varias columnas, de modo que los siguientes verbos (summarise, mutate, filter, slice o arrange) se aplican a cada grupo por separado. En este tutorial aprenderás cómo funciona realmente la agrupación, qué significa el mensaje "has grouped output by", por qué tienes que desagrupar los datos con ungroup y cuándo te conviene usar el argumento .by.
Datos de ejemplo
En este tutorial utilizaremos un subconjunto del conjunto de datos starwars de dplyr: los personajes de tres especies (humanos, droides y gungans) cuyo peso es conocido. El data frame resultante contiene 26 filas y cinco columnas. El código utiliza el operador pipe %>% para encadenar los pasos.
library(dplyr)

df <- starwars %>%
  select(name, species, sex, height, mass) %>%
  filter(species %in% c("Human", "Droid", "Gungan"), !is.na(mass))

df
# A tibble: 26 × 5
name species sex height mass
<chr> <chr> <chr> <int> <dbl>
1 Luke Skywalker Human male 172 77
2 C-3PO Droid none 167 75
3 R2-D2 Droid none 96 32
4 Darth Vader Human male 202 136
5 Leia Organa Human female 150 49
6 Owen Lars Human male 178 120
7 Beru Whitesun Lars Human female 165 75
8 R5-D4 Droid none 97 32
9 Biggs Darklighter Human male 183 84
10 Obi-Wan Kenobi Human male 182 77
# ℹ 16 more rows¿Qué hace group_by?
Algo que sorprende a mucha gente es que group_by no modifica los datos. Si imprimes un data frame agrupado verás exactamente las mismas filas en el mismo orden. La única diferencia es una nueva línea en la cabecera, # Groups: species [3], que indica la variable de agrupación y el número de grupos.
df_g <- df %>%
  group_by(species)

df_g
# A tibble: 26 × 5
# Groups: species [3]
name species sex height mass
<chr> <chr> <chr> <int> <dbl>
1 Luke Skywalker Human male 172 77
2 C-3PO Droid none 167 75
3 R2-D2 Droid none 96 32
4 Darth Vader Human male 202 136
5 Leia Organa Human female 150 49
6 Owen Lars Human male 178 120
7 Beru Whitesun Lars Human female 165 75
8 R5-D4 Droid none 97 32
9 Biggs Darklighter Human male 183 84
10 Obi-Wan Kenobi Human male 182 77
# ℹ 16 more rowsInternamente, el data frame pasa a ser un objeto de clase grouped_df que guarda qué filas pertenecen a cada grupo. No ocurre nada hasta que un verbo utiliza esa información. Puedes consultar los grupos con n_groups, group_vars y group_keys:
class(df_g)
n_groups(df_g)
group_vars(df_g)
group_keys(df_g)
[1] "grouped_df" "tbl_df" "tbl" "data.frame"
[1] 3
[1] "species"
# A tibble: 3 × 1
species
<chr>
1 Droid
2 Gungan
3 HumanLa siguiente tabla resume cómo se comporta cada verbo de dplyr cuando los datos están agrupados:
| Verbo | Sin grupos | Con group_by |
|---|---|---|
summarise() |
Una fila para todos los datos | Una fila por grupo |
mutate() |
Los cálculos usan toda la columna | Los cálculos usan las filas de cada grupo |
filter() |
Las condiciones usan toda la columna | Las condiciones se evalúan dentro de cada grupo |
slice_*() |
Selecciona filas del total de datos | Selecciona filas de cada grupo |
arrange() |
Ordena todos los datos | Ignora los grupos salvo con .by_group = TRUE |
group_by con summarise
El uso más habitual de group_by es junto con la función summarise, que resume cada grupo en una única fila. La función n devuelve el número de filas de cada grupo, así que el siguiente código cuenta las observaciones de cada especie:
df %>%
  group_by(species) %>%
  summarise(n = n())
# A tibble: 3 × 2
species n
<chr> <int>
1 Droid 4
2 Gungan 2
3 Human 20Puedes calcular tantos estadísticos por grupo como quieras dentro de la misma llamada a summarise. Fíjate en que los grupos aparecen ordenados alfabéticamente en la salida.
df %>%
  group_by(species) %>%
  summarise(n = n(),
            mean_height = mean(height),
            mean_mass = mean(mass),
            max_mass = max(mass))
# A tibble: 3 × 5
species n mean_height mean_mass max_mass
<chr> <int> <dbl> <dbl> <dbl>
1 Droid 4 140 69.8 140
2 Gungan 2 210 74 82
3 Human 20 180. 81.3 136Si un grupo contiene valores faltantes, funciones como mean o sum devolverán NA para ese grupo. Por ejemplo, con el conjunto starwars completo, summarise(mean_mass = mean(mass)) devuelve NA para las tres especies. Usa mean(mass, na.rm = TRUE) para ignorarlos. Consulta el artículo sobre valores NA en R para más detalles.
También puedes agrupar por una expresión en lugar de por una columna existente. En el ejemplo siguiente los personajes se dividen en altos (más de 180 cm) y no altos:
df %>%
  group_by(alto = height > 180) %>%
  summarise(n = n(), mean_mass = mean(mass))
# A tibble: 2 × 3
alto n mean_mass
<lgl> <int> <dbl>
1 FALSE 12 70.8
2 TRUE 14 85.9Agrupar por varias columnas
Para agrupar por más de una variable, pásalas todas a group_by separadas por comas. Cada combinación de valores presente en los datos se convierte en un grupo:
res <- df %>%
  group_by(species, sex) %>%
  summarise(n = n(), mean_mass = mean(mass))

res
`summarise()` has grouped output by 'species'. You can override using the `.groups` argument.
# A tibble: 4 × 4
# Groups: species [3]
species sex n mean_mass
<chr> <chr> <int> <dbl>
1 Droid none 4 69.8
2 Gungan male 2 74
3 Human female 3 56.3
4 Human male 17 85.7¿Qué significa “summarise() has grouped output by”?
Este mensaje no es un error ni una advertencia. Cada llamada a summarise elimina la última variable de agrupación (en este caso sex) y mantiene las demás. El mensaje simplemente te avisa de que el resultado sigue agrupado por species, como muestra la línea # Groups: species [3].
Esto es importante porque cualquier verbo que apliques después trabajará dentro de cada especie. Por ejemplo, si calculas el porcentaje de personajes de cada fila, el denominador sum(n) es el total de cada especie, no el total de los datos:
res %>%
  mutate(pct = n / sum(n) * 100)
# A tibble: 4 × 5
# Groups: species [3]
species sex n mean_mass pct
<chr> <chr> <int> <dbl> <dbl>
1 Droid none 4 69.8 100
2 Gungan male 2 74 100
3 Human female 3 56.3 15
4 Human male 17 85.7 85Esta salida es correcta si querías el porcentaje de cada sexo dentro de cada especie (el 15% de los humanos son mujeres). Si lo que querías era el porcentaje sobre los 26 personajes, utiliza .groups = "drop" para eliminar todos los grupos después de resumir:
df %>%
  group_by(species, sex) %>%
  summarise(n = n(), .groups = "drop") %>%
  mutate(pct = n / sum(n) * 100)
# A tibble: 4 × 4
species sex n pct
<chr> <chr> <int> <dbl>
1 Droid none 4 15.4
2 Gungan male 2 7.69
3 Human female 3 11.5
4 Human male 17 65.4Los valores posibles de .groups son:
"drop_last": elimina la última variable de agrupación. Es el comportamiento por defecto y el que muestra el mensaje."drop": elimina todos los grupos. El resultado es un tibble sin agrupar. Es la opción más segura en la mayoría de los casos."keep": mantiene los mismos grupos que la entrada (# Groups: species, sex [4])."rowwise": cada fila pasa a ser su propio grupo.
Si indicas .groups de forma explícita, aunque sea "drop_last", el mensaje deja de aparecer.
group_by con mutate
Cuando los datos están agrupados, la función mutate conserva todas las filas, pero los cálculos utilizan solo los valores del grupo de cada fila. Esto resulta útil para comparar cada observación con su grupo. En el siguiente ejemplo mean(mass) es la media de cada especie, por lo que diff_mean es la diferencia entre el peso de cada personaje y el peso medio de su especie:
df %>%
  group_by(species) %>%
  mutate(mean_mass = mean(mass),
         diff_mean = mass - mean_mass) %>%
  select(name, species, mass, mean_mass, diff_mean)
# A tibble: 26 × 5
# Groups: species [3]
name species mass mean_mass diff_mean
<chr> <chr> <dbl> <dbl> <dbl>
1 Luke Skywalker Human 77 81.3 -4.31
2 C-3PO Droid 75 69.8 5.25
3 R2-D2 Droid 32 69.8 -37.8
4 Darth Vader Human 136 81.3 54.7
5 Leia Organa Human 49 81.3 -32.3
6 Owen Lars Human 120 81.3 38.7
7 Beru Whitesun Lars Human 75 81.3 -6.31
8 R5-D4 Droid 32 69.8 -37.8
9 Biggs Darklighter Human 84 81.3 2.69
10 Obi-Wan Kenobi Human 77 81.3 -4.31
# ℹ 16 more rowsObserva que mean_mass vale 81.3 para todos los humanos y 69.8 para todos los droides. Sin group_by, la columna contendría la media global (79.0) en todas las filas.
Del mismo modo, puedes calcular el porcentaje sobre el total del grupo o la posición dentro de cada grupo. A continuación, pct_mass es el porcentaje que representa cada personaje sobre el peso total de su especie y rank_height es la posición de cada personaje dentro de su especie ordenando de más alto a más bajo:
df %>%
  group_by(species) %>%
  mutate(pct_mass = mass / sum(mass) * 100,
         rank_height = min_rank(desc(height))) %>%
  select(name, species, height, mass, pct_mass, rank_height)
# A tibble: 26 × 6
# Groups: species [3]
name species height mass pct_mass rank_height
<chr> <chr> <int> <dbl> <dbl> <int>
1 Luke Skywalker Human 172 77 4.73 16
2 C-3PO Droid 167 75 26.9 2
3 R2-D2 Droid 96 32 11.5 4
4 Darth Vader Human 202 136 8.36 1
5 Leia Organa Human 150 49 3.01 20
6 Owen Lars Human 178 120 7.38 13
7 Beru Whitesun Lars Human 165 75 4.61 19
8 R5-D4 Droid 97 32 11.5 3
9 Biggs Darklighter Human 183 84 5.17 8
10 Obi-Wan Kenobi Human 182 77 4.73 11
# ℹ 16 more rowsDarth Vader es el humano más alto (posición 1) y C-3PO es el segundo droide más alto. A diferencia de summarise, mutate no elimina ninguna variable de agrupación, por lo que el resultado sigue agrupado por species.
group_by con filter
La función filter evalúa las condiciones dentro de cada grupo cuando los datos están agrupados. Esto permite quedarte, por ejemplo, con los personajes que pesan más que la media de su propia especie:
df %>%
  group_by(species) %>%
  filter(mass > mean(mass))
# A tibble: 9 × 5
# Groups: species [3]
name species sex height mass
<chr> <chr> <chr> <int> <dbl>
1 C-3PO Droid none 167 75
2 Darth Vader Human male 202 136
3 Owen Lars Human male 178 120
4 Biggs Darklighter Human male 183 84
5 Anakin Skywalker Human male 188 84
6 IG-88 Droid none 200 140
7 Qui-Gon Jinn Human male 193 89
8 Roos Tarpals Gungan male 224 82
9 Mace Windu Human male 188 84C-3PO pesa 75 kg, menos que la media global, pero se conserva porque pesa más que el droide medio (69.8 kg).
También puedes filtrar grupos completos. Usando n() dentro de filter puedes quedarte solo con los grupos que tienen más de un número determinado de filas:
df %>%
  group_by(species) %>%
  filter(n() > 2) %>%
  summarise(n = n())
# A tibble: 2 × 2
species n
<chr> <int>
1 Droid 4
2 Human 20Primeras filas de cada grupo con slice
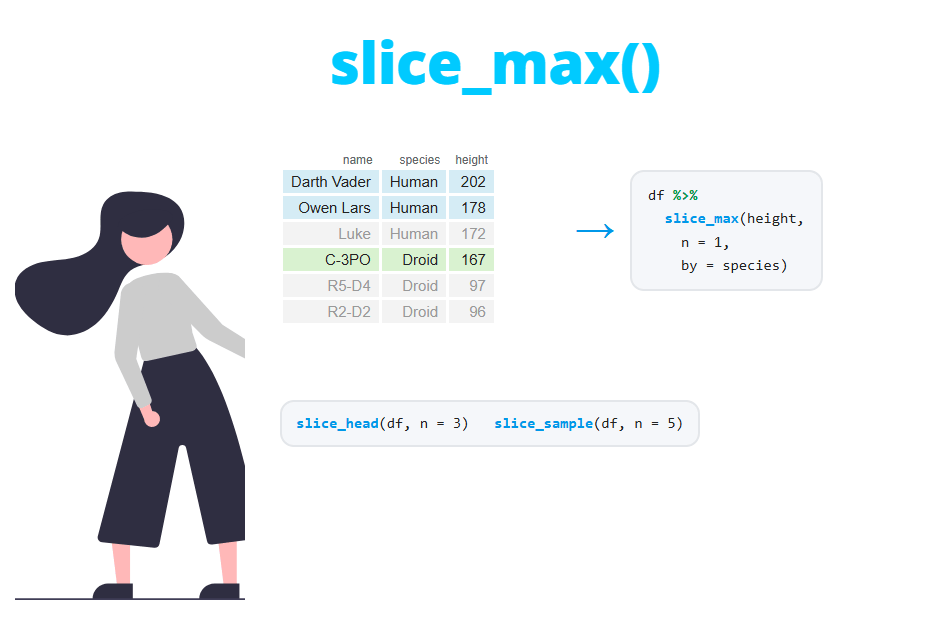
Para obtener las N primeras filas de cada grupo según una variable, la opción más sencilla es slice_max (o slice_min para los valores más bajos). El siguiente código devuelve los dos personajes más pesados de cada especie:
df %>%
  group_by(species) %>%
  slice_max(mass, n = 2)
# A tibble: 6 × 5
# Groups: species [3]
name species sex height mass
<chr> <chr> <chr> <int> <dbl>
1 IG-88 Droid none 200 140
2 C-3PO Droid none 167 75
3 Roos Tarpals Gungan male 224 82
4 Jar Jar Binks Gungan male 196 66
5 Darth Vader Human male 202 136
6 Owen Lars Human male 178 120Ten en cuenta que slice_max devuelve todas las filas empatadas por defecto, así que puedes obtener más de n filas por grupo. Utiliza with_ties = FALSE si necesitas exactamente n filas. Las demás funciones slice también trabajan por grupo: slice_head(n = 1) devuelve la primera fila de cada grupo y slice_sample extrae una muestra aleatoria de cada grupo. Puedes leer más sobre seleccionar filas por posición.
df %>%
  group_by(species) %>%
  slice_head(n = 1)
# A tibble: 3 × 5
# Groups: species [3]
name species sex height mass
<chr> <chr> <chr> <int> <dbl>
1 C-3PO Droid none 167 75
2 Jar Jar Binks Gungan male 196 66
3 Luke Skywalker Human male 172 77group_by con arrange
La función arrange es la excepción: ignora los grupos por defecto y ordena todo el data frame. Si quieres ordenar las filas dentro de cada grupo (y que los grupos aparezcan juntos) tendrás que indicar .by_group = TRUE:
df %>%
  group_by(species) %>%
  arrange(desc(height), .by_group = TRUE)
# A tibble: 26 × 5
# Groups: species [3]
name species sex height mass
<chr> <chr> <chr> <int> <dbl>
1 IG-88 Droid none 200 140
2 C-3PO Droid none 167 75
3 R5-D4 Droid none 97 32
4 R2-D2 Droid none 96 32
5 Roos Tarpals Gungan male 224 82
6 Jar Jar Binks Gungan male 196 66
7 Darth Vader Human male 202 136
8 Qui-Gon Jinn Human male 193 89
9 Dooku Human male 193 80
10 Anakin Skywalker Human male 188 84
# ℹ 16 more rowsSin .by_group = TRUE las primeras filas serían Roos Tarpals, Darth Vader e IG-88, los tres personajes más altos sin importar su especie.
ungroup: eliminar los grupos
Los grupos se mantienen hasta que los eliminas. mutate, filter, slice y arrange devuelven datos agrupados y summarise solo elimina un nivel. Por eso olvidar desagrupar es uno de los errores más frecuentes con dplyr: guardas un data frame agrupado y, más adelante, una operación que debería usar todos los datos se aplica por grupo sin ningún aviso.
En el siguiente ejemplo se agruparon los datos para calcular mean_mass. Después quieres obtener el personaje más pesado de todos, pero como los datos siguen agrupados obtienes el más pesado de cada especie:
df_g <- df %>%
  group_by(species) %>%
  mutate(mean_mass = mean(mass))

df_g %>% slice_max(mass, n = 1)
# A tibble: 3 × 6
# Groups: species [3]
name species sex height mass mean_mass
<chr> <chr> <chr> <int> <dbl> <dbl>
1 IG-88 Droid none 200 140 69.8
2 Roos Tarpals Gungan male 224 82 74
3 Darth Vader Human male 202 136 81.3Si llamas a ungroup se eliminan todos los grupos y obtienes el resultado esperado:
df_g %>%
  ungroup() %>%
  slice_max(mass, n = 1)
# A tibble: 1 × 6
name species sex height mass mean_mass
<chr> <chr> <chr> <int> <dbl> <dbl>
1 IG-88 Droid none 200 140 69.8Una buena costumbre es terminar cada cadena agrupada con ungroup() (o con .groups = "drop" en summarise) antes de guardar el resultado. Si no sabes si un data frame está agrupado, imprímelo y busca la línea # Groups: o ejecuta group_vars(df).
El argumento .by (dplyr 1.1.0 o posterior)
Desde dplyr 1.1.0, summarise, mutate, filter y slice admiten el argumento .by (en slice_max, slice_head y el resto de funciones slice_* se llama by). Este argumento agrupa los datos solo para esa operación y siempre devuelve un data frame sin agrupar, así que no necesitas ungroup y no verás el mensaje de .groups.
df %>%
  summarise(n = n(), mean_mass = mean(mass), .by = species)
# A tibble: 3 × 3
species n mean_mass
<chr> <int> <dbl>
1 Human 20 81.3
2 Droid 4 69.8
3 Gungan 2 74Los resultados son los mismos que con group_by, pero fíjate en que los grupos mantienen el orden en el que aparecen por primera vez en los datos en lugar de ordenarse alfabéticamente. Para agrupar por varias columnas utiliza c():
df %>%
  summarise(n = n(), mean_mass = mean(mass), .by = c(species, sex))
# A tibble: 4 × 4
species sex n mean_mass
<chr> <chr> <int> <dbl>
1 Human male 17 85.7
2 Droid none 4 69.8
3 Human female 3 56.3
4 Gungan male 2 74No puedes combinar ambos enfoques. Si los datos ya están agrupados y pasas .by, obtendrás el siguiente error:
Error in `summarise()`:
! Can't supply `.by` when `.data` is a grouped data frame.
Entonces, ¿cuál deberías usar? Usa .by para una única operación agrupada, ya que es más corto y no puede dejar grupos olvidados. Usa group_by cuando varios verbos seguidos comparten los mismos grupos o cuando necesitas arrange(.by_group = TRUE) o funciones como group_keys.
Contar filas por grupo con count
Contar observaciones por grupo es tan habitual que dplyr ofrece un atajo. count(species) equivale a group_by(species) %>% summarise(n = n()), pero además devuelve un data frame sin agrupar:
df %>%
  count(species)
# A tibble: 3 × 2
species n
<chr> <int>
1 Droid 4
2 Gungan 2
3 Human 20Puedes contar por varias variables, ordenar la salida de mayor a menor frecuencia con sort = TRUE y cambiar el nombre de la nueva columna con el argumento name:
df %>%
  count(species, sex, sort = TRUE)
# A tibble: 4 × 3
species sex n
<chr> <chr> <int>
1 Human male 17
2 Droid none 4
3 Human female 3
4 Gungan male 2Si quieres conservar todas las filas y añadir el tamaño del grupo como una nueva columna, utiliza add_count(species).
Equivalentes en R base
Si no quieres usar dplyr, también puedes obtener resúmenes por grupo en R base. La función aggregate devuelve un data frame y la función tapply devuelve un vector con nombres:
aggregate(mass ~ species, data = df, FUN = mean)

tapply(df$mass, df$species, mean)
species mass
1 Droid 69.75
2 Gungan 74.00
3 Human 81.31
Droid Gungan Human
69.75 74.00 81.31Para contar por grupo, la función table es la alternativa a count en R base. Sin embargo, dplyr es más cómodo cuando necesitas operaciones mutate o filter por grupo, que en R base requieren más código.
Si cargas el paquete plyr después de dplyr, plyr::summarise enmascara a dplyr::summarise y los grupos se ignoran: obtendrás una sola fila para todos los datos o un error que indica que n() solo puede usarse dentro de verbos de dplyr. Carga plyr antes que dplyr o llama a dplyr::summarise de forma explícita.