Seleccionar filas por posición con slice() de dplyr
La familia de funciones slice de dplyr selecciona filas de un data frame según su posición en lugar de según una condición. slice utiliza números de fila, slice_head y slice_tail devuelven las primeras o las últimas filas, slice_min y slice_max devuelven las filas con los valores más bajos o más altos de una variable y slice_sample extrae una muestra aleatoria. En este tutorial aprenderás a usar cada una de ellas, a obtener las N primeras filas de cada grupo, cómo se tratan los empates y los valores faltantes y qué función elegir en cada caso.
Datos de ejemplo
En este tutorial utilizaremos un subconjunto del conjunto de datos starwars de dplyr: los personajes de tres especies (humanos, droides y gungans) cuyo peso es conocido. El data frame resultante contiene 26 filas y cuatro columnas. El código utiliza el operador pipe %>% para encadenar los pasos.
library(dplyr)

df <- starwars %>%
  select(name, species, height, mass) %>%
  filter(species %in% c("Human", "Droid", "Gungan"), !is.na(mass))

df
# A tibble: 26 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Luke Skywalker Human 172 77
2 C-3PO Droid 167 75
3 R2-D2 Droid 96 32
4 Darth Vader Human 202 136
5 Leia Organa Human 150 49
6 Owen Lars Human 178 120
7 Beru Whitesun Lars Human 165 75
8 R5-D4 Droid 97 32
9 Biggs Darklighter Human 183 84
10 Obi-Wan Kenobi Human 182 77
# ℹ 16 more rowsSeleccionar filas por posición con slice
La función slice recibe un vector de números de fila y devuelve esas filas en el orden que indiques. Funciona como df[c(1, 3, 5), ] en R base, pero encaja en un flujo con pipes y siempre devuelve un tibble:
df %>%
  slice(c(1, 3, 5))
# A tibble: 3 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Luke Skywalker Human 172 77
2 R2-D2 Droid 96 32
3 Leia Organa Human 150 49Puedes utilizar la función n(), que devuelve el número de filas, para referirte a la última fila sin conocer el tamaño de los datos. Por ejemplo, slice(n()) devuelve la última fila y slice((n() - 2):n()) las tres últimas. Si repites una posición, la fila se duplica: slice(c(1, 1, 2)) devuelve dos veces a Luke Skywalker.
Eliminar filas con índices negativos
Las posiciones negativas eliminan filas en lugar de seleccionarlas. Es la forma más sencilla de eliminar la primera fila de un data frame, por ejemplo cuando la primera línea de un archivo contiene una segunda cabecera o las unidades:
# Eliminar la primera fila
df %>%
  slice(-1)
# A tibble: 25 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 C-3PO Droid 167 75
2 R2-D2 Droid 96 32
3 Darth Vader Human 202 136
4 Leia Organa Human 150 49
5 Owen Lars Human 178 120
6 Beru Whitesun Lars Human 165 75
7 R5-D4 Droid 97 32
8 Biggs Darklighter Human 183 84
9 Obi-Wan Kenobi Human 182 77
10 Anakin Skywalker Human 188 84
# ℹ 15 more rowsPara eliminar varias filas utiliza un vector negativo, como slice(-(1:3)) para quitar las tres primeras o slice(-n()) para quitar la última. No olvides los paréntesis: -1:3 es la secuencia -1, 0, 1, 2, 3, no -1, -2, -3.
Posiciones fuera de rango y signos mezclados
Hay dos comportamientos de slice que sorprenden a mucha gente. El primero es que las posiciones mayores que el número de filas se ignoran sin avisar. Los datos tienen 26 filas, así que al pedir las filas 25 a 30 solo obtienes dos, sin ninguna advertencia:
df %>%
  slice(25:30)
# A tibble: 2 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Jango Fett Human 183 79
2 Raymus Antilles Human 188 79El segundo es que no puedes mezclar posiciones positivas y negativas en la misma llamada:
df %>%
slice(-1, 2)Error in `slice()`:
! Can't compute indices.
Caused by error:
! Can't subset elements with `-1`.
✖ Negative and positive locations can't be mixed.
ℹ Subscript `-1` has a positive value at location 2.Si lo que quieres es seleccionar filas según sus valores y no según su posición, utiliza la función filter.
Primeras y últimas filas: slice_head y slice_tail
slice_head devuelve las primeras filas y slice_tail las últimas filas de los datos. El número de filas se indica con el argumento n. Ten en cuenta que tienes que escribir su nombre: slice_head(3) da un error, mientras que slice_head(n = 3) funciona.
df %>%
slice_head(n = 3)
df %>%
slice_tail(n = 2)# A tibble: 3 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Luke Skywalker Human 172 77
2 C-3PO Droid 167 75
3 R2-D2 Droid 96 32
# A tibble: 2 × 4
  name            species height  mass
  <chr>           <chr>    <int> <dbl>
1 Jango Fett      Human      183    79
2 Raymus Antilles Human 188 79En lugar de un número de filas, puedes indicar una proporción con el argumento prop. El resultado se redondea hacia abajo: el 10% de 26 filas es 2.6, así que obtienes dos filas.
df %>%
  slice_head(prop = 0.1)
# A tibble: 2 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Luke Skywalker Human 172 77
2 C-3PO Droid 167 75slice_head y slice_tail equivalen a las funciones head y tail de R base, con la ventaja de que también funcionan por grupo, como verás más adelante. Ambas utilizan el orden actual de las filas, así que si quieres las primeras filas según una variable, ordena antes los datos con arrange o utiliza slice_min y slice_max.
Filas con los valores más bajos o más altos: slice_min y slice_max
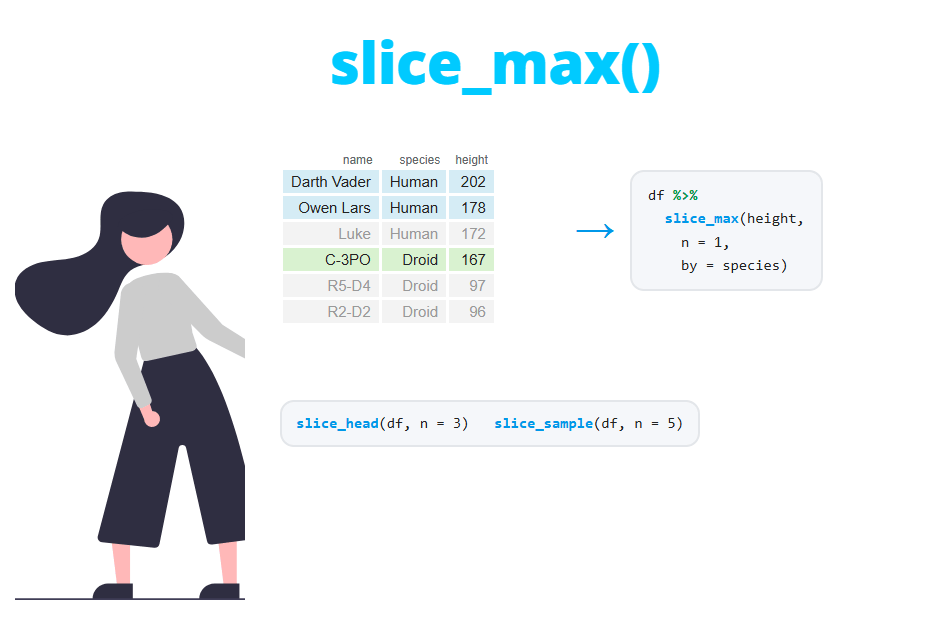
slice_min y slice_max devuelven las filas con los valores más bajos o más altos de una variable, ordenadas según esa variable. El siguiente código devuelve los tres personajes más altos:
df %>%
  slice_max(height, n = 3)
# A tibble: 3 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Roos Tarpals Gungan 224 82
2 Darth Vader Human 202 136
3 IG-88 Droid 200 140El resultado es el mismo que con df %>% arrange(desc(height)) %>% slice_head(n = 3), pero el código es más corto y se lee mejor. slice_max también admite prop, de modo que slice_max(mass, prop = 0.1) devuelve el 10% de personajes más pesados.
Empates: el argumento with_ties
Por defecto, slice_min y slice_max conservan todas las filas empatadas, por lo que la salida puede tener más filas que n. R2-D2 y R5-D4 pesan 32 kg, así que al pedir el personaje más ligero obtienes dos filas:
df %>%
  slice_min(mass, n = 1)
# A tibble: 2 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 R2-D2 Droid 96 32
2 R5-D4 Droid 97 32Si necesitas exactamente n filas, indica with_ties = FALSE. En ese caso se conserva la primera fila empatada que aparece en los datos:
df %>%
  slice_min(mass, n = 1, with_ties = FALSE)
# A tibble: 1 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 R2-D2 Droid 96 32¿Cuál deberías elegir? Mantén los empates cuando el resultado sea una clasificación que vas a leer o presentar (no sería justo dejar fuera a R5-D4). Utiliza with_ties = FALSE cuando el siguiente paso requiera un número fijo de filas, por ejemplo para unir exactamente una fila por grupo a otra tabla.
Si el empate debe romperse con una segunda variable, ordena antes los datos y luego utiliza slice_head. Por ejemplo, df %>% arrange(mass, desc(height)) %>% slice_head(n = 1) devuelve el personaje más ligero y, en caso de empate, el más alto (R5-D4).
Valores faltantes
slice_min y slice_max colocan los valores NA al final, pero no los eliminan. Si n es mayor que el número de valores no faltantes, la salida incluye filas con NA y, como todos los NA se consideran empatados, puedes obtener incluso más filas de las esperadas:
d <- tibble(id = 1:5, valor = c(3, NA, 1, 5, NA))

d %>% slice_max(valor, n = 4)
d %>% slice_max(valor, n = 4, na_rm = TRUE)
# A tibble: 5 × 2
id valor
<int> <dbl>
1 4 5
2 1 3
3 3 1
4 2 NA
5 5 NA
# A tibble: 3 × 2
id valor
<int> <dbl>
1 4 5
2 1 3
3 3 1Con na_rm = TRUE los valores faltantes se eliminan antes de seleccionar las filas.
Las N primeras filas de cada grupo
Todas las funciones slice_* trabajan por grupo. Puedes agrupar los datos con group_by o, desde dplyr 1.1.0, utilizar el argumento by, que agrupa solo para esa operación y devuelve un data frame sin agrupar. Fíjate en que en las funciones slice_* el argumento se llama by y no .by como en mutate o summarise. El siguiente código devuelve el personaje más alto de cada especie:
df %>%
  slice_max(height, n = 1, by = species)
# A tibble: 3 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Darth Vader Human 202 136
2 IG-88 Droid 200 140
3 Roos Tarpals Gungan 224 82Los empates también se aplican dentro de cada grupo. Al pedir el personaje más ligero de cada especie obtienes cuatro filas, porque los dos droides más ligeros están empatados:
df %>%
  slice_min(mass, n = 1, by = species)
# A tibble: 4 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Padmé Amidala Human 185 45
2 R2-D2 Droid 96 32
3 R5-D4 Droid 97 32
4 Jar Jar Binks Gungan 196 66Con by los grupos aparecen en el orden en el que aparecen por primera vez en los datos. Con group_by se ordenan alfabéticamente y el resultado sigue agrupado, así que recuerda llamar a ungroup después.
Primera y última fila de cada grupo
Para seleccionar la primera fila de cada grupo utiliza slice_head(n = 1) por grupo, y slice_tail(n = 1) para la última. Esto es especialmente útil cuando los datos están ordenados por fecha o por otra variable y necesitas el primer registro o el más reciente de cada sujeto:
df %>%
  slice_head(n = 1, by = species)

df %>%
  slice_tail(n = 1, by = species)
# A tibble: 3 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Luke Skywalker Human 172 77
2 C-3PO Droid 167 75
3 Jar Jar Binks Gungan 196 66
# A tibble: 3 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Raymus Antilles Human 188 79
2 IG-88 Droid 200 140
3 Roos Tarpals Gungan 224 82Con datos agrupados también puedes usar slice con posiciones, que en ese caso son relativas a cada grupo. group_by(species) %>% slice(1) devuelve la primera fila de cada especie y slice(n()) la última.
Filas aleatorias con slice_sample
slice_sample selecciona filas al azar. Igual que con las demás funciones, puedes indicar un número de filas con n o una proporción con prop. Llama a set.seed antes de muestrear si quieres obtener las mismas filas cada vez que ejecutes el código:
set.seed(123)

df %>%
  slice_sample(n = 3)
# A tibble: 3 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Boba Fett Human 183 78.2
2 Qui-Gon Jinn Human 193 89
3 Palpatine Human 170 75Por defecto la muestra es sin reemplazo, de modo que cada fila solo puede aparecer una vez. Si n es mayor que el número de filas no obtendrás ningún error: slice_sample(n = 30) simplemente devuelve las 26 filas en orden aleatorio. Indica replace = TRUE para muestrear con reemplazo, como en un bootstrap. Ahora la misma fila puede aparecer varias veces:
set.seed(2)

df %>%
  slice_sample(n = 5, replace = TRUE)
# A tibble: 5 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Jar Jar Binks Gungan 196 66
2 Boba Fett Human 183 78.2
3 Owen Lars Human 178 120
4 Owen Lars Human 178 120
5 R5-D4 Droid 97 32El argumento weight_by asigna a cada fila una probabilidad de ser seleccionada proporcional a una variable. Con weight_by = mass los personajes más pesados tienen más probabilidad de aparecer en la muestra:
set.seed(1)

df %>%
  slice_sample(n = 3, weight_by = mass)
# A tibble: 3 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Anakin Skywalker Human 188 84
2 Roos Tarpals Gungan 224 82
3 Lando Calrissian Human 177 79Por último, con by obtienes una muestra estratificada, es decir, una muestra aleatoria de cada grupo. slice_sample(n = 1, by = species) devuelve un personaje al azar de cada especie. Para muestrear vectores en lugar de filas, utiliza la función sample de R base.
Con by, n es el número de filas por grupo, no el total. Si un grupo tiene menos filas que n, se devuelven todas sus filas sin ningún aviso, así que los grupos pequeños acaban con menos filas que el resto. Por ejemplo, slice_sample(n = 3, by = species) devuelve 8 filas en lugar de 9, porque solo hay dos gungans. Comprueba el tamaño de cada grupo con count() antes de muestrear.
¿Y la función top_n?
En código antiguo encontrarás top_n para obtener las filas con los valores más altos. Esta función está reemplazada por slice_min y slice_max y ya no se recomienda. Además de tener una sintaxis menos intuitiva (un n negativo devuelve los valores más bajos), no ordena el resultado:
df %>%
  top_n(2, mass)
# A tibble: 2 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Darth Vader Human 202 136
2 IG-88 Droid 200 140Darth Vader aparece primero porque aparece antes en los datos, aunque IG-88 pesa más. El código moderno equivalente es slice_max(mass, n = 2), que devuelve primero a IG-88. Lo mismo ocurre con top_frac, que se sustituye por el argumento prop.
Equivalentes en R base
También puedes seleccionar filas por posición sin dplyr. Las primeras y las últimas filas se obtienen con head y tail, y las filas con los valores más altos ordenando los datos con la función order y quedándote con las n primeras:
# Tres primeras filas
head(df, 3)

# Tres personajes más pesados
df[order(df$mass, decreasing = TRUE), ][1:3, ]
# A tibble: 3 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 Luke Skywalker Human 172 77
2 C-3PO Droid 167 75
3 R2-D2 Droid 96 32
# A tibble: 3 × 4
name species height mass
<chr> <chr> <int> <dbl>
1 IG-88 Droid 200 140
2 Darth Vader Human 202 136
3 Owen Lars Human 178 120Ten en cuenta que en R base no se tienen en cuenta los empates: siempre obtienes exactamente tres filas. Para obtener la primera fila de cada grupo en R base puedes utilizar df[!duplicated(df$species), ], como se explica en el tutorial sobre cómo eliminar duplicados.
¿Qué función slice deberías usar?
La siguiente tabla resume las funciones de la familia slice y sus equivalentes en R base:
| Función | Selecciona | Argumentos principales | Equivalente en R base |
|---|---|---|---|
slice() |
Filas por posición | Posiciones positivas o negativas | df[c(1, 3), ], df[-1, ] |
slice_head() |
Primeras filas | n, prop, by |
head() |
slice_tail() |
Últimas filas | n, prop, by |
tail() |
slice_min() |
Filas con los valores más bajos | order_by, n, prop, with_ties, na_rm, by |
df[order(x), ][1:n, ] |
slice_max() |
Filas con los valores más altos | order_by, n, prop, with_ties, na_rm, by |
df[order(-x), ][1:n, ] |
slice_sample() |
Filas aleatorias | n, prop, replace, weight_by, by |
df[sample(nrow(df), n), ] |
En resumen: usa slice cuando conozcas los números de fila, slice_head y slice_tail cuando el orden de los datos tenga sentido, slice_min y slice_max para clasificaciones y para las N primeras filas de cada grupo, y slice_sample para muestras aleatorias.