case_when() e if_else() de dplyr: valores condicionales en R
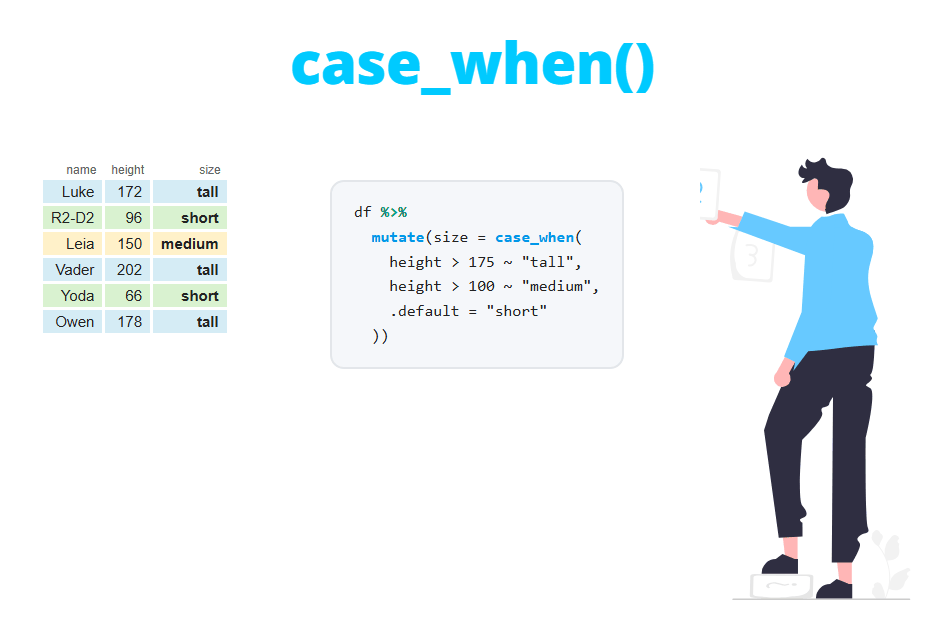
La función case_when de dplyr asigna un valor a cada elemento de un vector en función de varias condiciones, por lo que es la alternativa vectorizada a escribir muchas llamadas a ifelse anidadas. En este tutorial aprenderás su sintaxis, por qué el orden de las condiciones importa, cómo indicar un valor por defecto, cómo trata los NA y cómo resolver los errores de tipo más habituales. También verás en qué se diferencia if_else de la función ifelse de R base y cuándo te conviene usar case_match.
Sintaxis de case_when
Cada argumento de case_when es una fórmula de dos lados: a la izquierda de ~ va una condición lógica y a la derecha el valor que se devuelve cuando esa condición es TRUE. La sintaxis básica es la siguiente:
case_when(
  condicion_1 ~ valor_1,
  condicion_2 ~ valor_2,
  ...,
  .default = valor_por_defecto
)
Las condiciones se evalúan en orden para cada elemento, y el elemento toma el valor de la primera condición que sea TRUE. Los elementos que no cumplen ninguna condición reciben el valor de .default, o NA si no lo indicas.
library(dplyr)

x <- c(5, 12, 18, 25)

case_when(
  x < 10 ~ "bajo",
  x < 20 ~ "medio",
  .default = "alto"
)

# Sin valor por defecto
case_when(
  x < 10 ~ "bajo",
  x < 20 ~ "medio"
)
[1] "bajo" "medio" "medio" "alto"
[1] "bajo" "medio" "medio" NAEn la segunda llamada el valor 25 no cumple ninguna condición, así que el resultado es NA.
Crear categorías dentro de mutate
En la práctica, case_when se utiliza casi siempre dentro de la función mutate para crear una nueva columna categórica. En este tutorial utilizaremos el siguiente data frame con la edad y la nota de un examen de ocho personas. Fíjate en que hay un valor faltante en cada columna numérica.
library(dplyr)

df <- tibble(
  nombre = c("Ana", "Luis", "Marta", "Pedro", "Sara", "Juan", "Elena", "Pablo"),
  edad = c(15, 34, 67, 22, NA, 45, 71, 17),
  nota = c(85, 42, 91, 67, 55, NA, 73, 38)
)

df
# A tibble: 8 × 3
nombre edad nota
<chr> <dbl> <dbl>
1 Ana 15 85
2 Luis 34 42
3 Marta 67 91
4 Pedro 22 67
5 Sara NA 55
6 Juan 45 NA
7 Elena 71 73
8 Pablo 17 38El siguiente código crea una columna grupo_edad con tres categorías utilizando el operador pipe %>%. Dentro de mutate puedes referirte a las columnas directamente por su nombre:
df %>%
  mutate(grupo_edad = case_when(
    edad < 18 ~ "Menor",
    edad < 65 ~ "Adulto",
    .default = "Mayor"
  ))
# A tibble: 8 × 4
nombre edad nota grupo_edad
<chr> <dbl> <dbl> <chr>
1 Ana 15 85 Menor
2 Luis 34 42 Adulto
3 Marta 67 91 Mayor
4 Pedro 22 67 Adulto
5 Sara NA 55 Mayor
6 Juan 45 NA Adulto
7 Elena 71 73 Mayor
8 Pablo 17 38 MenorNo hace falta escribir edad >= 18 & edad < 65 en la segunda condición. Como Ana y Pablo ya cumplieron la primera, nunca se les asigna una posterior. Fíjate también en Sara: su edad es desconocida, pero ha quedado clasificada como "Mayor". En la sección sobre NA verás por qué ocurre y cómo evitarlo.
Orden de las condiciones: gana la primera que se cumple
El error más frecuente con case_when es escribir una condición amplia antes que otra más específica. Como cada elemento toma el valor de la primera condición que es TRUE, la condición específica nunca llega a aplicarse. En el ejemplo siguiente se han intercambiado las condiciones de la sección anterior:
df %>%
  mutate(grupo_edad = case_when(
    edad < 65 ~ "Adulto",
    edad < 18 ~ "Menor",
    .default = "Mayor"
  ))
# A tibble: 8 × 4
nombre edad nota grupo_edad
<chr> <dbl> <dbl> <chr>
1 Ana 15 85 Adulto
2 Luis 34 42 Adulto
3 Marta 67 91 Mayor
4 Pedro 22 67 Adulto
5 Sara NA 55 Mayor
6 Juan 45 NA Adulto
7 Elena 71 73 Mayor
8 Pablo 17 38 AdultoAhora Ana (15) y Pablo (17) son "Adulto", porque 15 y 17 también son menores que 65. R no muestra ningún error ni advertencia, así que es un fallo fácil de pasar por alto. La regla es sencilla: escribe las condiciones de la más específica a la más general y deja el valor comodín para el final.
Una forma rápida de revisar una nueva columna categórica es contar sus valores con count(df, grupo_edad) o cruzarla con la variable original. Si una categoría que debería existir tiene cero filas, probablemente una condición más amplia situada antes está capturando esos elementos.
Valor por defecto: .default o TRUE ~
Desde dplyr 1.1.0, el valor para los elementos que no cumplen ninguna condición se indica con el argumento .default. En código más antiguo encontrarás el equivalente TRUE ~ valor como última condición. Como TRUE siempre es verdadero, recoge todos los elementos que llegan hasta ese punto:
df %>%
  mutate(grupo_edad = case_when(
    edad < 18 ~ "Menor",
    edad < 65 ~ "Adulto",
    TRUE ~ "Mayor"
  ))
# A tibble: 8 × 4
nombre edad nota grupo_edad
<chr> <dbl> <dbl> <chr>
1 Ana 15 85 Menor
2 Luis 34 42 Adulto
3 Marta 67 91 Mayor
4 Pedro 22 67 Adulto
5 Sara NA 55 Mayor
6 Juan 45 NA Adulto
7 Elena 71 73 Mayor
8 Pablo 17 38 MenorEl resultado es el mismo. Usa .default si tu versión de dplyr es la 1.1.0 o posterior (puedes comprobarlo con packageVersion("dplyr")), ya que deja más clara la intención y, a diferencia de TRUE ~, no se puede colocar por error delante de otras condiciones. Mantén TRUE ~ solo si tu código tiene que funcionar en versiones antiguas.
El valor por defecto también puede ser una columna. Esto es útil cuando solo quieres modificar algunos valores y dejar el resto como están. En el siguiente ejemplo las notas faltantes se sustituyen por 0, las notas mayores que 90 se limitan a 90 y los demás valores no cambian:
df %>%
  mutate(nota2 = case_when(
    is.na(nota) ~ 0,
    nota > 90 ~ 90,
    .default = nota
  ))
# A tibble: 8 × 4
nombre edad nota nota2
<chr> <dbl> <dbl> <dbl>
1 Ana 15 85 85
2 Luis 34 42 42
3 Marta 67 91 90
4 Pedro 22 67 67
5 Sara NA 55 55
6 Juan 45 NA 0
7 Elena 71 73 73
8 Pablo 17 38 38Varias condiciones con & y |
Cada condición puede combinar varias variables con los operadores lógicos & (y) y | (o). El siguiente ejemplo clasifica a los alumnos según su nota y su edad. Observa que la condición más restrictiva (nota alta y menor de 18 años) va en primer lugar:
df %>%
  mutate(resultado = case_when(
    nota >= 70 & edad < 18 ~ "Joven talento",
    nota >= 70 ~ "Notable",
    nota >= 50 ~ "Aprobado",
    nota < 50 | is.na(nota) ~ "Suspenso o sin nota"
  ))
# A tibble: 8 × 4
nombre edad nota resultado
<chr> <dbl> <dbl> <chr>
1 Ana 15 85 Joven talento
2 Luis 34 42 Suspenso o sin nota
3 Marta 67 91 Notable
4 Pedro 22 67 Aprobado
5 Sara NA 55 Aprobado
6 Juan 45 NA Suspenso o sin nota
7 Elena 71 73 Notable
8 Pablo 17 38 Suspenso o sin notaReserva && y || para las sentencias if, donde la condición es un único valor. Dentro de case_when necesitas las versiones vectorizadas & y |, porque cada condición se evalúa para toda la columna a la vez.
Cómo trata case_when los valores NA
Cuando una condición da como resultado NA, case_when la trata como FALSE y pasa a la siguiente condición. Por eso Sara, cuya edad es NA, no cumplió edad < 18 ni edad < 65 y terminó en la categoría de .default, "Mayor". Es un error silencioso: la salida no contiene ningún NA que te avise del problema.
La solución es tratar los valores faltantes de forma explícita con is.na en la primera condición:
df %>%
  mutate(grupo_edad = case_when(
    is.na(edad) ~ "Desconocido",
    edad < 18 ~ "Menor",
    edad < 65 ~ "Adulto",
    .default = "Mayor"
  ))
# A tibble: 8 × 4
nombre edad nota grupo_edad
<chr> <dbl> <dbl> <chr>
1 Ana 15 85 Menor
2 Luis 34 42 Adulto
3 Marta 67 91 Mayor
4 Pedro 22 67 Adulto
5 Sara NA 55 Desconocido
6 Juan 45 NA Adulto
7 Elena 71 73 Mayor
8 Pablo 17 38 MenorSi prefieres que los valores faltantes sigan siendo NA, usa is.na(edad) ~ NA como primera condición o escribe la última categoría de forma explícita (edad >= 65 ~ "Mayor") en lugar de usar .default. Consulta el tutorial sobre valores NA en R para ver otras formas de tratarlos.
Un valor .default (o TRUE ~) recoge todo lo que no cumplió las condiciones anteriores, incluidas las filas con NA en las variables de las condiciones. Siempre que tus datos puedan contener valores faltantes, añade una condición con is.na() antes del valor por defecto.
Errores habituales: tipos incompatibles
Todos los valores a la derecha de las fórmulas, y el valor de .default, deben ser de tipos compatibles. Si mezclas una cadena de texto y un número obtendrás el siguiente error:
df %>%
  mutate(grupo_edad = case_when(
    edad < 18 ~ "Menor",
    .default = 0
  ))
Error in `mutate()`:
ℹ In argument: `grupo_edad = case_when(edad < 18 ~ "Menor", .default =
0)`.
Caused by error in `case_when()`:
! Can't combine `..1 (right)` <character> and `.default` <double>.El mensaje te indica qué valores no se pueden combinar: ..1 (right) es el lado derecho de la primera condición (una cadena de texto) y .default es un número. Para solucionarlo, utiliza el mismo tipo en todos los valores, por ejemplo .default = "0" o .default = "Adulto". Los tipos numéricos que se pueden combinar, como enteros y decimales, no producen ningún error: case_when(x < 10 ~ 1L, .default = 2.5) devuelve un vector de tipo double.
NA y NA_character_
En las versiones de dplyr anteriores a la 1.1.0, escribir TRUE ~ NA en un case_when que devolvía texto producía un error que indicaba que el valor debía ser un vector de caracteres y no un vector lógico. La solución era utilizar los valores faltantes con tipo NA_character_, NA_real_ o NA_integer_, que todavía verás en mucho código publicado. Desde dplyr 1.1.0 basta con un NA, ya que se convierte al tipo del resto de valores:
x <- c(5, 12, 18, 25)

case_when(
  x < 10 ~ "bajo",
  x < 20 ~ "medio",
  .default = NA
)
[1] "bajo" "medio" "medio" NAError “Can’t recycle”
Los valores del lado derecho deben tener longitud 1 o la misma longitud que las condiciones. Si pasas un vector de otra longitud obtendrás este error:
case_when(x < 10 ~ c("a", "b"), .default = "c")Error in `case_when()`:
! Can't recycle `..1 (left)` (size 4) to match `..1 (right)` (size 2).Dentro de mutate suele ocurrir cuando utilizas un valor calculado a partir de otro data frame o de un resumen en lugar de una columna de los mismos datos.
case_when o cut para intervalos numéricos
Cuando todas las condiciones son intervalos de una misma variable numérica, la función cut es una alternativa más compacta. El siguiente código crea los mismos tres grupos de edad con ambas funciones. Con right = FALSE los intervalos son cerrados por la izquierda, de modo que 18 es adulto y 65 es mayor, igual que con case_when:
edades <- c(15, 34, 67, 22, 45, 71, 17, 18, 65)

cut(edades, breaks = c(-Inf, 18, 65, Inf),
    labels = c("Menor", "Adulto", "Mayor"), right = FALSE)

case_when(edades < 18 ~ "Menor",
          edades < 65 ~ "Adulto",
          .default = "Mayor")
[1] Menor Adulto Mayor Adulto Adulto Mayor Menor Adulto Mayor
Levels: Menor Adulto Mayor
[1] "Menor" "Adulto" "Mayor" "Adulto" "Adulto" "Mayor" "Menor" "Adulto"
[9] "Mayor"La diferencia está en la salida: cut devuelve un factor con los niveles en el orden de los intervalos, algo muy cómodo para tablas y gráficos, mientras que case_when devuelve un vector de caracteres. Usa cut cuando tengas muchos intervalos de una sola variable y case_when cuando las categorías dependan de varias variables o de condiciones que no son intervalos. Si necesitas un factor a partir de case_when, envuelve el resultado con factor(..., levels = c("Menor", "Adulto", "Mayor")).
if_else frente a ifelse
Cuando solo hay dos resultados posibles puedes utilizar if_else, la versión de dplyr de la función ifelse de R base. Su sintaxis es if_else(condition, true, false, missing = NULL) y en los casos sencillos devuelve el mismo resultado:
x <- c(5, NA, 25)

ifelse(x > 10, "alto", "bajo")
if_else(x > 10, "alto", "bajo")
[1] "bajo" NA "alto"
[1] "bajo" NA "alto"Sin embargo, hay tres diferencias importantes.
Control estricto de tipos
ifelse convierte los valores a un tipo común sin avisar, mientras que if_else da un error si true y false no son compatibles:
ifelse(x > 10, "alto", 0)
if_else(x > 10, "alto", 0)
[1] "0" NA "alto"
Error in `if_else()`:
! Can't combine `true` <character> and `false` <double>.Con ifelse el número 0 se ha convertido en la cadena "0" sin ningún aviso. El error de if_else puede parecer molesto, pero detiene el problema donde empieza en lugar de varios pasos después.
El argumento missing
if_else tiene un argumento missing para indicar el valor que se devuelve cuando la condición es NA. Con ifelse tendrías que anidar otra llamada con is.na:
if_else(x > 10, "alto", "bajo", missing = "desconocido")[1] "bajo" "desconocido" "alto"Conserva clases como las fechas
Esta es la diferencia que más problemas causa en la práctica. ifelse elimina los atributos de los valores, así que una fecha se convierte en el número de días transcurridos desde el 1 de enero de 1970. if_else mantiene la clase de la entrada:
fechas <- as.Date(c("2024-01-15", "2024-06-30", "2024-12-31"))

ifelse(fechas > as.Date("2024-06-01"), fechas, NA)
if_else(fechas > as.Date("2024-06-01"), fechas, NA)
[1] NA 19904 20088
[1] NA "2024-06-30" "2024-12-31"Con los factores ocurre lo mismo: ifelse(f == "a", f, "z") devuelve los códigos enteros internos del factor en lugar de sus etiquetas. Por estos motivos, dentro de un flujo de dplyr utiliza if_else, y case_when en cuanto necesites más de dos resultados.
Recodificar valores con case_match
Cuando las condiciones solo comparan una variable con valores concretos (x == "a", x %in% c("b", "c")), dplyr 1.1.0 ofrece case_match, una alternativa más corta inspirada en el CASE WHEN de SQL. Pasas la variable una sola vez y, a la izquierda de cada ~, el valor o los valores que quieres buscar:
especie <- c("Human", "Droid", "Wookiee", "Human", "Gungan", "Ewok")

case_match(especie,
           "Human" ~ "Humanoide",
           "Droid" ~ "Robot",
           c("Wookiee", "Ewok") ~ "Peludo",
           .default = "Otro")
[1] "Humanoide" "Robot" "Peludo" "Humanoide" "Otro" "Peludo"La llamada equivalente con case_when sería case_when(especie == "Human" ~ "Humanoide", especie == "Droid" ~ "Robot", especie %in% c("Wookiee", "Ewok") ~ "Peludo", .default = "Otro"), que repite la variable en cada condición. En R base puedes hacer algo parecido para un único valor con la función switch, aunque switch no está vectorizada.
¿Qué función deberías usar?
La siguiente tabla resume las alternativas que has visto en este tutorial:
| Función | Paquete | Úsala cuando | Salida |
|---|---|---|---|
if_else() |
dplyr | Dos resultados, tipos estrictos | Mismo tipo que true/false |
ifelse() |
base | Dos resultados, sin dplyr | Tipo común (pierde las clases) |
case_when() |
dplyr | Varias condiciones, una o más variables | Tipo común de los valores |
case_match() |
dplyr | Recodificar valores concretos de una variable | Tipo común de los valores |
cut() |
base | Intervalos numéricos de una variable | Factor |
switch() |
base | Un único valor (no vectorizada) | Cualquier objeto |
Como regla general, empieza por case_when: cubre casi todas las situaciones y el código se lee con facilidad. Recuerda colocar primero las condiciones específicas, tratar los NA de forma explícita y mantener el mismo tipo en todos los valores.