Eliminar duplicados en R con unique(), duplicated() y distinct()
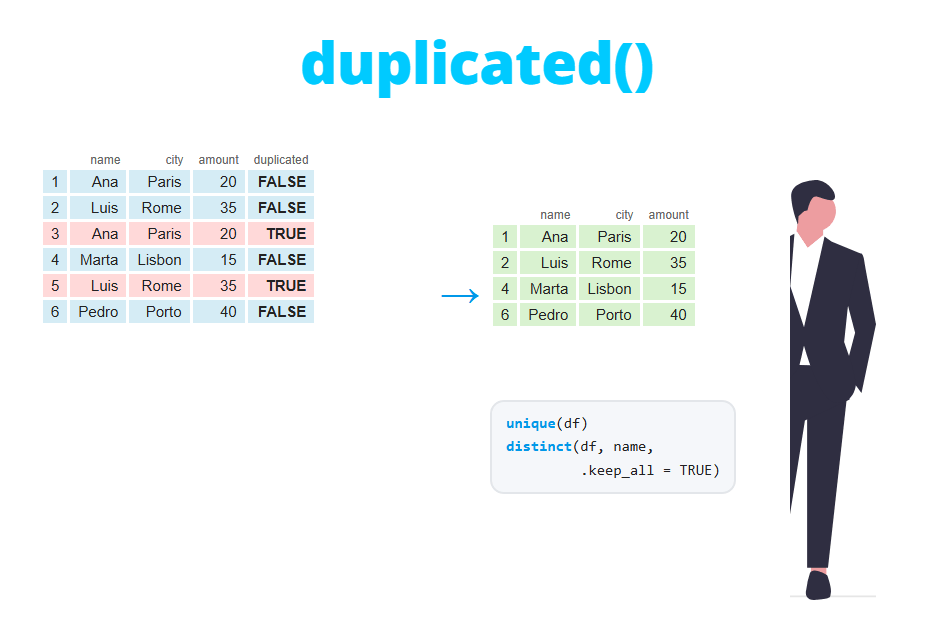
Los valores y filas duplicadas son uno de los problemas más habituales al limpiar datos. En este tutorial aprenderás a eliminar duplicados en R con unique y duplicated, a encontrar y mostrar las filas duplicadas, a eliminar duplicados en base a una o varias columnas conservando la primera o la última aparición, a usar la función distinct de dplyr y a contar valores únicos.
Valores únicos de un vector
La función unique devuelve los elementos de un vector sin repeticiones, en el orden en el que aparecen por primera vez:
x <- c(3, 1, 3, 2, 1, 3)

unique(x)
[1] 3 1 2Fíjate en que la salida no está ordenada. Si quieres los valores únicos en orden ascendente usa sort(unique(x)) (consulta cómo ordenar datos en R).
Cómo funciona la función duplicated
Mientras que unique devuelve los valores, duplicated devuelve un vector lógico que te indica, para cada elemento, si ya había aparecido antes. Esta es la clave para entenderla: la primera aparición de cada valor es FALSE y solo las repeticiones posteriores son TRUE.
x <- c(3, 1, 3, 2, 1, 3)

duplicated(x)
[1] FALSE FALSE TRUE FALSE TRUE TRUEEl primer 3 y el primer 1 son FALSE, mientras que los elementos tercero, quinto y sexto son TRUE porque sus valores ya habían aparecido. En consecuencia:
x[!duplicated(x)]conserva la primera aparición de cada valor (lo mismo queunique(x)).x[duplicated(x)]devuelve los elementos repetidos, tantas veces como se repiten.sum(duplicated(x))cuenta cuántos elementos eliminarías.
x[!duplicated(x)]
x[duplicated(x)]
unique(x[duplicated(x)]) # qué valores se repiten
sum(duplicated(x))
[1] 3 1 2
[1] 3 1 3
[1] 3 1
[1] 3Si solo quieres saber si hay algún duplicado puedes usar any(duplicated(x)) o anyDuplicated(x), que devuelve el índice del primer elemento duplicado (3 en este caso) o 0 si no hay ninguno.
Conservar la última aparición con fromLast
Por defecto los elementos se revisan de izquierda a derecha. Con fromLast = TRUE el vector se revisa de derecha a izquierda, por lo que la última aparición de cada valor es la que se considera “original”:
duplicated(x, fromLast = TRUE)[1] TRUE TRUE TRUE FALSE FALSE FALSEAhora el último 3 (posición 6), el último 1 (posición 5) y el único 2 son FALSE. Esto es útil cuando los datos están ordenados por fecha y quieres conservar el registro más reciente.
Eliminar filas duplicadas de un data frame
Considera el siguiente data frame con compras de varios clientes. Las filas 2 y 3 son idénticas, la fila 7 es una copia de la fila 1 y el cliente 4 aparece dos veces pero con distinta ciudad e importe:
df <- data.frame(
  id      = c(1, 2, 2, 3, 4, 4, 1),
  nombre  = c("Ana", "Luis", "Luis", "Marta", "Pedro", "Pedro", "Ana"),
  ciudad  = c("Madrid", "París", "París", "Roma", "Lisboa", "Oporto", "Madrid"),
  importe = c(120, 80, 80, 200, 50, 75, 120)
)

df
id nombre ciudad importe
1 1 Ana Madrid 120
2 2 Luis París 80
3 2 Luis París 80
4 3 Marta Roma 200
5 4 Pedro Lisboa 50
6 4 Pedro Oporto 75
7 1 Ana Madrid 120Aplicada a un data frame, duplicated compara filas completas: una fila está duplicada solo si todas sus columnas coinciden con una fila anterior.
duplicated(df)

# Filas duplicadas (las que se eliminarían)
df[duplicated(df), ]
[1] FALSE FALSE TRUE FALSE FALSE FALSE TRUE
id nombre ciudad importe
3 2 Luis París 80
7 1 Ana Madrid 120Para eliminarlas, usa unique o filtra con !duplicated. Ambas opciones dan el mismo resultado:
unique(df)

# Equivalente
df[!duplicated(df), ]
id nombre ciudad importe
1 1 Ana Madrid 120
2 2 Luis París 80
4 3 Marta Roma 200
5 4 Pedro Lisboa 50
6 4 Pedro Oporto 75El data frame pasa de 7 a 5 filas. Las dos filas de Pedro se mantienen porque no son duplicados exactos: difieren en ciudad e importe.
Para conservar la última aparición en lugar de la primera, añade fromLast = TRUE. Observa que ahora se conserva la fila 7 en lugar de la fila 1:
df[!duplicated(df, fromLast = TRUE), ] id nombre ciudad importe
3 2 Luis París 80
4 3 Marta Roma 200
5 4 Pedro Lisboa 50
6 4 Pedro Oporto 75
7 1 Ana Madrid 120Eliminar duplicados en base a una o varias columnas
En la práctica es habitual considerar que dos filas están duplicadas si comparten una clave, como el id del cliente, aunque el resto de columnas sean diferentes. En ese caso pasa solo esa columna a duplicated:
# Una fila por id (primera aparición)
df[!duplicated(df$id), ]
id nombre ciudad importe
1 1 Ana Madrid 120
2 2 Luis París 80
4 3 Marta Roma 200
5 4 Pedro Lisboa 50Ahora solo queda una fila de Pedro, la primera (Lisboa). Para varias columnas, selecciona las columnas que forman la clave:
df[!duplicated(df[, c("id", "nombre")]), ] id nombre ciudad importe
1 1 Ana Madrid 120
2 2 Luis París 80
4 3 Marta Roma 200
5 4 Pedro Lisboa 50Cuando eliminas duplicados por una clave y el resto de columnas difieren, estás decidiendo qué información descartar. Aquí, al conservar la primera fila de Pedro se pierde la compra de Oporto. Revisa esas filas antes de eliminarlas, como se muestra en la siguiente sección.
Encontrar y mostrar todas las filas duplicadas
Como duplicated marca la primera aparición como FALSE, df[duplicated(df), ] no muestra todas las copias, solo las repeticiones. Para ver todas las filas que tienen un duplicado, incluida la primera, combina la búsqueda desde el principio y desde el final con el operador OR |:
dup_todas <- duplicated(df) | duplicated(df, fromLast = TRUE)

df[dup_todas, ]
id nombre ciudad importe
1 1 Ana Madrid 120
2 2 Luis París 80
3 2 Luis París 80
7 1 Ana Madrid 120El mismo truco funciona con una columna clave. Es la forma más útil de revisar los registros en conflicto antes de decidir qué hacer con ellos:
dup_id <- duplicated(df$id) | duplicated(df$id, fromLast = TRUE)

df[dup_id, ]
id nombre ciudad importe
1 1 Ana Madrid 120
2 2 Luis París 80
3 2 Luis París 80
5 4 Pedro Lisboa 50
6 4 Pedro Oporto 75
7 1 Ana Madrid 120Con dplyr puedes obtener las mismas filas agrupando por la clave y quedándote con los grupos con más de una fila, o contar cuántas veces aparece cada clave:
library(dplyr)

df %>%
  count(id, nombre) %>%
  filter(n > 1)
id nombre n
1 1 Ana 2
2 2 Luis 2
3 4 Pedro 2Eliminar duplicados con distinct() de dplyr
La función distinct de dplyr es el equivalente de unique para data frames. Sin argumentos elimina las filas duplicadas en todas las columnas:
library(dplyr)

df %>%
  distinct()
id nombre ciudad importe
1 1 Ana Madrid 120
2 2 Luis París 80
3 3 Marta Roma 200
4 4 Pedro Lisboa 50
5 4 Pedro Oporto 75A diferencia de unique, los nombres de fila se vuelven a numerar. Si indicas columnas, distinct las usa para detectar los duplicados, pero solo devuelve esas columnas:
df %>%
  distinct(id, nombre)
id nombre
1 1 Ana
2 2 Luis
3 3 Marta
4 4 PedroPara conservar el resto de columnas, añade .keep_all = TRUE. En ese caso, para cada combinación de la clave se conserva la primera fila:
df %>%
  distinct(id, .keep_all = TRUE)
id nombre ciudad importe
1 1 Ana Madrid 120
2 2 Luis París 80
3 3 Marta Roma 200
4 4 Pedro Lisboa 50Elegir qué fila conservar
distinct no tiene argumento fromLast, pero como siempre conserva la primera fila puedes controlar cuál se queda ordenando los datos con arrange previamente. Por ejemplo, para conservar la compra de mayor importe de cada cliente:
df %>%
  arrange(desc(importe)) %>%
  distinct(id, .keep_all = TRUE)
id nombre ciudad importe
1 3 Marta Roma 200
2 1 Ana Madrid 120
3 2 Luis París 80
4 4 Pedro Oporto 75Ahora la fila de Pedro es la de Oporto (75) en lugar de la de Lisboa (50). Si quieres la última aparición en el orden original, puedes usar group_by y slice_tail(n = 1).
Contar valores únicos
Para saber cuántos valores distintos tiene un vector puedes usar length(unique(x)) en R base o n_distinct de dplyr:
length(unique(df$ciudad))
n_distinct(df$ciudad)
[1] 5
[1] 5n_distinct es más cómoda dentro de summarise y además acepta varios vectores, contando las combinaciones únicas:
df %>%
  summarise(n_ids = n_distinct(id),
            n_ciudades = n_distinct(ciudad))

# Combinaciones únicas de nombre y ciudad
n_distinct(df$nombre, df$ciudad)
n_ids n_ciudades
1 4 5
[1] 5Si necesitas el número de valores únicos de todas las columnas a la vez, usa sapply(df, n_distinct) (o sapply(df, function(x) length(unique(x))) en R base):
sapply(df, n_distinct) id nombre ciudad importe
4 4 5 5NA cuenta como un valor más: length(unique(c(1, NA, 2, NA))) y n_distinct(c(1, NA, 2, NA)) devuelven 3. Usa n_distinct(x, na.rm = TRUE) si no quieres contar los valores faltantes (consulta cómo trabajar con valores NA en R).
Cuántas veces se repite cada valor
El número de valores únicos no te dice cuáles se repiten. Para ello, usa table o count de dplyr, que devuelven la frecuencia de cada valor:
table(df$id)

# Solo los valores repetidos
table(df$id)[table(df$id) > 1]
1 2 3 4
2 2 1 2
1 2 4
2 2 2df %>%
count(ciudad, sort = TRUE) ciudad n
1 Madrid 2
2 París 2
3 Lisboa 1
4 Oporto 1
5 Roma 1Duplicados que R no detecta
unique y duplicated buscan coincidencias exactas. En columnas de texto, las diferencias de mayúsculas y minúsculas o los espacios de más hacen que R los considere valores distintos:
ciudades <- c("Madrid", "madrid", "Madrid ", "París")

unique(ciudades)
unique(tolower(trimws(ciudades)))
[1] "Madrid" "madrid" "Madrid " "París"
[1] "madrid" "parís"Antes de eliminar duplicados en datos reales, normaliza el texto con tolower y trimws, o te quedarás con “duplicados” que no se eliminan.
R base vs dplyr
La siguiente tabla resume las equivalencias entre R base y dplyr:
| Objetivo | R base | dplyr |
|---|---|---|
| Eliminar filas duplicadas | unique(df) o df[!duplicated(df), ] |
distinct(df) |
| Eliminar duplicados por columnas conservando todas las columnas | df[!duplicated(df[, c("a", "b")]), ] |
distinct(df, a, b, .keep_all = TRUE) |
| Conservar la última aparición | df[!duplicated(df$a, fromLast = TRUE), ] |
group_by(a) %>% slice_tail(n = 1) |
| Mostrar todas las filas duplicadas | duplicated(df) combinado con duplicated(df, fromLast = TRUE) |
group_by(a) %>% filter(n() > 1) |
| Comprobar si hay duplicados | anyDuplicated(df) > 0 |
|
| Contar valores únicos | length(unique(x)) |
n_distinct(x) |
| Frecuencia de cada valor | table(x) |
count(df, x) |
En resumen, usa unique o distinct cuando las filas sean copias exactas, duplicated cuando necesites revisar los duplicados o conservar la última aparición, y distinct(..., .keep_all = TRUE) combinada con arrange cuando tengas que decidir qué fila conservar para cada clave.