Test de Levene y test de Bartlett para la homogeneidad de varianzas en R
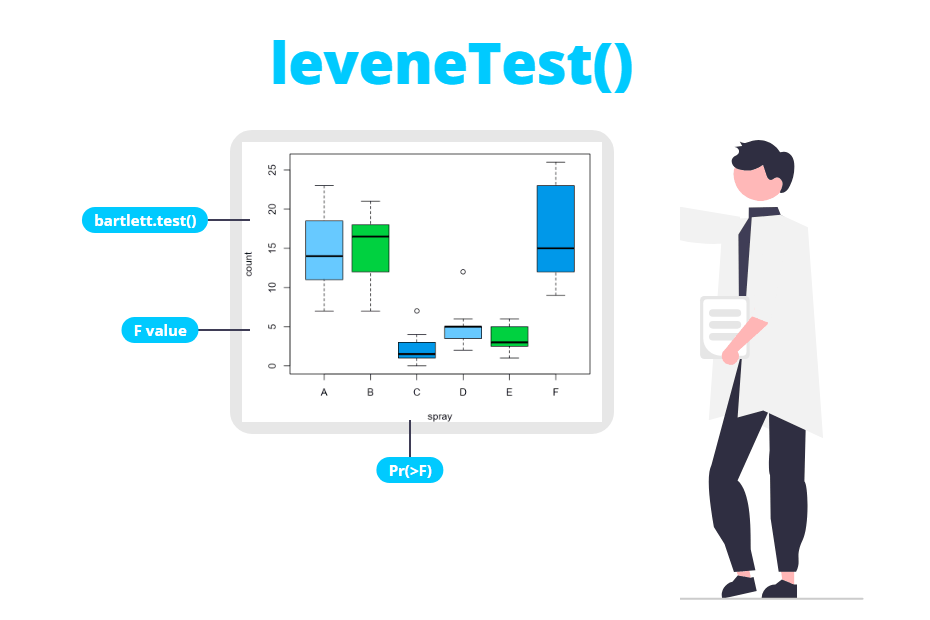
El test de Levene (leveneTest del paquete car) y el test de Bartlett (bartlett.test) comprueban si la varianza de una variable numérica es la misma en dos o más grupos, un supuesto del ANOVA clásico y del t-test con varianzas iguales. En este tutorial aprenderás a realizar ambos contrastes en R, a interpretar su salida, por qué el test de Bartlett puede dar resultados engañosos con datos asimétricos, qué aporta el test de Fligner-Killeen y qué hacer cuando las varianzas no son iguales.
Hipótesis de los contrastes
Los tests de Levene, Bartlett y Fligner-Killeen tienen las mismas hipótesis. Si tienes \(k\) grupos con varianzas poblacionales \(\sigma^2_1, \dots, \sigma^2_k\):
- \(H_0\): \(\sigma^2_1 = \sigma^2_2 = \dots = \sigma^2_k\), todas las varianzas son iguales (homogeneidad de varianzas u homocedasticidad).
- \(H_1\): al menos una varianza es distinta de las demás.
Por lo tanto, un p-valor pequeño (inferior a 0.05) es una mala noticia para el supuesto: indica que hay evidencia de que las varianzas difieren. Un p-valor grande no demuestra que las varianzas sean iguales, solo que los datos no aportan evidencia suficiente en contra.
Si solo tienes dos grupos también puedes usar el test F con var.test, que compara dos varianzas directamente y además permite contrastes unilaterales. Los tests de este tutorial funcionan con cualquier número de grupos.
A lo largo del tutorial utilizaremos el conjunto de datos InsectSprays, que contiene el número de insectos (count) encontrados en parcelas tratadas con seis insecticidas diferentes (spray). Un box plot muestra que la dispersión es muy distinta entre grupos:
boxplot(count ~ spray, data = InsectSprays, col = 4,
        xlab = "Insecticida", ylab = "Número de insectos")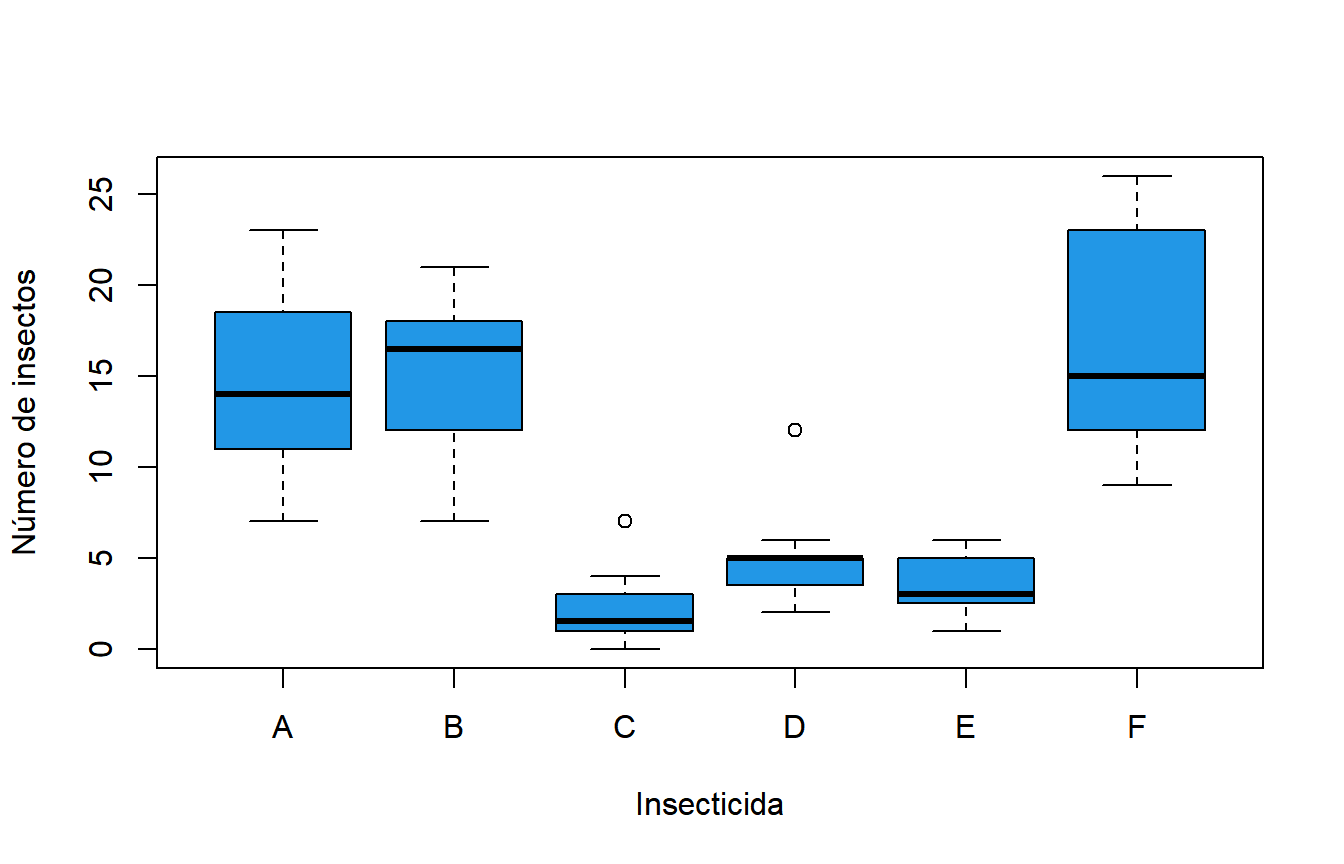
Puedes calcular la varianza muestral de cada grupo con tapply:
tapply(InsectSprays$count, InsectSprays$spray, var) A B C D E F
22.272727 18.242424 3.901515 6.265152 3.000000 38.606061La varianza más grande (insecticida F) es más de diez veces la más pequeña (insecticida E). Veamos si los contrastes confirman que la diferencia es significativa.
Test de Bartlett con bartlett.test
La función bartlett.test forma parte de R base (paquete stats), así que no necesitas instalar nada. Admite una fórmula o una lista de vectores numéricos, uno por grupo:
bartlett.test(formula, data, subset, na.action, ...)

# Datos y grupos como vectores
bartlett.test(x, g, ...)

# Una lista con un vector numérico por grupo
bartlett.test(x, ...)
Con la fórmula, la variable respuesta va a la izquierda y la variable que define los grupos a la derecha:
bartlett.test(count ~ spray, data = InsectSprays) Bartlett test of homogeneity of variances
data: count by spray
Bartlett's K-squared = 25.96, df = 5, p-value = 9.085e-05Si tus datos están en vectores separados, ponlos en una lista. Con split obtienes esa misma lista a partir de un data frame, y el resultado es idéntico:
bartlett.test(split(InsectSprays$count, InsectSprays$spray))

# Equivalente a:
# bartlett.test(list(a, b, c, ...))
Bartlett test of homogeneity of variances
data: split(InsectSprays$count, InsectSprays$spray)
Bartlett's K-squared = 25.96, df = 5, p-value = 9.085e-05La salida contiene:
- Bartlett’s K-squared: el estadístico del contraste. Cuanto más distintas son las varianzas de los grupos, mayor es su valor.
- df: los grados de libertad, el número de grupos menos uno (\(k - 1 = 5\)).
- p-value: se calcula a partir de una distribución chi-cuadrado con \(k - 1\) grados de libertad.
El p-valor (0.00009) es muy inferior a 0.05, por lo que puedes rechazar la hipótesis de igualdad de varianzas.
Bartlett es muy sensible a la falta de normalidad
El test de Bartlett es la opción más potente cuando los datos de cada grupo son normales. El problema es que no distingue entre “varianzas distintas” y “datos no normales”: con distribuciones asimétricas o con colas pesadas rechaza la hipótesis nula con mucha más frecuencia de la que debería, aunque todas las varianzas sean iguales.
Para verlo, simula tres grupos de la misma distribución exponencial. Todos tienen la misma varianza poblacional (igual a 1), pero la distribución exponencial es muy asimétrica a la derecha:
set.seed(8)
df <- data.frame(grupo = gl(3, 30, labels = c("A", "B", "C")),
                 y = rexp(90, rate = 1))

hist(df$y, breaks = 20, col = 4, main = "", xlab = "y", ylab = "Frecuencia")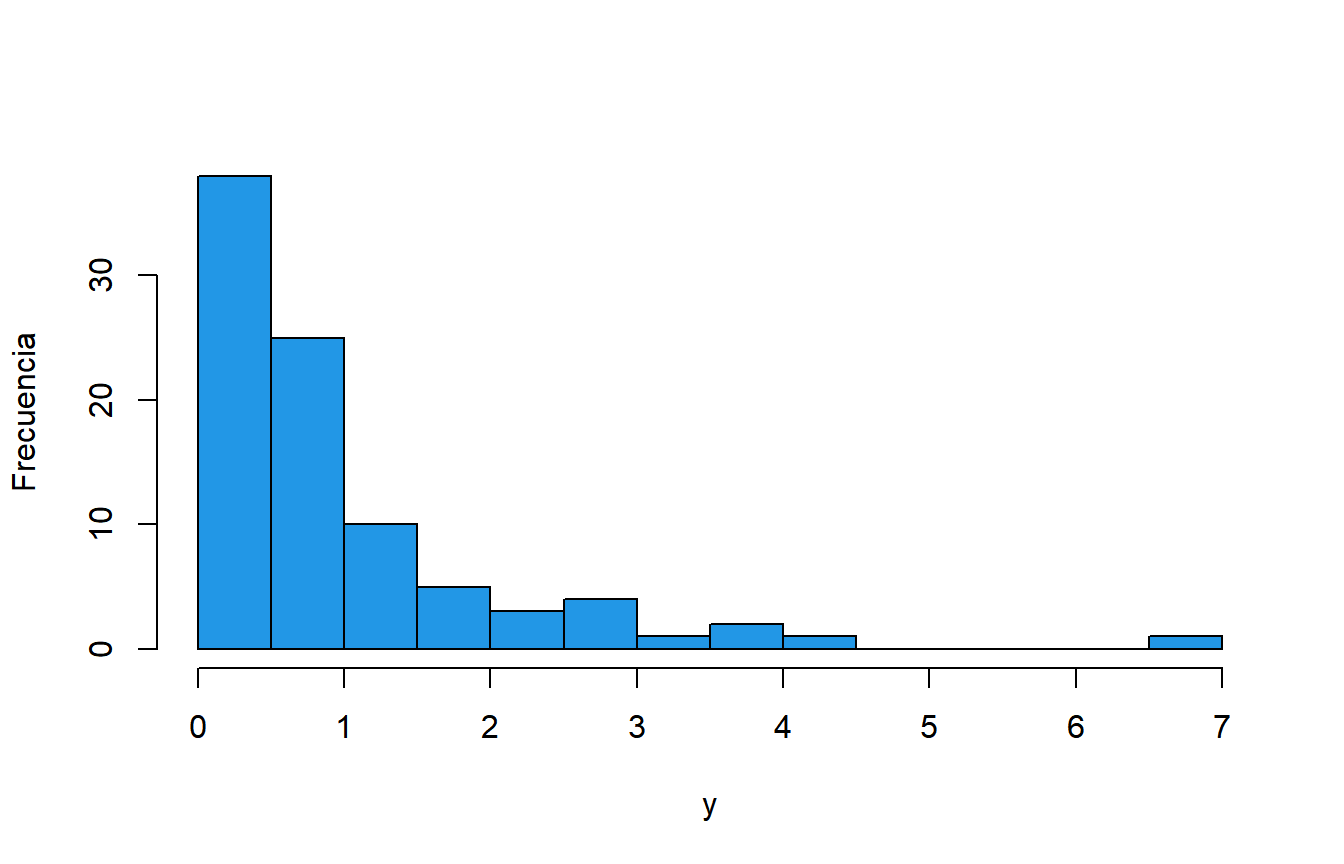
Ahora compara los resultados de ambos tests:
library(car)

bartlett.test(y ~ grupo, data = df)
leveneTest(y ~ grupo, data = df)
Bartlett test of homogeneity of variances
data: y by grupo
Bartlett's K-squared = 11.582, df = 2, p-value = 0.003055
Levene's Test for Homogeneity of Variance (center = median)
Df F value Pr(>F)
group 2 0.6885 0.505
87Bartlett rechaza la igualdad de varianzas (p = 0.003) mientras que Levene no (p = 0.505), y sabemos que en realidad las varianzas son iguales. No se trata de mala suerte con una muestra concreta. Si repites la simulación 1000 veces puedes contar cuántas veces cada test devuelve un p-valor inferior a 0.05:
# Proporción de p-valores < 0.05 cuando todas las varianzas son iguales
set.seed(1)
res <- replicate(1000, {
  g <- gl(3, 30)
  y <- rexp(90)
  c(bartlett = bartlett.test(y ~ g)$p.value < 0.05,
    levene = leveneTest(y ~ g)[1, "Pr(>F)"] < 0.05)
})
rowMeans(res)
bartlett levene
0.382 0.044Con un nivel de significación de 0.05, un test que funcione bien debería rechazar alrededor del 5% de las veces. Levene se queda cerca de esa cifra (4.4%), mientras que Bartlett rechaza el 38% de las veces.
Utiliza el test de Bartlett solo si has comprobado que los datos de cada grupo son aproximadamente normales (por ejemplo, con un gráfico Q-Q o con el test de Shapiro-Wilk). Si no lo tienes claro, usa el test de Levene.
Test de Levene con leveneTest
La función leveneTest pertenece al paquete car, por lo que tendrás que instalarlo una vez con install.packages("car"). Sus argumentos principales son:
library(car)

leveneTest(y, group, center = median, ...)

# Con una fórmula
leveneTest(formula, data, center = median, ...)
Siendo:
y: variable respuesta numérica (o una fórmula comoy ~ grupo).group: el factor que define los grupos.center: la función con la que se calcula el centro de cada grupo,median(por defecto) omean.
La idea del test es sencilla: para cada observación calcula la desviación absoluta respecto al centro de su grupo, \(z_{ij} = |y_{ij} - \tilde{y}_i|\), y después realiza un ANOVA de una vía sobre esas desviaciones. Si un grupo tiene más dispersión, sus desviaciones serán mayores en promedio.
library(car)

leveneTest(count ~ spray, data = InsectSprays)

# Equivalente a:
# leveneTest(InsectSprays$count, InsectSprays$spray)
Levene's Test for Homogeneity of Variance (center = median)
Df F value Pr(>F)
group 5 3.8214 0.004223 **
66
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Cómo interpretar la salida
La salida es una pequeña tabla ANOVA:
- center = median: el encabezado indica qué centro se ha utilizado.
- Df: la primera fila (
group) contiene los grados de libertad de los grupos (\(k - 1 = 5\)) y la segunda los grados de libertad residuales (\(n - k = 72 - 6 = 66\)). - F value: el estadístico F del ANOVA sobre las desviaciones absolutas (3.8214).
- Pr(>F): el p-valor, obtenido de una distribución F con 5 y 66 grados de libertad.
El p-valor es 0.0042 < 0.05, así que el test rechaza la hipótesis nula de igualdad de varianzas, la misma conclusión que con Bartlett.
Puedes comprobar que se trata simplemente de un ANOVA sobre las desviaciones respecto a la mediana de cada grupo con aov:
ins <- InsectSprays
ins$desv <- abs(ins$count - ave(ins$count, ins$spray, FUN = median))

summary(aov(desv ~ spray, data = ins))
Df Sum Sq Mean Sq F value Pr(>F)
spray 5 128.8 25.76 3.821 0.00422 **
Residuals 66 444.8 6.74
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1El valor F y el p-valor coinciden. Si necesitas el p-valor dentro de tu código, el resultado es un data frame, así que puedes extraerlo por posición:
lt <- leveneTest(count ~ spray, data = InsectSprays)
lt[1, "Pr(>F)"]
[1] 0.004222791center = median frente a center = mean
El test original propuesto por Levene utiliza la media de cada grupo como centro. Brown y Forsythe propusieron utilizar la mediana, lo que hace el contraste más robusto cuando los datos son asimétricos. Por eso leveneTest usa center = median por defecto, y muchos programas llaman a esta versión test de Brown-Forsythe.
Para obtener el test de Levene original establece center = mean:
leveneTest(count ~ spray, data = InsectSprays, center = mean)Levene's Test for Homogeneity of Variance (center = mean)
Df F value Pr(>F)
group 5 6.4554 6.104e-05 ***
66
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Aquí ambas versiones rechazan la hipótesis nula, pero pueden no coincidir con muestras pequeñas o asimétricas. Mantén la opción por defecto (mediana) salvo que tengas un motivo para usar la media, y si comparas tus resultados con otro software (SPSS, por ejemplo, muestra la versión basada en la media) comprueba qué centro se ha utilizado.
Error habitual: una variable de grupo numérica
En el conjunto de datos ToothGrowth la dosis (dose) está guardada como número (0.5, 1 y 2). Si la usas como grupo en una fórmula, leveneTest se detiene con un error:
leveneTest(len ~ dose, data = ToothGrowth)Error in leveneTest.formula(len ~ dose, data = ToothGrowth) :
Levene's test is not appropriate with quantitative explanatory variables.Si pasas los vectores directamente el test se ejecuta, pero aparece un aviso que te indica que la variable se ha convertido en factor:
leveneTest(ToothGrowth$len, ToothGrowth$dose)Levene's Test for Homogeneity of Variance (center = median)
Df F value Pr(>F)
group 2 0.6457 0.5281
57
Warning message:
In leveneTest.default(ToothGrowth$len, ToothGrowth$dose) :
ToothGrowth$dose coerced to factor.En este caso el resultado es correcto, pero lo más limpio es convertir tú mismo la variable en factor antes de realizar el test, para asegurarte de que cada valor se trata como un grupo:
tg <- ToothGrowth
tg$dose <- factor(tg$dose)
Test de Fligner-Killeen con fligner.test
El test de Fligner-Killeen es una alternativa no paramétrica disponible en R base. Trabaja con los rangos de las desviaciones absolutas respecto a la mediana, por lo que es robusto frente a la falta de normalidad y a los valores atípicos. Su sintaxis es la misma que la de bartlett.test:
fligner.test(count ~ spray, data = InsectSprays)

# Equivalente a:
# fligner.test(split(InsectSprays$count, InsectSprays$spray))
Fligner-Killeen test of homogeneity of variances
data: count by spray
Fligner-Killeen:med chi-squared = 14.483, df = 5, p-value = 0.01282El p-valor (0.0128) también lleva a rechazar la igualdad de varianzas. Como en el test de Bartlett, el estadístico se compara con una distribución chi-cuadrado con \(k - 1\) grados de libertad. Con los datos asimétricos simulados en la sección anterior tampoco detecta ninguna diferencia:
fligner.test(y ~ grupo, data = df) Fligner-Killeen test of homogeneity of variances
data: y by grupo
Fligner-Killeen:med chi-squared = 0.28484, df = 2, p-value = 0.8673¿Qué test deberías usar?
La siguiente tabla resume las opciones:
| Test | Función | Paquete | Supone normalidad | Cuándo usarlo |
|---|---|---|---|---|
| Bartlett | bartlett.test |
stats | Sí | Datos claramente normales en cada grupo (el más potente) |
| Levene / Brown-Forsythe | leveneTest |
car | No | Opción por defecto, uso general |
| Fligner-Killeen | fligner.test |
stats | No | Asimetría fuerte o valores atípicos, solo R base |
| Test F | var.test |
stats | Sí | Exactamente dos grupos, también unilateral |
Como regla general, usa el test de Levene (con la mediana) por defecto. Recurre a Bartlett solo cuando estés seguro de que los datos son normales, y a Fligner-Killeen cuando haya valores atípicos o no quieras depender de paquetes adicionales.
Con muestras muy grandes estos tests detectan diferencias minúsculas e irrelevantes entre varianzas, y con muestras muy pequeñas tienen poca potencia. Fíjate siempre también en el box plot y en las varianzas de cada grupo: un cociente entre la varianza mayor y la menor inferior a 3 o 4 no suele ser un problema para un ANOVA con grupos de tamaño similar.
Homogeneidad de varianzas con varios factores
En un diseño con dos factores, como el ANOVA de dos vías, las varianzas que hay que comparar son las de cada combinación de niveles de los factores. leveneTest admite una fórmula con varios factores y construye los grupos a partir de todas las combinaciones (recuerda convertir antes dose en factor):
tg <- ToothGrowth
tg$dose <- factor(tg$dose)

leveneTest(len ~ supp * dose, data = tg)
Levene's Test for Homogeneity of Variance (center = median)
Df F value Pr(>F)
group 5 1.7086 0.1484
54Hay \(2 \times 3 = 6\) grupos, así que el test tiene 5 y 54 grados de libertad. El p-valor (0.1484) no aporta evidencia en contra de la igualdad de varianzas.
bartlett.test y fligner.test solo admiten una variable de agrupación. Si escribes len ~ supp * dose obtendrás el error 'formula' should be of the form response ~ group. La solución es crear los grupos combinados con interaction:
bartlett.test(len ~ interaction(supp, dose), data = tg) Bartlett test of homogeneity of variances
data: len by interaction(supp, dose)
Bartlett's K-squared = 6.9273, df = 5, p-value = 0.2261Qué hacer si las varianzas no son iguales
Rechazar la homogeneidad de varianzas no significa que no puedas comparar los grupos, solo que debes usar un método que no suponga varianzas iguales:
- Dos grupos: usa el t-test de Welch. Es la opción por defecto de
t.test(var.equal = FALSE), así que basta con no establecervar.equal = TRUE. Consulta el tutorial del t-test para más detalles. - Tres o más grupos: usa el ANOVA de Welch con
oneway.test, tal y como se explica en el tutorial de ANOVA. - Datos asimétricos o con valores atípicos: una transformación de la respuesta (como el logaritmo o la raíz cuadrada) suele estabilizar las varianzas. El test de Kruskal-Wallis es otra opción, pero ten en cuenta que también se ve afectado cuando las formas de los grupos son muy diferentes.
Para los datos de InsectSprays, donde todos los tests rechazaron la igualdad de varianzas, el ANOVA de Welch es:
oneway.test(count ~ spray, data = InsectSprays) One-way analysis of means (not assuming equal variances)
data: count and spray
F = 36.065, num df = 5.000, denom df = 30.043, p-value = 7.999e-12El p-valor es prácticamente cero, por lo que hay una fuerte evidencia de que el número medio de insectos no es el mismo para todos los insecticidas, y esta conclusión no depende del supuesto de igualdad de varianzas.