seq() y rep() en R: crear secuencias y repetir vectores
Crear secuencias de números y repetir valores son dos de las tareas más habituales en R. En este tutorial aprenderás a usar el operador :, la función seq y sus versiones rápidas seq_len y seq_along, y la función rep con sus argumentos times, each y length.out. También verás los errores que provocan más fallos: la precedencia de :, la sorpresa de los decimales en coma flotante con seq y el bucle 1:length(x) sobre un vector vacío.
El operador :
La forma más rápida de crear una secuencia de números en R es el operador :, que devuelve todos los valores desde el primer número hasta el segundo de 1 en 1:
1:10
5:1    # Secuencia decreciente
-2:2
1.5:4  # De 1 en 1, se para antes de pasar de 4
[1] 1 2 3 4 5 6 7 8 9 10
[1] 5 4 3 2 1
[1] -2 -1 0 1 2
[1] 1.5 2.5 3.5Fíjate en que si el primer valor es mayor que el segundo, : cuenta hacia atrás en lugar de devolver un vector vacío. A veces es útil, pero también es el origen del error en bucles que verás más adelante. Cuando los dos valores son enteros, el resultado es un vector de tipo entero.
Precedencia del operador :
El operador : tiene más precedencia que los operadores aritméticos +, -, * y /, pero menos que ^ y el signo menos unario. Esto significa que 1:n-1 no es “de 1 a n - 1”, sino “la secuencia de 1 a n, menos 1”:
n <- 5

1:n-1    # (1:n) - 1
1:(n-1)  # Lo que probablemente querías
[1] 0 1 2 3 4
[1] 1 2 3 4Lo mismo ocurre con otras operaciones. Fíjate en los siguientes ejemplos:
2*1:3    # 2 * (1:3)
-1:3     # (-1):3, el menos se aplica antes al 1
-(1:3)
1:n^2    # 1:(n^2), la potencia va primero
[1] 2 4 6
[1] -1 0 1 2 3
[1] -1 -2 -3
[1] 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25Cuando los límites de una secuencia son expresiones, usa siempre paréntesis: 1:(n - 1), (i + 1):n. No cuestan nada y evitan el error más frecuente con :. Tienes la tabla completa de precedencias en el tutorial de operadores en R.
La función seq
Cuando necesitas un paso distinto de 1 o un número fijo de valores, usa la función seq. Su sintaxis es la siguiente:
seq(from = 1,        # Valor inicial
    to = 1,          # Valor final
    by,              # Incremento de la secuencia
    length.out,      # Longitud deseada de la secuencia
    along.with)      # Toma la longitud de este objeto
Lo normal es indicar from, to y uno de los dos argumentos by o length.out. Si indicas todos, R devolverá el error too many arguments, porque la secuencia estaría sobredeterminada.
Secuencias con un paso dado: by
El argumento by fija el incremento entre valores consecutivos. La secuencia empieza en from y termina en el último valor que no supera to:
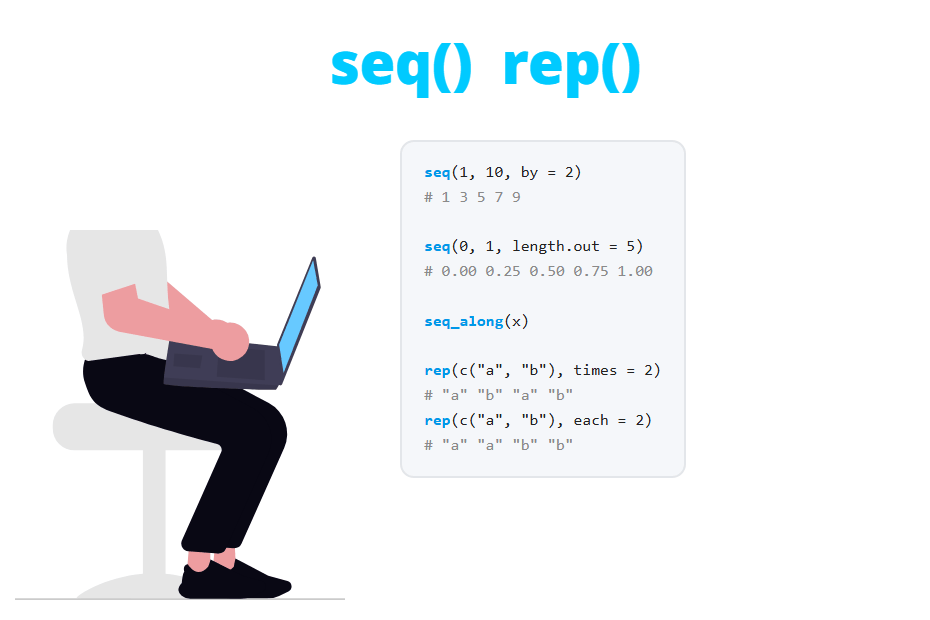
seq(1, 10, by = 2)
seq(0, 100, by = 25)
seq(1, 10, by = 4)   # No llega al 10
[1] 1 3 5 7 9
[1] 0 25 50 75 100
[1] 1 5 9Para una secuencia decreciente el paso tiene que ser negativo. Si pones un by positivo cuando from es mayor que to, R da un error:
seq(10, 1, by = -3)
seq(10, 1, by = 3)
[1] 10 7 4 1
Error in seq.default(10, 1, by = 3) : wrong sign in 'by' argumentSin by, seq(10, 1) funciona como 10:1 y cuenta hacia atrás de 1 en 1.
Secuencias con una longitud dada: length.out
A veces no te importa el paso, sino el número de valores. En ese caso usa length.out (puedes abreviarlo como length) y R calculará el paso por ti:
seq(0, 1, length.out = 5)
seq(2, 20, length.out = 4)
seq(1, 2, length.out = 4)
[1] 0.00 0.25 0.50 0.75 1.00
[1] 2 8 14 20
[1] 1.000000 1.333333 1.666667 2.000000Con length.out los dos extremos se incluyen siempre, algo que con by no está garantizado. Es la opción que te interesa cuando creas una rejilla de valores para un gráfico.
Secuencias con decimales y la sorpresa de la coma flotante
Puedes crear secuencias con pasos decimales, pero ten cuidado cuando compares el resultado con otros números. La siguiente secuencia parece perfecta, pero ninguno de sus elementos es igual a 0.3:
x <- seq(0, 1, by = 0.1)
x

x[4]
x[4] == 0.3
which(x == 0.3)
[1] 0.0 0.1 0.2 0.3 0.4 0.5 0.6 0.7 0.8 0.9 1.0
[1] 0.3
[1] FALSE
integer(0)El motivo es que números como 0.1 no se pueden representar de forma exacta en binario, así que seq acumula pequeños errores. R muestra el valor redondeado, pero si pides más dígitos puedes ver el valor real:
print(x[4], digits = 17)[1] 0.30000000000000004Para comparar números decimales usa una tolerancia, redondea antes los valores o utiliza all.equal:
which(abs(x - 0.3) < 1e-8)       # Tolerancia
which(round(x, 10) == 0.3)       # Redondeo
isTRUE(all.equal(x[4], 0.3))     # all.equal
[1] 4
[1] 4
[1] TRUEseq con un único argumento tiene un comportamiento confuso. seq(10) devuelve 1:10, pero si le pasas un vector de longitud mayor que 1 devuelve sus índices: seq(c(2, 7)) devuelve 1 2, no los números del 2 al 7. Si x puede tener uno o varios elementos, seq(x) se comportará de forma distinta según su longitud. Usa seq_len o seq_along en su lugar.
Las funciones seq_len y seq_along
seq_len(n) crea la secuencia de enteros de 1 a n, y seq_along(x) crea la secuencia de 1 a la longitud de x. Son más rápidas que seq y, sobre todo, tratan bien el caso de longitud 0:
seq_len(5)
seq_len(0)

x <- c(10, 20, 30)
seq_along(x)
[1] 1 2 3 4 5
integer(0)
[1] 1 2 3Fíjate en que seq_len(0) devuelve un vector vacío, mientras que 1:0 devuelve 1 0. Esa diferencia es el motivo para preferir estas funciones.
El error de 1:length(x) en los bucles for
Mucha gente escribe los bucles for con for (i in 1:length(x)). Funciona mientras x tenga al menos un elemento, pero si x está vacío el bucle se ejecuta dos veces, con i = 1 e i = 0:
x <- numeric(0) # Vector vacío

length(x)
for (i in 1:length(x)) {
  print(paste("Iteración", i, "- valor:", x[i]))
}
[1] 0
[1] "Iteración 1 - valor: NA"
[1] "Iteración 0 - valor: "En un script real el cuerpo del bucle trabajaría con un NA y con un elemento vacío, y el error (o el resultado incorrecto) aparecería lejos de su causa. Con seq_along el bucle simplemente no se ejecuta cuando el vector está vacío, y funciona con normalidad en el resto de casos:
x <- numeric(0)
for (i in seq_along(x)) {
  print(paste("Iteración", i, "- valor:", x[i]))
}

x <- c(4, 7, 1)
for (i in seq_along(x)) {
  print(paste("Iteración", i, "- valor:", x[i]))
}
[1] "Iteración 1 - valor: 4"
[1] "Iteración 2 - valor: 7"
[1] "Iteración 3 - valor: 1"Lo mismo pasa con las filas de un data frame. Un filtro puede devolver cero filas sin que te des cuenta. Por ejemplo, ningún día de airquality tiene una temperatura superior a 100 ºF:
calor <- subset(airquality, Temp > 100)
nrow(calor)

1:nrow(calor)        # Mal: recorre las filas 1 y 0
seq_len(nrow(calor)) # Bien: ninguna iteración
[1] 0
[1] 1 0
integer(0)Regla práctica: usa seq_along(x) para recorrer los elementos de un vector o una lista, y seq_len(nrow(df)) o seq_len(n) cuando lo que tienes es un número.
La función rep
La función rep repite los elementos de un vector o de una lista. Su sintaxis es la siguiente:
rep(x,          # Vector o lista a repetir
    times,      # Número de veces que se repite el vector entero (o cada elemento)
    each,       # Número de veces que se repite cada elemento
    length.out) # Longitud deseada del resultado
La diferencia entre times y each está en el orden del resultado: times repite el vector entero, mientras que each repite cada elemento antes de pasar al siguiente.
rep(1:3, times = 2)
rep(1:3, each = 2)
[1] 1 2 3 1 2 3
[1] 1 1 2 2 3 3Como times es el segundo argumento, rep(1:3, 2) es lo mismo que rep(1:3, times = 2). Aun así, escribe el nombre del argumento: cuando vuelvas al código lo entenderás mucho mejor.
Un número de repeticiones distinto para cada elemento
Si times es un vector con la misma longitud que x, cada elemento se repite el número de veces correspondiente. Es muy útil para crear grupos de distinto tamaño:
rep(1:3, times = c(3, 1, 2))
rep(c("A", "B"), times = c(3, 2))
[1] 1 1 1 2 3 3
[1] "A" "A" "A" "B" "B"Combinar each, times y length.out
Puedes combinar each y times. En ese caso R aplica primero each y después repite el resultado times veces. Con length.out el resultado se corta (o se recicla) hasta la longitud deseada:
rep(1:3, each = 2, times = 2)
rep(1:3, length.out = 7)
[1] 1 1 2 2 3 3 1 1 2 2 3 3
[1] 1 2 3 1 2 3 1length.out es práctico cuando la longitud del resultado no depende del número de repeticiones, por ejemplo, para crear un patrón alterno en un vector de 7 elementos. Si indicas length.out, el argumento times se ignora.
Repetir caracteres y factores para crear grupos
rep funciona con cualquier tipo de vector, no solo con números. Un caso típico es crear la columna de grupo de un conjunto de datos, como en un diseño experimental con 3 grupos y 2 réplicas:
data.frame(grupo = rep(c("ctrl", "trt1", "trt2"), each = 2),
           replica = rep(1:2, times = 3))
grupo replica
1 ctrl 1
2 ctrl 2
3 trt1 1
4 trt1 2
5 trt2 1
6 trt2 2Fíjate en cómo trabajan juntos each y times: el grupo cambia cada 2 filas y el número de réplica va 1, 2, 1, 2… Si repites un factor, el resultado conserva los niveles:
f <- factor(c("bajo", "alto", "bajo"), levels = c("bajo", "alto"))
rep(f, times = 2)
[1] bajo alto bajo bajo alto bajo
Levels: bajo altoPara crear directamente un factor de grupos también tienes la función gl (generate levels), que equivale a factor(rep(..., each = ...)):
gl(3, 2, labels = c("ctrl", "trt1", "trt2"))[1] ctrl ctrl trt1 trt1 trt2 trt2
Levels: ctrl trt1 trt2Invertir una secuencia con rev
Para invertir el orden de una secuencia (o de cualquier vector) usa rev. Es la opción más sencilla cuando ya tienes la secuencia y no quieres reescribir la llamada a seq:
rev(1:5)
rev(seq(0, 1, by = 0.25))
[1] 5 4 3 2 1
[1] 1.00 0.75 0.50 0.25 0.00Ten en cuenta que rev solo invierte el orden de los elementos. Si quieres ordenarlos de mayor a menor, usa sort con decreasing = TRUE.
Casos de uso habituales
Crear datos de ejemplo
Combinando seq_len, rep y un generador aleatorio puedes crear en pocas líneas un conjunto de datos pequeño para probar tu código. Recuerda fijar una semilla si quieres obtener siempre los mismos valores:
set.seed(1)
datos <- data.frame(id = seq_len(6),
                    grupo = rep(c("A", "B"), each = 3),
                    valor = round(rnorm(6, mean = 10, sd = 2), 1))
datos
id grupo valor
1 1 A 8.7
2 2 A 10.4
3 3 A 8.3
4 4 B 13.2
5 5 B 10.7
6 6 B 8.4También puedes construir identificadores combinando una secuencia con paste0, por ejemplo paste0("ID_", seq_len(5)), que devuelve "ID_1" "ID_2" "ID_3" "ID_4" "ID_5".
Rejilla de valores para dibujar una curva
Para dibujar una función matemática o una densidad, como las de la distribución normal o la distribución F, necesitas una rejilla de valores para el eje X. Usa seq con length.out, porque el número de puntos determina lo suave que se ve la curva:
x_gruesa <- seq(-3, 3, length.out = 7)
x_fina <- seq(-3, 3, length.out = 200)

plot(x_fina, dnorm(x_fina), type = "l", lwd = 2, col = "blue",
     xlab = "x", ylab = "Densidad")
lines(x_gruesa, dnorm(x_gruesa), type = "b", lwd = 2, col = "red", pch = 19)
legend("topright", legend = c("length.out = 200", "length.out = 7"),
       col = c("blue", "red"), lwd = 2, box.lty = 0)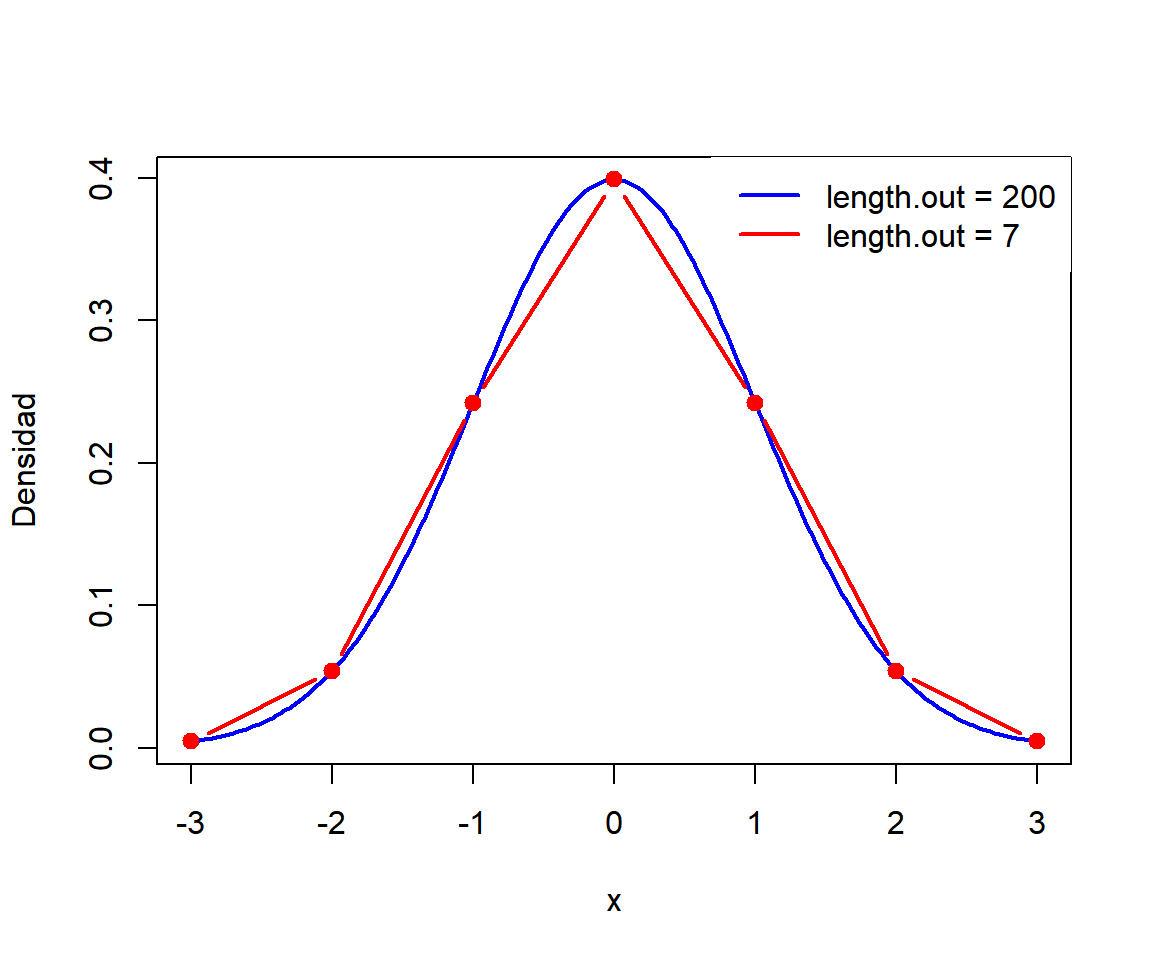
Con 7 puntos la curva es un polígono. Para la mayoría de gráficos bastan entre 100 y 500 puntos.
seq también funciona con fechas. Por ejemplo, seq(as.Date("2026-01-01"), by = "month", length.out = 4) devuelve el primer día de los cuatro primeros meses de 2026. Puedes aprender más en el tutorial de fechas en R.
¿Qué función deberías usar?
En la siguiente tabla tienes un resumen de las opciones para crear secuencias y repeticiones en R:
| Código | Resultado | Cuándo usarlo |
|---|---|---|
1:5 |
1 2 3 4 5 | Secuencias rápidas de enteros con límites fijos |
seq(1, 10, by = 3) |
1 4 7 10 | Un paso dado, incluso decimal o negativo |
seq(0, 1, length.out = 5) |
0 0.25 0.5 0.75 1 | Un número de valores dado, como rejillas para gráficos |
seq_len(n) |
1 … n (vacío si es 0) | Bucles e índices cuando tienes un número |
seq_along(x) |
1 … length(x) | Bucles sobre los elementos de un vector o lista |
rep(x, times = 2) |
1 2 3 1 2 3 | Repetir el vector entero |
rep(x, each = 2) |
1 1 2 2 3 3 | Repetir cada elemento (etiquetas de grupo) |
rep(x, length.out = 7) |
1 2 3 1 2 3 1 | Reciclar un patrón hasta una longitud fija |
rev(x) |
3 2 1 | Invertir el orden de un vector existente |
En la tabla, x es 1:3. Como regla general, usa : solo con límites constantes, seq_len y seq_along en bucles y funciones, y seq cuando necesites un paso o una longitud distintos de los de por defecto.