Distribución chi-cuadrado en R
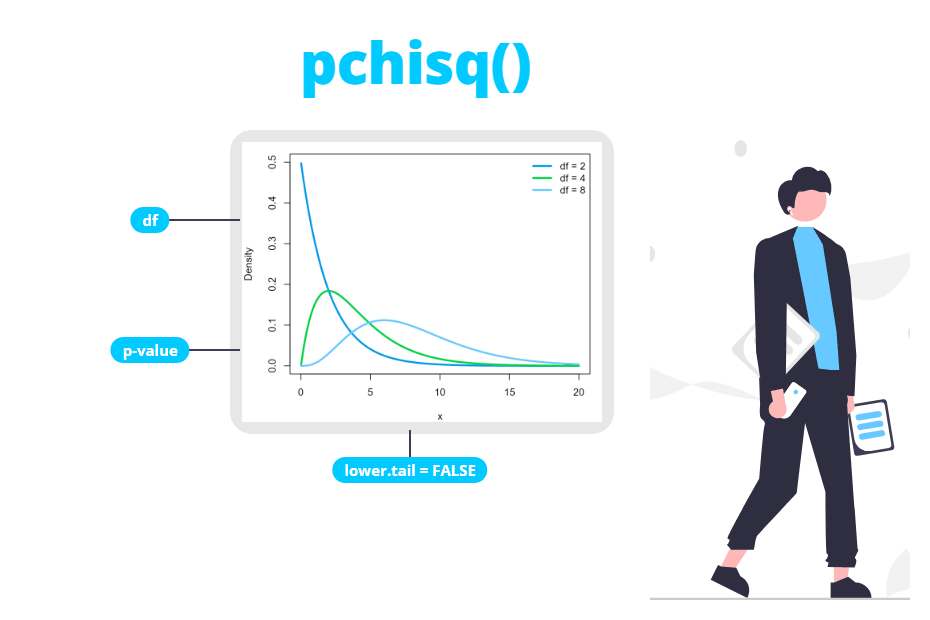
La distribución chi-cuadrado (\(\chi^2\)) es la distribución de referencia de los test chi-cuadrado y del intervalo de confianza para la varianza. En este tutorial aprenderás a usar las funciones dchisq, pchisq, qchisq y rchisq en R, a obtener el p-valor a partir de un estadístico chi-cuadrado (evitando el error más común), a calcular valores críticos de la chi-cuadrado y a construir un intervalo de confianza para la varianza a mano.
La distribución chi-cuadrado
Si \(Z_1, Z_2, \dots, Z_k\) son variables aleatorias normales estándar independientes, la suma de sus cuadrados
\[X = Z_1^2 + Z_2^2 + \dots + Z_k^2\]
sigue una distribución chi-cuadrado con \(k\) grados de libertad (gl), lo que se denota como \(X \sim \chi^2_k\). Los grados de libertad son el único parámetro de la distribución. Además:
- Solo toma valores no negativos, ya que es una suma de cuadrados.
- Es asimétrica a la derecha, y la asimetría disminuye al aumentar los grados de libertad.
- La esperanza y la varianza son \(E(X) = k\) y \(Var(X) = 2k\).
- Con muchos grados de libertad se aproxima a una normal de media \(k\) y varianza \(2k\).
Esta distribución está detrás del test chi-cuadrado de Pearson, del estadístico del test de Kruskal-Wallis y del intervalo de confianza para la varianza de una población normal. En R, las funciones relacionadas con la distribución chi-cuadrado son las siguientes:
| Función | Descripción | Uso habitual |
|---|---|---|
| dchisq | Densidad chi-cuadrado (Función de densidad de probabilidad) |
Dibujar la curva |
| pchisq | Distribución chi-cuadrado (Función de distribución acumulada) |
p-valores |
| qchisq | Función cuantil de la distribución chi-cuadrado | Valores críticos e intervalos de confianza |
| rchisq | Generación de números pseudoaleatorios chi-cuadrado |
Simulación |
La función dchisq
La función dchisq devuelve la densidad de la distribución chi-cuadrado. Su sintaxis es la siguiente:
dchisq(x,           # Vector de valores (cuantiles)
       df,          # Grados de libertad (no negativos, pueden ser no enteros)
       ncp = 0,     # Parámetro de no centralidad
       log = FALSE) # Si es TRUE, las densidades se devuelven en logaritmo
Por ejemplo, la densidad de una chi-cuadrado con 3 grados de libertad en 0.5, 1, 2 y 5 es:
dchisq(c(0.5, 1, 2, 5), df = 3)[1] 0.21969564 0.24197072 0.20755375 0.07322491Recuerda que una densidad no es una probabilidad. Por ejemplo, dchisq(0, df = 1) devuelve Inf, porque la curva con 1 grado de libertad tiende a infinito en el cero, mientras que con 2 gl la densidad en cero es 0.5 y con 3 o más gl es 0.
Dibujar la distribución chi-cuadrado en R
La forma de la distribución cambia mucho con los grados de libertad. El siguiente código dibuja la densidad para 1, 2, 3, 5 y 10 grados de libertad con un bucle for:
# Rejilla de valores del eje X
x <- seq(0, 20, length = 300)

gl <- c(1, 2, 3, 5, 10)
cols <- c("red", "orange", "darkgreen", "blue", "purple")

# Gráfico vacío
plot(x, dchisq(x, df = 1), type = "n", ylim = c(0, 0.5),
     xlab = "x", ylab = "Densidad")

# Una línea para cada valor de gl
for (i in seq_along(gl)) {
  lines(x, dchisq(x, df = gl[i]), lwd = 2, col = cols[i])
}

legend("topright", legend = paste("gl =", gl), col = cols,
       lwd = 2, box.lty = 0)
Con 1 y 2 grados de libertad la densidad es decreciente. A partir de 3 gl la curva tiene un máximo (la moda es \(k - 2\)) y, a medida que \(k\) aumenta, se desplaza a la derecha y se vuelve más simétrica.
La función pchisq
La función pchisq devuelve la función de distribución acumulada, \(P(X \leq q)\). Con lower.tail = FALSE obtienes la cola superior, \(P(X > q)\).
pchisq(q,                 # Vector de cuantiles
       df,                # Grados de libertad
       ncp = 0,           # Parámetro de no centralidad
       lower.tail = TRUE, # Si es TRUE, P(X <= q); si no, P(X > q)
       log.p = FALSE)     # Si es TRUE, las probabilidades se devuelven en logaritmo
Por ejemplo, la probabilidad de que una chi-cuadrado con 3 gl sea menor o igual que 3 y la probabilidad de que sea mayor que 3:
pchisq(3, df = 3)                     # P(X <= 3)
pchisq(3, df = 3, lower.tail = FALSE) # P(X > 3)
[1] 0.6083748
[1] 0.3916252p-valor a partir del estadístico chi-cuadrado
En los test chi-cuadrado, los valores grandes del estadístico son evidencia en contra de la hipótesis nula, así que el p-valor es siempre la probabilidad de la cola superior, \(P(X > \chi^2_{obs})\).
Considera el ejemplo del test chi-cuadrado de independencia entre el precio y la calidad de 100 productos:
datos <- matrix(c(40, 20, 10, 30), nrow = 2)
rownames(datos) <- c("Precio alto", "Precio bajo")
colnames(datos) <- c("Calidad alta", "Calidad baja")

chi <- chisq.test(datos)
chi
Pearson's Chi-squared test with Yates' continuity correction
data: datos
X-squared = 15.042, df = 1, p-value = 0.0001052Puedes acceder al estadístico y a los grados de libertad con chi$statistic y chi$parameter y calcular el p-valor con pchisq:
# Cola superior: P(X > estadístico)
pchisq(chi$statistic, df = chi$parameter, lower.tail = FALSE)
X-squared
0.0001051636El resultado es el mismo p-valor que devuelve chisq.test. Esto te será útil cuando solo tengas el estadístico, por ejemplo, de un artículo o de otro software, y necesites el p-valor.
El error más común es olvidar lower.tail = FALSE. pchisq(15.042, df = 1) devuelve 0.9998949, que es uno menos el p-valor, y te llevaría a la conclusión contraria. A diferencia del t-test, no tienes que multiplicar por 2: los test chi-cuadrado son unilaterales por construcción.
La función qchisq
La función qchisq es la inversa de pchisq: devuelve el valor \(q\) que deja una probabilidad \(p\) a su izquierda. Sus usos principales son los valores críticos y los intervalos de confianza.
qchisq(p,                 # Vector de probabilidades
       df,                # Grados de libertad
       ncp = 0,           # Parámetro de no centralidad
       lower.tail = TRUE, # Si es TRUE, P(X <= x); si no, P(X > x)
       log.p = FALSE)     # Si es TRUE, las probabilidades se dan en logaritmo
Valores críticos de la chi-cuadrado
Como la región de rechazo de un test chi-cuadrado está en la cola superior, el valor crítico para un nivel de significación \(\alpha\) es el cuantil \(1 - \alpha\):
qchisq(0.95, df = 1)                     # alpha = 0.05, gl = 1
qchisq(0.05, df = 1, lower.tail = FALSE) # Equivalente
qchisq(0.95, df = 3)                     # alpha = 0.05, gl = 3
[1] 3.841459
[1] 3.841459
[1] 7.814728Fíjate en que \(3.841 = 1.96^2\): con un grado de libertad la chi-cuadrado es el cuadrado de una normal estándar, así que qchisq(0.95, 1) es igual a qnorm(0.975)^2.
Veamos cómo usar el valor crítico en un test de bondad de ajuste. Supón que 100 clientes eligieron entre cuatro colores de un producto y quieres contrastar si todos los colores son igual de populares:
obs <- c(25, 18, 22, 35)
chisq.test(obs)
Chi-squared test for given probabilities
data: obs
X-squared = 6.32, df = 3, p-value = 0.09704El estadístico (6.32) es menor que el valor crítico con 3 gl (7.815), así que no rechazas la hipótesis nula al 5%. Los dos enfoques llevan siempre a la misma decisión: estadístico mayor que el valor crítico equivale a p-valor menor que \(\alpha\).
El siguiente código crea una tabla con los valores críticos para varios grados de libertad y niveles de significación:
gl <- c(1:10, 15, 20, 30)
alpha <- c(0.10, 0.05, 0.01)

crit <- sapply(alpha, function(a) qchisq(1 - a, df = gl))
dimnames(crit) <- list(gl = gl, alpha = alpha)
round(crit, 3)
alpha
gl 0.1 0.05 0.01
1 2.706 3.841 6.635
2 4.605 5.991 9.210
3 6.251 7.815 11.345
4 7.779 9.488 13.277
5 9.236 11.070 15.086
6 10.645 12.592 16.812
7 12.017 14.067 18.475
8 13.362 15.507 20.090
9 14.684 16.919 21.666
10 15.987 18.307 23.209
15 22.307 24.996 30.578
20 28.412 31.410 37.566
30 40.256 43.773 50.892Intervalo de confianza para la varianza
Si los datos proceden de una población normal, \((n-1)s^2/\sigma^2\) sigue una distribución chi-cuadrado con \(n - 1\) grados de libertad. Por tanto, el intervalo de confianza para la varianza \(\sigma^2\) con nivel de confianza \(1 - \alpha\) es
\[\left( \frac{(n-1)s^2}{\chi^2_{1-\alpha/2,\, n-1}}, \frac{(n-1)s^2}{\chi^2_{\alpha/2,\, n-1}} \right)\]
Fíjate en que el intervalo no es simétrico respecto a \(s^2\), porque la chi-cuadrado tampoco lo es. R base no tiene una función para este intervalo, pero puedes calcularlo con qchisq y var. Para la variable mpg de mtcars:
x <- mtcars$mpg
n <- length(x)
s2 <- var(x) # 36.3241

alpha <- 0.05
inf <- (n - 1) * s2 / qchisq(1 - alpha / 2, df = n - 1)
sup <- (n - 1) * s2 / qchisq(alpha / 2, df = n - 1)

# Intervalo para la varianza
c(inf, sup)

# Intervalo para la desviación típica
sqrt(c(inf, sup))
[1] 23.34653 64.20343
[1] 4.831825 8.012704Es decir, la varianza poblacional está entre 23.35 y 64.20 con una confianza del 95%, y la desviación típica (6.03 en la muestra) entre 4.83 y 8.01. Fíjate en lo ancho que es el intervalo con 32 observaciones: las varianzas se estiman con mucha menos precisión que las medias.
A diferencia del intervalo para la media, este intervalo es muy sensible a la falta de normalidad, incluso con muestras grandes. Comprueba antes la normalidad de los datos, por ejemplo, con el test de Shapiro-Wilk.
La función rchisq
La función rchisq genera observaciones aleatorias de una distribución chi-cuadrado. Usa set.seed para que los resultados sean reproducibles:
rchisq(n,       # Número de observaciones a generar
       df,      # Grados de libertad
       ncp = 0) # Parámetro de no centralidad
set.seed(1)
rchisq(5, df = 3)[1] 0.9433146 5.5437816 5.3543968 2.9152466 5.0531908Una buena forma de entender la definición de la distribución es simularla. El siguiente código genera 100000 sumas de tres normales estándar al cuadrado y compara su media y su varianza con las de rchisq con 3 grados de libertad. Según la teoría, ambas deberían estar cerca de \(k = 3\) y \(2k = 6\):
set.seed(1)

# Suma de 3 normales estándar al cuadrado
z <- matrix(rnorm(100000 * 3), ncol = 3)
q <- rowSums(z^2)

# Chi-cuadrado con 3 gl
y <- rchisq(100000, df = 3)

c(media = mean(q), varianza = var(q))
c(media = mean(y), varianza = var(y))
media varianza
3.004272 6.028960
media varianza
2.990382 5.948571Las dos simulaciones dan una media próxima a 3 y una varianza próxima a 6. También puedes comprobarlo visualmente con un histograma de las sumas simuladas y la densidad teórica superpuesta:
set.seed(1)
z <- matrix(rnorm(100000 * 3), ncol = 3)
q <- rowSums(z^2)

hist(q, breaks = 60, prob = TRUE, col = "lightgray", border = "white",
     main = "", xlab = "Suma de 3 N(0, 1) al cuadrado", ylab = "Densidad",
     xlim = c(0, 20))
curve(dchisq(x, df = 3), add = TRUE, lwd = 2, col = "red")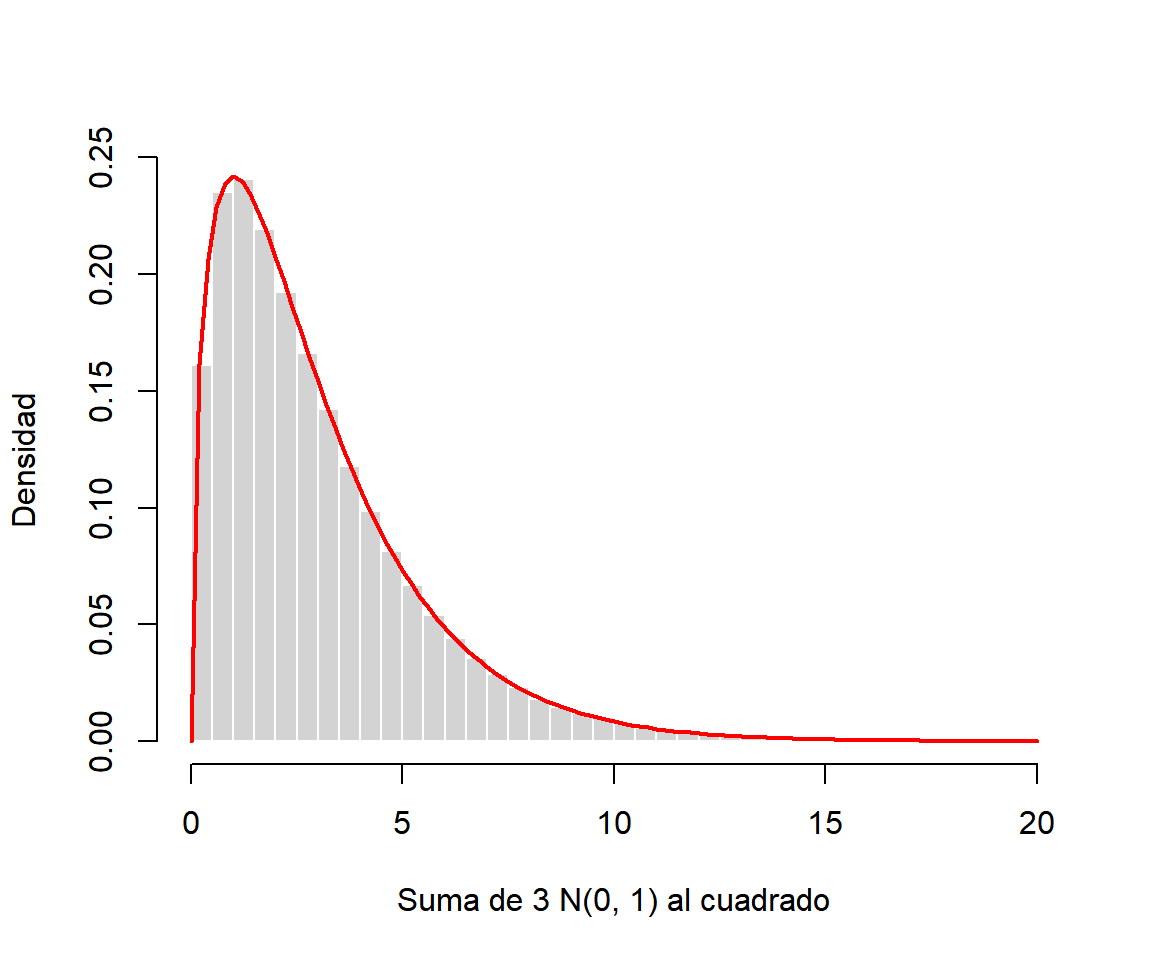
La curva roja se ajusta perfectamente al histograma. Por último, todas las funciones aceptan el argumento ncp para la distribución chi-cuadrado no central, que es la distribución del estadístico cuando la hipótesis nula es falsa y se usa en el cálculo de la potencia.