Transformar datos en R con pivot_longer() y pivot_wider() de tidyr
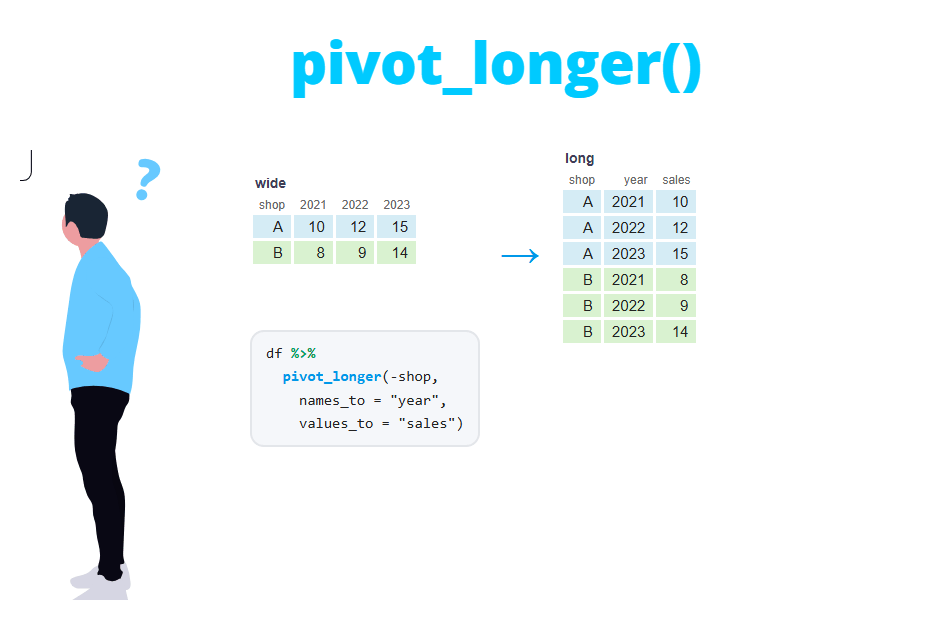
Las funciones pivot_longer y pivot_wider del paquete tidyr sirven para cambiar la forma de un data frame. pivot_longer convierte los datos de formato ancho a formato largo (columnas en filas) y pivot_wider hace lo contrario, de formato largo a ancho (filas en columnas). En este tutorial aprenderás cuándo te conviene cada formato, cómo tratar nombres de columnas que contienen varios datos a la vez y cómo solucionar el aviso "Values are not uniquely identified".
Formato ancho y formato largo
Los mismos datos se pueden guardar de dos formas. En formato ancho cada sujeto ocupa una sola fila y las mediciones repetidas se reparten en varias columnas. El siguiente data frame contiene las ventas de tres tiendas en tres años, con una columna por año:
library(tidyr)
library(dplyr)

ventas <- tibble(
  tienda = c("A", "B", "C"),
  `2022` = c(120, 95, 130),
  `2023` = c(135, 110, NA),
  `2024` = c(150, 105, 140)
)

ventas
# A tibble: 3 × 4
tienda `2022` `2023` `2024`
<chr> <dbl> <dbl> <dbl>
1 A 120 135 150
2 B 95 110 105
3 C 130 NA 140En formato largo cada fila es una única observación: una tienda en un año. El año deja de formar parte de los nombres de las columnas y pasa a ser una variable con su propia columna:
# A tibble: 9 × 3
  tienda anio  ventas
  <chr>  <chr>  <dbl>
1 A      2022     120
2 A      2023     135
3 A      2024     150
4 B      2022      95
5 B      2023     110
6 B      2024     105
7 C      2022     130
8 C      2023      NA
9 C      2024     140
¿Cuál es mejor? El formato ancho es más fácil de leer para una persona y es el habitual en las hojas de cálculo. Sin embargo, la mayoría de herramientas de R esperan el formato largo: con datos largos puedes agrupar por año y resumir las ventas, filtrar un rango de años o llevar el año al eje x de un gráfico de ggplot2. Con datos anchos cada una de esas operaciones te obligaría a escribir el nombre de una columna por año.
Una regla práctica: si una información con la que necesitas trabajar (un año, un tratamiento, un tipo de medida) está guardada en los nombres de las columnas, necesitas pivot_longer. Si necesitas una tabla para presentar resultados o una columna por categoría para calcular diferencias entre ellas, necesitas pivot_wider.
pivot_longer: de ancho a largo
La sintaxis básica de pivot_longer tiene tres argumentos clave:
pivot_longer(data, cols, names_to = "name", values_to = "value", ...)Siendo:
cols: las columnas que se van a convertir en filas.names_to: nombre de la nueva columna que guardará los antiguos nombres de columna.values_to: nombre de la nueva columna que guardará los valores de las celdas.
El siguiente código pasa el data frame ventas a formato largo. Las columnas de los años tienen nombres no sintácticos (empiezan por un número), así que tendrás que escribirlos entre comillas invertidas. El ejemplo usa el operador pipe %>%:
ventas %>%
  pivot_longer(cols = c(`2022`, `2023`, `2024`),
               names_to = "anio",
               values_to = "ventas")
# A tibble: 9 × 3
tienda anio ventas
<chr> <chr> <dbl>
1 A 2022 120
2 A 2023 135
3 A 2024 150
4 B 2022 95
5 B 2023 110
6 B 2024 105
7 C 2022 130
8 C 2023 NA
9 C 2024 140Las 3 filas × 3 columnas de años se convierten en 9 filas. Las columnas que no pivotas (tienda) se repiten para cada año y son las que identifican cada fila.
Seleccionar las columnas a pivotar
El argumento cols usa la misma sintaxis que la función select, así que no hace falta escribir todas las columnas. Estas llamadas son equivalentes a la anterior:
ventas %>% pivot_longer(cols = -tienda, names_to = "anio", values_to = "ventas")
ventas %>% pivot_longer(cols = `2022`:`2024`, names_to = "anio", values_to = "ventas")
ventas %>% pivot_longer(cols = where(is.numeric), names_to = "anio", values_to = "ventas")
Indicar las columnas que no quieres pivotar (-tienda) suele ser la opción más robusta, ya que sigue funcionando si se añade un año nuevo a los datos. Otras funciones auxiliares como starts_with("ventas_"), ends_with(), contains() o matches() son útiles cuando las columnas comparten un patrón.
Convertir la columna de nombres
Fíjate en que la nueva columna anio es de tipo carácter (<chr>), porque proviene de nombres de columnas. Si la necesitas como número, utiliza names_transform en lugar de convertirla después:
ventas %>%
  pivot_longer(cols = -tienda, names_to = "anio", values_to = "ventas",
               names_transform = list(anio = as.integer))
# A tibble: 9 × 3
tienda anio ventas
<chr> <int> <dbl>
1 A 2022 120
2 A 2023 135
3 A 2024 150
4 B 2022 95
5 B 2023 110
6 B 2024 105
7 C 2022 130
8 C 2023 NA
9 C 2024 140Eliminar los valores faltantes
En formato ancho, una combinación sin dato tiene que guardarse como una celda NA. En formato largo, esa fila simplemente puede no existir. Indica values_drop_na = TRUE para eliminar las filas cuyo valor es NA. Ahora la tienda C solo tiene dos filas:
ventas %>%
  pivot_longer(cols = -tienda, names_to = "anio", values_to = "ventas",
               values_drop_na = TRUE)
# A tibble: 8 × 3
tienda anio ventas
<chr> <chr> <dbl>
1 A 2022 120
2 A 2023 135
3 A 2024 150
4 B 2022 95
5 B 2023 110
6 B 2024 105
7 C 2022 130
8 C 2024 140Equivale a aplicar drop_na(ventas) después de pivotar. Consulta el tutorial sobre valores NA en R para conocer otras formas de tratar los datos faltantes.
Eliminar un prefijo con names_prefix
Es habitual que las columnas se llamen ventas_2023 en lugar de solo 2023. Si quieres quedarte únicamente con el año, names_prefix elimina el texto indicado del principio de los nombres:
ventas2 <- tibble(tienda = c("A", "B"),
                  ventas_2023 = c(135, 110),
                  ventas_2024 = c(150, 105))

ventas2 %>%
  pivot_longer(cols = starts_with("ventas_"), names_to = "anio",
               names_prefix = "ventas_", values_to = "ventas")
# A tibble: 4 × 3
tienda anio ventas
<chr> <chr> <dbl>
1 A 2023 135
2 A 2024 150
3 B 2023 110
4 B 2024 105Nombres con varias variables: names_sep y names_pattern
A veces los nombres de las columnas guardan dos variables a la vez. En el siguiente data frame cada nombre contiene una métrica (ventas o costes) y un año separados por un guion bajo:
ventas3 <- tibble(tienda = c("A", "B"),
                  ventas_2023 = c(135, 110), ventas_2024 = c(150, 105),
                  costes_2023 = c(80, 70), costes_2024 = c(90, 72))

ventas3
# A tibble: 2 × 5
tienda ventas_2023 ventas_2024 costes_2023 costes_2024
<chr> <dbl> <dbl> <dbl> <dbl>
1 A 135 150 80 90
2 B 110 105 70 72Pasa un vector con dos nombres a names_to y el separador a names_sep. tidyr dividirá cada nombre de columna en las dos nuevas columnas:
ventas3 %>%
  pivot_longer(cols = -tienda, names_to = c("metrica", "anio"),
               names_sep = "_", values_to = "valor")
# A tibble: 8 × 4
tienda metrica anio valor
<chr> <chr> <chr> <dbl>
1 A ventas 2023 135
2 A ventas 2024 150
3 A costes 2023 80
4 A costes 2024 90
5 B ventas 2023 110
6 B ventas 2024 105
7 B costes 2023 70
8 B costes 2024 72Si los nombres no tienen separador (por ejemplo ventas2023), utiliza names_pattern con una expresión regular. Cada grupo entre paréntesis se convierte en una de las nuevas columnas. Si no te manejas con las expresiones regulares, echa un vistazo al tutorial de grepl y grep.
ventas4 <- tibble(tienda = c("A", "B"),
                  ventas2023 = c(135, 110), ventas2024 = c(150, 105),
                  costes2023 = c(80, 70), costes2024 = c(90, 72))

ventas4 %>%
  pivot_longer(cols = -tienda, names_to = c("metrica", "anio"),
               names_pattern = "([a-z]+)([0-9]+)", values_to = "valor")
La salida es la misma que la anterior. El primer grupo, ([a-z]+), captura las letras (la métrica) y el segundo, ([0-9]+), captura los dígitos (el año).
Las ventas y los costes son dos variables distintas, así que en muchos casos preferirás mantenerlas en columnas separadas. El nombre especial ".value" indica a pivot_longer que esa parte del nombre debe usarse como nombre de columna en lugar de guardarse como un valor:
ventas3 %>%
  pivot_longer(cols = -tienda, names_to = c(".value", "anio"), names_sep = "_")
# A tibble: 4 × 4
tienda anio ventas costes
<chr> <chr> <dbl> <dbl>
1 A 2023 135 80
2 A 2024 150 90
3 B 2023 110 70
4 B 2024 105 72Ahora cada fila es una tienda en un año y puedes calcular el beneficio con un simple mutate(beneficio = ventas - costes).
Todas las columnas pivotadas acaban en la misma columna de valores, así que deben tener tipos compatibles. Si mezclas columnas numéricas y de texto obtendrás el error Can’t combine . Pivota solo las columnas del mismo tipo o conviértelas con x <double> and y <character>values_transform = as.character.
pivot_wider: de largo a ancho
pivot_wider es la operación inversa. Sus argumentos principales son:
pivot_wider(data, names_from = name, values_from = value, values_fill = NULL, ...)Siendo:
names_from: la columna cuyos valores se convertirán en los nombres de las nuevas columnas.values_from: la columna cuyos valores rellenarán las nuevas columnas.values_fill: el valor que se usa cuando una combinación no existe en los datos.
Partiendo del data frame largo de la primera sección, guardado como largo, puedes volver a tener una columna por año así:
largo <- ventas %>%
  pivot_longer(cols = -tienda, names_to = "anio", values_to = "ventas")

largo %>%
  pivot_wider(names_from = anio, values_from = ventas)
# A tibble: 3 × 4
tienda `2022` `2023` `2024`
<chr> <dbl> <dbl> <dbl>
1 A 120 135 150
2 B 95 110 105
3 C 130 NA 140Todas las columnas que no se usan en names_from ni en values_from identifican las filas del resultado. Aquí solo queda tienda, por lo que obtienes una fila por tienda. Si usas tienda en names_from obtendrás una fila por año y una columna por tienda:
largo %>%
  pivot_wider(names_from = tienda, values_from = ventas)
# A tibble: 3 × 4
anio A B C
<chr> <dbl> <dbl> <dbl>
1 2022 120 95 130
2 2023 135 110 NA
3 2024 150 105 140Nombres válidos con names_prefix
Los nombres de columna como 2022 no son sintácticos y te obligan a usar comillas invertidas (df$`2022`). Usa names_prefix para añadir un prefijo a las nuevas columnas:
largo %>%
  pivot_wider(names_from = anio, values_from = ventas,
              names_prefix = "y_")
# A tibble: 3 × 4
tienda y_2022 y_2023 y_2024
<chr> <dbl> <dbl> <dbl>
1 A 120 135 150
2 B 95 110 105
3 C 130 NA 140Rellenar combinaciones faltantes con values_fill
values_fill sustituye los valores faltantes del resultado, por ejemplo por 0 cuando no tener ventas significa vender cero. Pero hay un detalle que confunde a mucha gente: values_fill solo rellena las combinaciones que no existen en los datos, no los NA explícitos. Con el data frame largo, que contiene una fila para la tienda C en 2023 con un NA, no cambia nada:
largo %>%
  pivot_wider(names_from = anio, values_from = ventas,
              values_fill = 0)
# A tibble: 3 × 4
tienda `2022` `2023` `2024`
<chr> <dbl> <dbl> <dbl>
1 A 120 135 150
2 B 95 110 105
3 C 130 NA 140Si la fila no existe (aquí se elimina antes con values_drop_na = TRUE), el hueco se rellena con 0:
ventas %>%
  pivot_longer(cols = -tienda, names_to = "anio", values_to = "ventas",
               values_drop_na = TRUE) %>%
  pivot_wider(names_from = anio, values_from = ventas,
              values_fill = 0)
# A tibble: 3 × 4
tienda `2022` `2023` `2024`
<chr> <dbl> <dbl> <dbl>
1 A 120 135 150
2 B 95 110 105
3 C 130 0 140Para sustituir los NA explícitos utiliza replace_na de tidyr después de pivotar.
Varias columnas de valores
Si tienes más de una variable que repartir, pásalas todas a values_from. Los nombres de las nuevas columnas combinan la variable y el valor de names_from, separados por names_sep ("_" por defecto):
largo3 <- ventas3 %>%
  pivot_longer(cols = -tienda, names_to = c(".value", "anio"), names_sep = "_")

largo3 %>%
  pivot_wider(names_from = anio, values_from = c(ventas, costes))
# A tibble: 2 × 5
tienda ventas_2023 ventas_2024 costes_2023 costes_2024
<chr> <dbl> <dbl> <dbl> <dbl>
1 A 135 150 80 90
2 B 110 105 70 72“Values are not uniquely identified; output will contain list-cols”
Este es el problema más habitual con pivot_wider. Fíjate en los siguientes datos, donde cada fila es un pedido y algunas tiendas tienen más de un pedido en el mismo año:
pedidos <- tibble(
  tienda = c("A", "A", "A", "B", "B", "B"),
  anio   = c(2023, 2023, 2024, 2023, 2024, 2024),
  ventas = c(60, 75, 150, 110, 50, 55)
)

pedidos %>%
  pivot_wider(names_from = anio, values_from = ventas)
# A tibble: 2 × 3
tienda `2023` `2024`
<chr> <list> <list>
1 A <dbl [2]> <dbl [1]>
2 B <dbl [1]> <dbl [2]>
Warning message:
Values from `ventas` are not uniquely identified; output will contain
list-cols.
• Use `values_fn = list` to suppress this warning.
• Use `values_fn = {summary_fun}` to summarise duplicates.
• Use the following dplyr code to identify duplicates.
{data} %>%
dplyr::group_by(tienda, anio) %>%
dplyr::summarise(n = dplyr::n(), .groups = "drop") %>%
dplyr::filter(n > 1L)El resultado tiene una celda para la tienda A en 2023, pero los datos contienen dos valores para ella (60 y 75). Como una celda no puede guardar dos números, pivot_wider mete ambos en una lista y las columnas pasan a ser columnas de tipo lista (<list>, <dbl [2]>). Casi nunca es lo que quieres: no puedes sumar ni representar esas columnas.
El primer paso es localizar las combinaciones duplicadas, como sugiere el propio aviso. Con la función count es muy rápido:
pedidos %>%
  count(tienda, anio) %>%
  filter(n > 1)
# A tibble: 2 × 3
tienda anio n
<chr> <dbl> <int>
1 A 2023 2
2 B 2024 2Después, decide qué significan los duplicados. Hay tres casos típicos:
1. Los duplicados deben agregarse. Si quieres el total (o la media) de ventas por tienda y año, pasa una función de resumen a values_fn:
pedidos %>%
  pivot_wider(names_from = anio, values_from = ventas,
              values_fn = sum)
# A tibble: 2 × 3
tienda `2023` `2024`
<chr> <dbl> <dbl>
1 A 135 150
2 B 110 105Puedes obtener el mismo resultado agregando primero con summarise(ventas = sum(ventas), .by = c(tienda, anio)) y pivotando después. Esta opción es más explícita y te permite revisar el resumen antes de cambiar la forma de los datos.
2. Las filas son observaciones distintas. Si cada pedido debe conservar su propio valor, a los datos les falta una variable que identifique las filas. Créala, por ejemplo con row_number por grupo, para que cada combinación sea única:
pedidos %>%
  group_by(tienda, anio) %>%
  mutate(pedido = row_number()) %>%
  ungroup() %>%
  pivot_wider(names_from = anio, values_from = ventas)
# A tibble: 4 × 4
tienda pedido `2023` `2024`
<chr> <int> <dbl> <dbl>
1 A 1 60 150
2 A 2 75 NA
3 B 1 110 50
4 B 2 NA 553. Los duplicados son un error. Si cada tienda solo debería tener un valor por año, el problema está en los datos (una fila cargada dos veces, un join mal hecho…). Elimina las filas duplicadas o corrige el origen en lugar de esconder el problema con values_fn.
Una causa frecuente de este aviso es una columna extra que has olvidado. Cualquier columna que no uses en names_from ni en values_from se utiliza para identificar las filas, así que una columna con un valor distinto en cada fila (como un ID o una marca de tiempo) produce un resultado lleno de huecos, mientras que la falta de un identificador produce duplicados. Usa id_cols o select para quedarte solo con las columnas identificadoras antes de pivotar.
Ida y vuelta: de largo a ancho
pivot_longer y pivot_wider son operaciones inversas. Si pasas los datos a formato largo y luego de nuevo a ancho, obtienes exactamente el data frame original:
vuelta <- ventas %>%
  pivot_longer(cols = -tienda, names_to = "anio", values_to = "ventas") %>%
  pivot_wider(names_from = anio, values_from = ventas)

identical(vuelta, ventas)
[1] TRUEEs un flujo de trabajo muy habitual: pasas a formato largo, calculas algo por grupo con dplyr y vuelves a formato ancho para presentar el resultado como una tabla. Ten en cuenta que la ida y vuelta solo funciona si los datos largos no tienen duplicados y no eliminas valores faltantes por el camino.
Alternativa en R base: reshape()
Si no quieres usar tidyr, R base ofrece la función reshape. Necesita que los nombres de las columnas sigan el patrón variable.tiempo (por ejemplo ventas.2022) y sus argumentos son menos intuitivos:
df <- as.data.frame(ventas)
names(df) <- c("tienda", "ventas.2022", "ventas.2023", "ventas.2024")

# De ancho a largo
largo_b <- reshape(df, direction = "long", varying = 2:4,
                   idvar = "tienda", timevar = "anio")
largo_b

# De largo a ancho
reshape(largo_b, direction = "wide", idvar = "tienda", timevar = "anio")
tienda anio ventas
A.2022 A 2022 120
B.2022 B 2022 95
C.2022 C 2022 130
A.2023 A 2023 135
B.2023 B 2023 110
C.2023 C 2023 NA
A.2024 A 2024 150
B.2024 B 2024 105
C.2024 C 2024 140
tienda ventas.2022 ventas.2023 ventas.2024
A.2022 A 120 135 150
B.2022 B 95 110 105
C.2022 C 130 NA 140Observa que reshape devuelve las filas ordenadas por año en lugar de por tienda y añade nombres de fila que normalmente querrás eliminar.
La siguiente tabla resume las funciones equivalentes:
| Tarea | tidyr (actual) | tidyr (reemplazada) | R base |
|---|---|---|---|
| De ancho a largo | pivot_longer() |
gather() |
reshape(direction = "long") |
| De largo a ancho | pivot_wider() |
spread() |
reshape(direction = "wide") |
Las funciones gather y spread están reemplazadas (superseded): siguen funcionando, así que las verás en código antiguo, pero no recibirán novedades. pivot_longer y pivot_wider las sustituyen con nombres de argumentos más claros y permiten trabajar con varias variables en los nombres de las columnas, así que usa las funciones pivot en el código nuevo. Ten en cuenta también que pivot_wider no combina datos de tablas distintas: para eso necesitas un join.