Test exacto de Fisher en R con fisher.test()
La función fisher.test realiza el test exacto de Fisher en R, que contrasta si dos variables categóricas son independientes utilizando las probabilidades exactas de la tabla de contingencia en lugar de una aproximación. Es el test que debes usar cuando la muestra es pequeña y el test chi-cuadrado no es fiable. En este tutorial aprenderás cuándo utilizarlo, cómo interpretar su p-valor, el odds ratio y su intervalo de confianza, cómo realizar contrastes unilaterales y qué hacer con tablas más grandes.
Cuándo usar el test exacto de Fisher
El test chi-cuadrado compara las frecuencias observadas de una tabla de contingencia con las que cabría esperar si las variables fueran independientes. Su p-valor se obtiene a partir de una aproximación a la distribución chi-cuadrado, y esa aproximación es mala cuando las frecuencias esperadas son pequeñas.
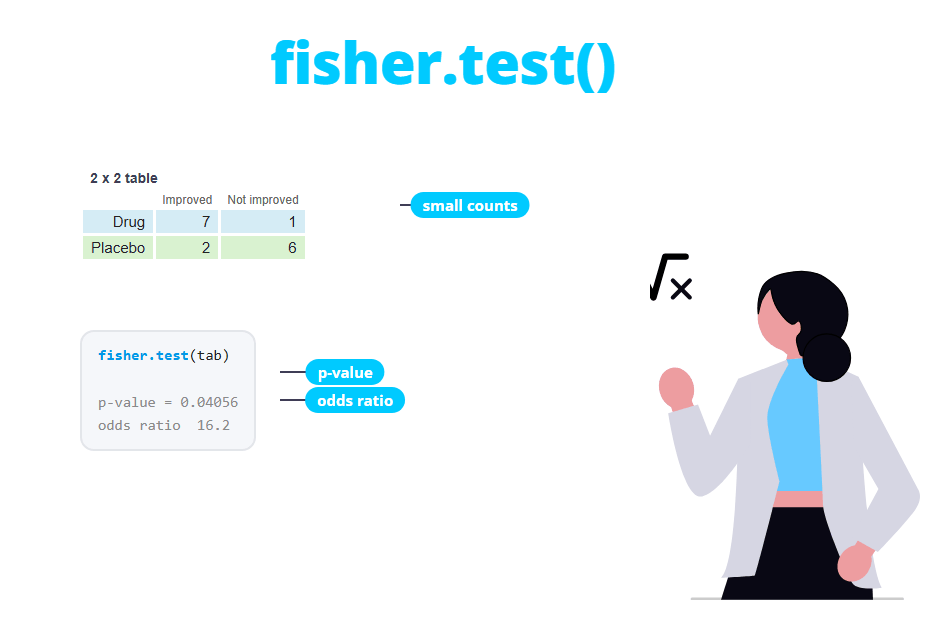
Supón un pequeño ensayo clínico con 16 pacientes: 8 recibieron un fármaco y 8 un placebo, y se registró si mejoraron o no:
trat <- matrix(c(7, 2, 1, 6), nrow = 2,
               dimnames = list(Tratamiento = c("Fármaco", "Placebo"),
                               Resultado = c("Mejora", "No mejora")))
trat
Resultado
Tratamiento Mejora No mejora
Fármaco 7 1
Placebo 2 6Si aplicas chisq.test a esta tabla, R te devuelve un resultado, pero también un aviso:
chi <- chisq.test(trat)
chi
Warning message:
In chisq.test(trat) : Chi-squared approximation may be incorrect
Pearson's Chi-squared test with Yates' continuity correction
data: trat
X-squared = 4.0635, df = 1, p-value = 0.04382El aviso “Chi-squared approximation may be incorrect” aparece cuando al menos una frecuencia esperada es inferior a 5. Puedes consultar las frecuencias esperadas con el elemento expected del resultado:
chi$expected Resultado
Tratamiento Mejora No mejora
Fármaco 4.5 3.5
Placebo 4.5 3.5Las cuatro frecuencias esperadas son inferiores a 5. La regla habitual dice que la aproximación chi-cuadrado es aceptable si todas las frecuencias esperadas son al menos 5 (una versión más flexible permite hasta un 20% de celdas por debajo de 5 y ninguna por debajo de 1). Cuando no se cumple, usa el test exacto de Fisher.
La regla se refiere a las frecuencias esperadas, no a las observadas. Una tabla puede tener una celda con frecuencia observada 0 y aun así ser adecuada para el test chi-cuadrado si todas sus frecuencias esperadas son 5 o más.
Hipótesis
El test exacto de Fisher tiene las mismas hipótesis que el test chi-cuadrado de independencia:
- \(H_0\): las dos variables son independientes (en una tabla 2x2, el odds ratio es igual a 1).
- \(H_1\): las dos variables no son independientes (el odds ratio es distinto de 1).
El test considera fijos los totales de filas y columnas y calcula la probabilidad exacta de obtener cada tabla posible con esos totales, utilizando la distribución hipergeométrica. El p-valor es la suma de las probabilidades de todas las tablas tan improbables como la observada o más. Por eso se llama “exacto”: no depende de ninguna aproximación para muestras grandes.
Sintaxis de fisher.test
Los argumentos principales de la función son los siguientes:
fisher.test(x, y = NULL, alternative = "two.sided",
            conf.int = TRUE, conf.level = 0.95,
            simulate.p.value = FALSE, B = 2000, workspace = 200000, ...)
Siendo:
x: una tabla de contingencia o una matriz con las frecuencias, o un factor.y: un factor con la segunda variable. Se ignora sixes una tabla o una matriz.alternative:"two.sided"(por defecto),"greater"o"less". Solo se usa en tablas 2x2.conf.intyconf.level: si se calcula el intervalo de confianza del odds ratio y su nivel (solo tablas 2x2).simulate.p.valueyB: calcula el p-valor mediante simulación de Monte Carlo conBréplicas, para tablas mayores que 2x2.workspace: memoria que utiliza el algoritmo exacto en tablas mayores que 2x2.
Test de Fisher en una tabla 2x2
Pasa la tabla del ensayo clínico a fisher.test:
trat <- matrix(c(7, 2, 1, 6), nrow = 2,
               dimnames = list(Tratamiento = c("Fármaco", "Placebo"),
                               Resultado = c("Mejora", "No mejora")))

fisher.test(trat)
Fisher's Exact Test for Count Data
data: trat
p-value = 0.04056
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
1.087594 1088.437009
sample estimates:
odds ratio
16.19942La salida contiene:
- p-value: 0.04056. Es inferior a 0.05, así que hay evidencia de que el resultado depende del tratamiento: la proporción de pacientes que mejoran no es la misma con el fármaco que con el placebo.
- alternative hypothesis: el contraste es bilateral, el odds ratio es distinto de 1.
- 95 percent confidence interval: el intervalo de confianza del odds ratio. No incluye el 1, lo que concuerda con el p-valor.
- odds ratio: la estimación del odds ratio, 16.2.
En este ejemplo el test chi-cuadrado con la corrección de Yates daba un p-valor parecido (0.04382), pero con tablas pequeñas ambos tests pueden llevar a conclusiones distintas, y solo el p-valor de Fisher es fiable.
Puedes ver de dónde sale el p-valor con dhyper. Con los totales fijos (8 pacientes con el fármaco, 9 que mejoran y 7 que no), el número de pacientes que tomaron el fármaco y mejoraron solo puede ir de 1 a 8:
# Probabilidad de cada valor posible de la celda superior izquierda
probs <- dhyper(1:8, m = 9, n = 7, k = 8)
names(probs) <- 1:8
round(probs, 4)

# p-valor bilateral: suma de las probabilidades <= que la de la tabla observada
sum(probs[probs <= probs["7"]])
1 2 3 4 5 6 7 8
0.0007 0.0196 0.1371 0.3427 0.3427 0.1371 0.0196 0.0007
[1] 0.04055944El valor observado (7) tiene una probabilidad de 0.0196. Las tablas con 1, 2, 7 y 8 son igual de probables o menos, y sus probabilidades suman el p-valor de fisher.test.
El odds ratio: por qué no coincide con tu cálculo
El odds ratio (razón de momios o razón de odds) compara las odds de mejorar en cada grupo. Si llamas \(a\), \(b\) a las celdas de la primera fila y \(c\), \(d\) a las de la segunda, el odds ratio muestral es:
\[OR = \frac{a \cdot d}{b \cdot c} = \frac{7 \cdot 6}{1 \cdot 2} = 21\]
Sin embargo, fisher.test devuelve 16.2. No es un error: R muestra la estimación de máxima verosimilitud condicional del odds ratio, que se calcula a partir de la misma distribución hipergeométrica que utiliza el test (condicionando a los totales de la tabla). Con muestras grandes ambas estimaciones son muy parecidas, pero con muestras pequeñas la estimación condicional queda más cerca de 1. Si necesitas el odds ratio muestral, calcúlalo a mano como arriba.
El intervalo de confianza es muy amplio (de 1.09 a 1088). Es lo habitual con muestras pequeñas: los datos muestran que el fármaco funciona, pero dicen muy poco sobre el tamaño del efecto. Si alguna celda vale 0, la estimación será 0 o Inf, y uno de los límites del intervalo también.
Si solo necesitas los valores, puedes extraerlos del resultado:
ft <- fisher.test(trat)

ft$p.value
ft$estimate
ft$conf.int
[1] 0.04055944
odds ratio
16.19942
[1] 1.087594 1088.437009
attr(,"conf.level")
[1] 0.95Contrastes unilaterales
En una tabla 2x2 puedes utilizar el argumento alternative para contrastar una hipótesis unilateral sobre el odds ratio. "greater" contrasta si el odds ratio es mayor que 1, es decir, si la primera fila tiene una proporción mayor en la primera columna que la segunda fila.
El ejemplo clásico es el que usó el propio Fisher para presentar el test, la dama que cataba té: una señora afirmaba que podía distinguir si en la taza se había echado primero la leche o el té. Se le dieron 8 tazas, 4 de cada tipo, y ella sabía que había 4 de cada. Acertó 3 de las 4 tazas en las que se había echado primero la leche:
te <- matrix(c(3, 1, 1, 3), nrow = 2,
             dimnames = list(Respuesta = c("Leche", "Té"),
                             Realidad = c("Leche", "Té")))
te
Realidad
Respuesta Leche Té
Leche 3 1
Té 1 3La pregunta no es si sus respuestas están asociadas con la realidad en cualquier sentido, sino si acierta más de lo que cabría esperar por azar, así que la alternativa es unilateral ("greater"):
fisher.test(te, alternative = "greater") Fisher's Exact Test for Count Data
data: te
p-value = 0.2429
alternative hypothesis: true odds ratio is greater than 1
95 percent confidence interval:
0.3135693 Inf
sample estimates:
odds ratio
6.408309El p-valor es 0.2429: acertar 3 de 4 tazas por azar ocurre casi una de cada cuatro veces, por lo que no hay evidencia de su habilidad. Solo el resultado perfecto (4 de 4) habría dado un p-valor inferior a 0.05 (es 1/70 = 0.014). El intervalo de un contraste unilateral también es unilateral, de 0.31 a infinito.
El sentido de "greater" y "less" depende del orden de las filas y las columnas. El odds ratio siempre es \((a \cdot d) / (b \cdot c)\), así que si intercambias las filas el odds ratio pasa a ser su inverso y necesitarías la alternativa contraria. Imprime la tabla y comprueba el orden antes de realizar un contraste unilateral.
Test de Fisher a partir de los datos brutos
Normalmente no tendrás la tabla, sino un data frame con una fila por individuo. Puedes construir la tabla con la función table o pasar las dos variables directamente a fisher.test:
df <- data.frame(tratamiento = rep(c("Fármaco", "Placebo"), each = 8),
                 resultado = c(rep("Mejora", 7), "No mejora",
                               rep("Mejora", 2), rep("No mejora", 6)))

tab <- table(df$tratamiento, df$resultado)
tab
Mejora No mejora
Fármaco 7 1
Placebo 2 6fisher.test(tab)
# Equivalente a:
# fisher.test(df$tratamiento, df$resultado) Fisher's Exact Test for Count Data
data: tab
p-value = 0.04056
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
1.087594 1088.437009
sample estimates:
odds ratio
16.19942table ordena las categorías alfabéticamente. Si necesitas otro orden (por ejemplo, para un contraste unilateral), convierte las variables en factores con los niveles en el orden que quieras antes de crear la tabla.
Test de Fisher en tablas más grandes (r x c)
fisher.test también funciona con tablas mayores que 2x2. En ese caso solo devuelve el p-valor, porque no existe un único odds ratio. Por ejemplo, el número de cilindros y de marchas de los coches de mtcars:
tab2 <- table(mtcars$cyl, mtcars$gear)
tab2
3 4 5
4 1 8 2
6 2 4 1
8 12 0 2Con 32 coches y 9 celdas, 6 de las 9 frecuencias esperadas son inferiores a 5, así que chisq.test muestra el mismo aviso que antes. El test de Fisher es la opción adecuada:
fisher.test(tab2) Fisher's Exact Test for Count Data
data: tab2
p-value = 8.26e-05
alternative hypothesis: two.sidedEl p-valor es prácticamente cero, por lo que el número de marchas está asociado al número de cilindros.
Error: aumenta el workspace o simula el p-valor
El número de tablas posibles crece muy rápido con el tamaño de la tabla y de la muestra. Con tablas grandes fisher.test puede fallar. Por ejemplo, con el color de pelo y de ojos de 592 estudiantes:
hec <- margin.table(HairEyeColor, c(1, 2))
fisher.test(hec)
Error in fisher.test(hec) :
FEXACT error 6 (f5xact). LDKEY=618 is too small for this problem: kval=238045028.
Try increasing the size of the workspace.Tienes tres opciones:
- Aumentar el argumento
workspace(por ejemplo,workspace = 2e8). Puede funcionar, pero puede tardar mucho y consumir mucha memoria. - Calcular el p-valor por simulación con
simulate.p.value = TRUE, que es rápido y suele ser suficiente. - Usar el test chi-cuadrado: si la tabla es tan grande, lo más probable es que las frecuencias esperadas sean suficientemente altas.
set.seed(1)
fisher.test(hec, simulate.p.value = TRUE, B = 10000)
Fisher's Exact Test for Count Data with simulated p-value (based on
10000 replicates)
data: hec
p-value = 9.999e-05
alternative hypothesis: two.sidedFija una semilla con set.seed para que el p-valor simulado sea reproducible. El p-valor más pequeño que puede devolver una simulación es \(1 / (B + 1)\), que con 10000 réplicas es justo 9.999e-05: ninguna de las tablas simuladas fue tan extrema como la observada, así que el p-valor real es todavía menor. En este caso el test chi-cuadrado también es perfectamente válido (chisq.test(hec) devuelve un p-valor < 2.2e-16).
Test exacto de Fisher frente a test chi-cuadrado
La siguiente tabla resume las diferencias:
| Test exacto de Fisher | Test chi-cuadrado | |
|---|---|---|
| Función | fisher.test |
chisq.test |
| p-valor | Exacto | Aproximado |
| Frecuencias esperadas pequeñas (< 5) | Válido | Poco fiable, muestra un aviso |
| Muestras o tablas grandes | Lento, puede requerir simulate.p.value |
Rápido y preciso |
| Medida del efecto | Odds ratio y su IC (2x2) | Ninguna (usa frecuencias esperadas y residuos) |
| Test de bondad de ajuste | No | Sí |
En la práctica, usa el test de Fisher cuando alguna frecuencia esperada sea inferior a 5 y el test chi-cuadrado en caso contrario. Con tablas 2x2 de tamaño moderado muchos analistas usan siempre el test de Fisher, ya que es rápido y no depende de ninguna aproximación. Si quieres comparar dos proporciones y obtener un intervalo de confianza para su diferencia en lugar de un odds ratio, consulta el test de dos proporciones.