Texto en columnas en R: dividir una columna en varias
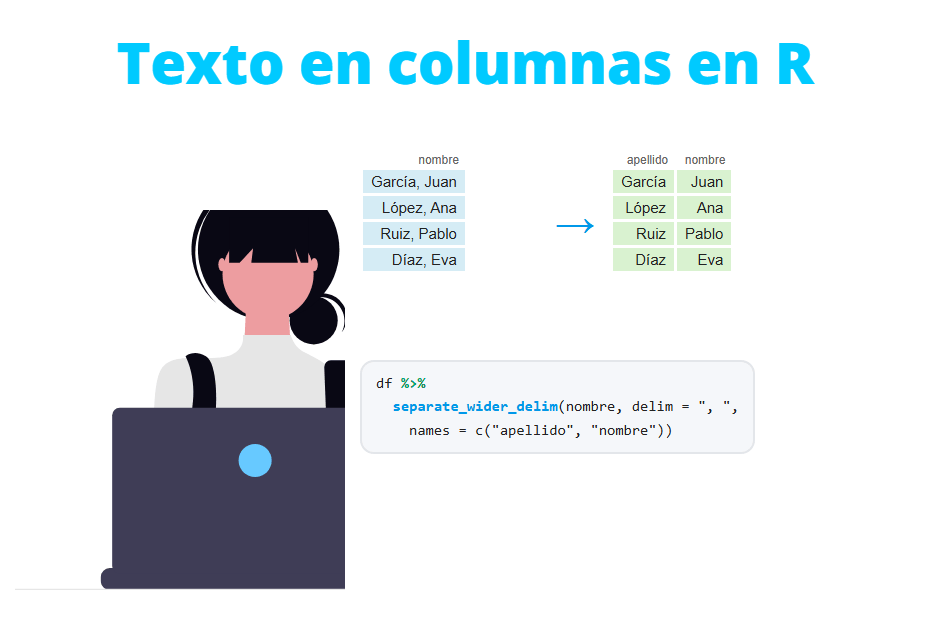
En Excel, la herramienta Texto en columnas (Text to Columns en la versión en inglés) toma una columna como "García, Juan" y la divide en dos columnas, García y Juan. En R no hay asistente, pero hay varias funciones que hacen lo mismo y bastante más: separate_wider_delim() y sus funciones hermanas de tidyr, y strsplit() o read.table() en R base. En este tutorial aprenderás a dividir una columna por un separador o por posición, qué hacer cuando unas filas tienen más trozos que otras, cómo convertir las nuevas columnas a números y cómo volver a unirlas.
Respuesta rápida
Si tu columna tiene un separador, como una coma, un guion o un espacio, utiliza separate_wider_delim() de tidyr. Tendrás que indicar la columna, el separador (delim) y los nombres de las nuevas columnas:
library(tidyr)

df <- data.frame(id = 1:3,
                 nombre_completo = c("García, Juan", "López, Ana", "Martín, Luis"))

df |>
  separate_wider_delim(nombre_completo, delim = ", ", names = c("apellido", "nombre"))
# A tibble: 3 × 3
id apellido nombre
<int> <chr> <chr>
1 1 García Juan
2 2 López Ana
3 3 Martín LuisLa columna original nombre_completo se sustituye por las nuevas columnas, en la misma posición. Si prefieres R base y no quieres instalar nada, read.table() hace el mismo trabajo:
nuevas <- read.table(text = df$nombre_completo, sep = ",", strip.white = TRUE,
                     col.names = c("apellido", "nombre"))

cbind(df, nuevas)
id nombre_completo apellido nombre
1 1 García, Juan García Juan
2 2 López, Ana López Ana
3 3 Martín, Luis Martín LuisEn el resto del artículo verás cada opción en detalle y los problemas que te encontrarás con datos reales.
Del asistente de Excel a R
El asistente de Excel te hace tres preguntas: cómo se divide el texto, dónde están los cortes y qué formato tiene cada columna nueva. Todas tienen su equivalente en R:
| Excel (Texto en columnas) | R |
|---|---|
| Delimitados (coma, tabulación, espacio, otro) |
separate_wider_delim(), strsplit(), read.table(sep = …)
|
| De ancho fijo |
separate_wider_position(), substr(), read.fwf()
|
| “Considerar delimitadores consecutivos como uno solo” |
Una expresión regular como separador, por ejemplo ” +“
|
| Formato de los datos en columnas (General, Texto, Fecha) |
type.convert(), as.numeric(), as.Date()
|
| “No importar columna (saltar)” |
NA en el argumento names
|
| Destino |
Las nuevas columnas sustituyen a la original (cols_remove = FALSE la conserva)
|
Hay una diferencia importante: en Excel ejecutas el asistente una vez y el resultado queda fijo. En R la división es código, así que si el mes que viene recibes un archivo nuevo con la misma estructura, solo tienes que volver a ejecutar las mismas líneas. Si vienes de las hojas de cálculo, en la guía De Excel a R tienes los equivalentes de otras tareas habituales de Excel.
Dividir una columna en R base
strsplit y do.call(rbind)
La función strsplit divide cada cadena por un separador y devuelve una lista, con un elemento por fila:
df <- data.frame(id = 1:3,
                 nombre_completo = c("García, Juan", "López, Ana", "Martín, Luis"))

partes <- strsplit(df$nombre_completo, ", ")
partes
[[1]]
[1] "García" "Juan"
[[2]]
[1] "López" "Ana"
[[3]]
[1] "Martín" "Luis"Una lista todavía no es una tabla. Para convertirla, pasa cada elemento a rbind con do.call, que apila los trozos como filas de una matriz:
m <- do.call(rbind, partes)
m
[,1] [,2]
[1,] "García" "Juan"
[2,] "López" "Ana"
[3,] "Martín" "Luis"Ahora pon nombre a las columnas y únelas al data frame original con cbind:
colnames(m) <- c("apellido", "nombre")
df2 <- cbind(df, m)
df2
id nombre_completo apellido nombre
1 1 García, Juan García Juan
2 2 López, Ana López Ana
3 3 Martín, Luis Martín LuisEste método funciona, pero tiene dos puntos débiles: todas las columnas nuevas son de tipo carácter, aunque contengan números, y da resultados incorrectos sin ningún error cuando algunas filas tienen un número distinto de trozos (lo verás más abajo).
read.table(text = …): lo más parecido al asistente
read.table es la función que lee archivos de texto, como read.csv. Con el argumento text lee un vector de caracteres en lugar de un archivo, así que cada elemento se trata como una línea y se divide por sep. Es justo lo que hace Excel con la opción “Delimitados”, y además adivina el tipo de cada columna, como el formato “General”:
codigos <- c("AB-123-X", "CD-456-Y", "EF-789-Z")

nuevas <- read.table(text = codigos, sep = "-",
                     col.names = c("prefijo", "numero", "sufijo"))
nuevas
str(nuevas)
prefijo numero sufijo
1 AB 123 X
2 CD 456 Y
3 EF 789 Z
'data.frame': 3 obs. of 3 variables:
$ prefijo: chr "AB" "CD" "EF"
$ numero : int 123 456 789
$ sufijo : chr "X" "Y" "Z"La columna numero ya es un entero. Algunos argumentos útiles:
strip.white = TRUEelimina los espacios alrededor de cada trozo (consep = ","," Juan"pasa a ser"Juan").colClasses = "character"lo deja todo como texto, que es lo que quieres para códigos con ceros a la izquierda.quote = ""desactiva las comillas. Por defecto'y"se tratan como comillas, así que un valor como"O'Brien, Pat"rompe la lectura con el errorincomplete final line found by readTableHeader on 'text'.
Dividir una columna con tidyr
separate_wider_delim()
El paquete tidyr tiene tres funciones para dividir una columna en varias: separate_wider_delim() (por un separador), separate_wider_position() (por posición) y separate_wider_regex() (con una expresión regular). Funcionan dentro de una cadena de operaciones y devuelven un tibble.
library(tidyr)

productos <- data.frame(codigo = c("AB-123-X", "CD-456-Y", "EF-789-Z"),
                        unidades = c(10, 5, 8))

productos |>
  separate_wider_delim(codigo, delim = "-", names = c("prefijo", "numero", "sufijo"))
# A tibble: 3 × 4
prefijo numero sufijo unidades
<chr> <chr> <chr> <dbl>
1 AB 123 X 10
2 CD 456 Y 5
3 EF 789 Z 8Fíjate en que delim es una cadena fija, no una expresión regular. "-" y "." se buscan de forma literal, lo que evita un error clásico con strsplit, donde "." significa “cualquier carácter”.
Conservar la columna original, saltar trozos o nombrarlos automáticamente
Hay tres argumentos que usarás a menudo:
cols_remove = FALSEconserva la columna original (en Excel, elegir otro destino).NAdentro denamesdescarta ese trozo (en Excel, “No importar columna”).names_sepcrea los nombres automáticamente a partir del nombre original, si no quieres escribirlos.
# Conservar la columna original
productos |>
  separate_wider_delim(codigo, delim = "-", names = c("prefijo", "numero", "sufijo"),
                       cols_remove = FALSE)

# Descartar el trozo central
productos |>
  separate_wider_delim(codigo, delim = "-", names = c("prefijo", NA, "sufijo"))

# Nombres automáticos: codigo_1, codigo_2, codigo_3
productos |>
  separate_wider_delim(codigo, delim = "-", names_sep = "_")
# A tibble: 3 × 5
prefijo numero sufijo codigo unidades
<chr> <chr> <chr> <chr> <dbl>
1 AB 123 X AB-123-X 10
2 CD 456 Y CD-456-Y 5
3 EF 789 Z EF-789-Z 8
# A tibble: 3 × 3
prefijo sufijo unidades
<chr> <chr> <dbl>
1 AB X 10
2 CD Y 5
3 EF Z 8
# A tibble: 3 × 4
codigo_1 codigo_2 codigo_3 unidades
<chr> <chr> <chr> <dbl>
1 AB 123 X 10
2 CD 456 Y 5
3 EF 789 Z 8¿Y la función separate()?
Muchos tutoriales y respuestas en internet usan separate():
productos |>
  separate(codigo, into = c("prefijo", "numero", "sufijo"), sep = "-", convert = TRUE)
prefijo numero sufijo unidades
1 AB 123 X 10
2 CD 456 Y 5
3 EF 789 Z 8Sigue funcionando, pero desde tidyr 1.3.0 está reemplazada (superseded): no se eliminará, pero tampoco recibirá novedades. Las funciones separate_wider_*() la sustituyen porque separate() mezcla dos cosas distintas en un mismo argumento: sep es una expresión regular cuando es texto y una posición cuando es un número. Para código nuevo, utiliza separate_wider_delim() o separate_wider_position().
Filas con más o menos trozos de los esperados
En los datos reales no todas las filas tienen el mismo número de trozos. En el siguiente data frame el segundo código solo tiene dos partes y el tercero tiene cuatro:
productos2 <- data.frame(codigo = c("AB-123-X", "CD-456", "EF-789-Z-01"))

productos2 |>
  separate_wider_delim(codigo, delim = "-", names = c("prefijo", "numero", "sufijo"))
Error in `separate_wider_delim()`:
! Expected 3 pieces in each element of `codigo`.
! 1 value was too short.
ℹ Use `too_few = "debug"` to diagnose the problem.
ℹ Use `too_few = "align_start"/"align_end"` to silence this message.
! 1 value was too long.
ℹ Use `too_many = "debug"` to diagnose the problem.
ℹ Use `too_many = "drop"/"merge"` to silence this message.Este error es una buena noticia: tidyr se niega a adivinar y te dice cuántas filas se quedan cortas y cuántas tienen trozos de más. El propio mensaje te sugiere la solución. Primero, localiza las filas problemáticas con "debug", que añade tres columnas: si la fila es correcta, cuántos trozos tiene y qué ha sobrado:
productos2 |>
  separate_wider_delim(codigo, delim = "-", names = c("prefijo", "numero", "sufijo"),
                       too_few = "debug", too_many = "debug")
# A tibble: 3 × 7
prefijo numero sufijo codigo codigo_ok codigo_pieces codigo_remainder
<chr> <chr> <chr> <chr> <lgl> <int> <chr>
1 AB 123 X AB-123-X TRUE 3 ""
2 CD 456 <NA> CD-456 FALSE 2 ""
3 EF 789 Z EF-789-Z-01 FALSE 4 "-01"
Warning message:
Debug mode activated: adding variables `codigo_ok`, `codigo_pieces`, and
`codigo_remainder`.Cuando sepas qué está pasando, decide qué hacer en cada caso:
too_few = "align_start"rellena los trozos que faltan por la derecha conNA, y"align_end"los rellena por la izquierda.too_many = "drop"descarta los trozos sobrantes ytoo_many = "merge"los mantiene juntos en la última columna.
productos2 |>
  separate_wider_delim(codigo, delim = "-", names = c("prefijo", "numero", "sufijo"),
                       too_few = "align_start", too_many = "merge")
# A tibble: 3 × 3
prefijo numero sufijo
<chr> <chr> <chr>
1 AB 123 X
2 CD 456 <NA>
3 EF 789 Z-01Con "merge" el último código conserva su sufijo Z-01 completo. Con "drop" obtendrías solo Z y perderías -01 sin aviso, así que úsalo solo cuando tengas claro que los trozos sobrantes no te hacen falta.
Ahora mira qué hace R base con los mismos datos. do.call(rbind) no falla: recicla las filas cortas para rellenar la matriz, y la única pista es un aviso:
do.call(rbind, strsplit(productos2$codigo, "-")) [,1] [,2] [,3] [,4]
[1,] "AB" "123" "X" "AB"
[2,] "CD" "456" "CD" "456"
[3,] "EF" "789" "Z" "01"
Warning message:
In (function (..., deparse.level = 1) :
number of columns of result is not a multiple of vector length (arg 1)La segunda fila tiene ahora CD como sufijo, un dato inventado. read.table necesita fill = TRUE para filas desiguales. Indica también header = FALSE y los nombres de las columnas, porque cuando la primera línea tiene un campo menos que el resto, read.table da por hecho que es una cabecera:
read.table(text = productos2$codigo, sep = "-", fill = TRUE, header = FALSE,
           col.names = c("prefijo", "numero", "sufijo", "extra"))
prefijo numero sufijo extra
1 AB 123 X NA
2 CD 456 NA
3 EF 789 Z 1No dividas datos desiguales con do.call(rbind, strsplit(...)). Recicla los trozos sin dar error y el resultado parece correcto a primera vista. Fíjate también en que en la última salida read.table ha convertido "01" en el número 1. Con datos desiguales, separate_wider_delim() es la opción más segura, porque se detiene y te muestra el problema.
Convertir las nuevas columnas a números
separate_wider_delim() siempre devuelve columnas de tipo carácter. Mira la columna numero de los ejemplos anteriores: es <chr>, así que no puedes sumarla ni calcular su media. Tienes dos opciones. Convertir una columna con as.integer o as.numeric, o dejar que R adivine el tipo de todas las columnas con type.convert(), que es el equivalente al formato “General” de Excel:
productos |>
  separate_wider_delim(codigo, delim = "-", names = c("prefijo", "numero", "sufijo")) |>
  type.convert(as.is = TRUE)
# A tibble: 3 × 4
prefijo numero sufijo unidades
<chr> <int> <chr> <int>
1 AB 123 X 10
2 CD 456 Y 5
3 EF 789 Z 8as.is = TRUE mantiene el texto como carácter en lugar de convertirlo a factor. Ten en cuenta que type.convert() se aplica a todas las columnas, así que unidades también ha pasado de <dbl> a <int>. Si solo quieres convertir la nueva columna, usa mutate: mutate(numero = as.integer(numero)). La función separate(), ya reemplazada, hace la conversión con convert = TRUE, como has visto antes.
Mantén los códigos como texto. Convertir "007" a número da 7, igual que hace Excel cuando la columna tiene formato “General”. Los códigos de producto, códigos postales o identificadores con ceros a la izquierda deben quedarse como carácter. En read.table usa colClasses = "character".
Dividir por posición (ancho fijo)
La segunda opción del asistente de Excel, De ancho fijo, corta el texto en posiciones concretas. Se usa con identificadores en los que cada parte tiene siempre la misma longitud. Por ejemplo, en "ES2024001" los dos primeros caracteres son el país, los cuatro siguientes el año y los tres últimos un número.
En R base puedes extraer cada parte con substr, indicando la primera y la última posición:
ids <- data.frame(id = c("ES2024001", "FR2023117", "IT2024052"))

ids$pais <- substr(ids$id, 1, 2)
ids$anio <- substr(ids$id, 3, 6)
ids$numero <- substr(ids$id, 7, 9)
ids
id pais anio numero
1 ES2024001 ES 2024 001
2 FR2023117 FR 2023 117
3 IT2024052 IT 2024 052Con tidyr, separate_wider_position() recibe los anchos de los trozos en lugar de las posiciones, lo que resulta más fácil de leer. Los anchos sin nombre se descartan:
library(tidyr)

ids <- data.frame(id = c("ES2024001", "FR2023117", "IT2024052"))

ids |>
  separate_wider_position(id, widths = c(pais = 2, anio = 4, numero = 3))

# Sin el año
ids |>
  separate_wider_position(id, widths = c(pais = 2, 4, numero = 3))
# A tibble: 3 × 3
pais anio numero
<chr> <chr> <chr>
1 ES 2024 001
2 FR 2023 117
3 IT 2024 052
# A tibble: 3 × 2
pais numero
<chr> <chr>
1 ES 001
2 FR 117
3 IT 052Si un valor es más corto que la suma de los anchos obtendrás el error Expected 9 characters in each element of 'id', y puedes usar too_few = "align_start" como antes. Para leer un archivo completo con columnas de ancho fijo existe read.fwf(), pero recuerda que convierte los tipos, así que "001" se convertiría en 1.
Dividir con una expresión regular
A veces no hay ningún separador, como en "Manzanas 12kg", donde el número y la unidad van pegados. separate_wider_regex() describe cada trozo con una expresión regular. Los patrones con nombre se convierten en columnas y los que no tienen nombre se buscan y se descartan:
frutas <- data.frame(articulo = c("Manzanas 12kg", "Peras 7kg", "Naranjas 25kg"))

frutas |>
  separate_wider_regex(articulo, patterns = c(fruta = "[A-Za-z]+", " ",
                                              peso = "[0-9]+", unidad = "[a-z]+"))
# A tibble: 3 × 3
fruta peso unidad
<chr> <chr> <chr>
1 Manzanas 12 kg
2 Peras 7 kg
3 Naranjas 25 kgEl patrón tiene que encajar con la cadena completa. Ten en cuenta que [A-Za-z] no incluye letras con tilde ni la ñ: para un texto como "Limón" necesitarías "[[:alpha:]]+". En R base, strsplit también admite expresiones regulares como separador.
Eliminar los espacios sobrantes
El asistente de Excel deja los espacios que hay después del separador, y R también. Cuando los datos se han escrito a mano, los espacios alrededor del separador no son siempre los mismos:
df <- data.frame(nombre_completo = c("García,Juan", "López, Ana", "Martín ,  Luis"))

df |>
  separate_wider_delim(nombre_completo, delim = ",", names = c("apellido", "nombre"))
# A tibble: 3 × 2
apellido nombre
<chr> <chr>
1 "García" "Juan"
2 "López" " Ana"
3 "Martín " " Luis"El tibble muestra los valores entre comillas precisamente porque algunos tienen espacios al principio o al final. Un filtro como nombre == "Ana" no encontraría nada. Tienes dos soluciones. La primera es aplicar trimws a las nuevas columnas. La segunda es usar una expresión regular como separador, que acepte cualquier número de espacios alrededor de la coma. Para ello, envuelve el patrón en stringr::regex():
df |>
  separate_wider_delim(nombre_completo, delim = stringr::regex(" *, *"),
                       names = c("apellido", "nombre"))
# A tibble: 3 × 2
apellido nombre
<chr> <chr>
1 García Juan
2 López Ana
3 Martín LuisEn R base, read.table(..., strip.white = TRUE) hace lo mismo, o puedes aplicar trimws a todas las columnas con df2[] <- lapply(df2, trimws).
Dividir en filas en lugar de columnas
A veces una celda contiene una lista de valores, como los productos de un pedido: "rotulador, cuaderno". Dividirlos en columnas no tiene sentido, porque cada pedido tiene un número distinto de productos. Lo que necesitas es una fila por producto, y eso es lo que hace separate_longer_delim():
pedidos <- data.frame(pedido = c(101, 102, 103),
                      productos = c("rotulador, cuaderno", "rotulador",
                                    "grapadora, rotulador, pegamento"))

pedidos |>
  separate_longer_delim(productos, delim = ", ")
pedido productos
1 101 rotulador
2 101 cuaderno
3 102 rotulador
4 103 grapadora
5 103 rotulador
6 103 pegamentoLos valores de las demás columnas se repiten en cada fila nueva. En este formato largo puedes contar cuántas veces se ha pedido cada producto o cruzar los datos con otras tablas. También existe separate_longer_position() para dividir en filas por ancho. Si lo que necesitas es cambiar toda una tabla entre formato ancho y largo, consulta pivot_longer y pivot_wider.
Dividir una fecha en año, mes y día
Una fecha guardada como texto, como "2024-03-15", se puede dividir por "-" igual que cualquier otra cadena:
ventas <- data.frame(fecha = c("2024-03-15", "2024-11-02", "2025-01-28"),
                     importe = c(250, 120, 310))

ventas |>
  separate_wider_delim(fecha, delim = "-", names = c("anio", "mes", "dia"),
                       cols_remove = FALSE) |>
  type.convert(as.is = TRUE)
# A tibble: 3 × 5
anio mes dia fecha importe
<int> <int> <int> <chr> <int>
1 2024 3 15 2024-03-15 250
2 2024 11 2 2024-11-02 120
3 2025 1 28 2025-01-28 310Funciona porque el formato es fijo, pero es mejor convertir la columna a fecha con as.Date y extraer las partes con format. Así R comprueba además que las fechas son válidas, y podrás calcular diferencias entre fechas o agrupar por mes. Consulta cómo trabajar con fechas en R para conocer los códigos de formato.
f <- as.Date(ventas$fecha)

ventas$anio <- as.integer(format(f, "%Y"))
ventas$mes <- as.integer(format(f, "%m"))
ventas$dia <- as.integer(format(f, "%d"))
ventas
fecha importe anio mes dia
1 2024-03-15 250 2024 3 15
2 2024-11-02 120 2024 11 2
3 2025-01-28 310 2025 1 28La operación inversa: unir columnas como CONCATENAR
Para unir varias columnas en una, como con CONCATENAR, CONCAT o el operador & de Excel, usa paste en R base o unite() en tidyr:
personas <- data.frame(nombre = c("Juan", "Ana", "Luis"),
                       apellido = c("García", "López", "Martín"))

# R base
paste(personas$apellido, personas$nombre, sep = ", ")

# tidyr
personas |>
  unite(nombre_completo, apellido, nombre, sep = ", ")
[1] "García, Juan" "López, Ana" "Martín, Luis"
nombre_completo
1 García, Juan
2 López, Ana
3 Martín, Luisunite() elimina las columnas originales. Añade remove = FALSE para conservarlas. Las dos funciones se comportan de forma distinta con los valores faltantes: paste escribe el texto "NA", mientras que unite() puede omitirlos con na.rm = TRUE:
partes <- data.frame(a = c("AB", "CD"), b = c("123", NA), c = c("X", "Y"))

paste(partes$a, partes$b, partes$c, sep = "-")

partes |>
  unite(codigo, a, b, c, sep = "-", na.rm = TRUE)
[1] "AB-123-X" "CD-NA-Y"
codigo
1 AB-123-X
2 CD-Y¿Qué método deberías usar?
| Método | Divide por | Convierte tipos | Trozos desiguales | Ideal para |
|---|---|---|---|---|
separate_wider_delim()
|
Separador |
No (usa type.convert)
|
Error, o too_few / too_many
|
La mayoría de casos, dentro de una cadena de operaciones |
separate_wider_position()
|
Anchos | No |
Error, o too_few / too_many
|
Códigos de ancho fijo |
separate_wider_regex()
|
Expresión regular | No |
Error, o too_few
|
Texto sin un separador claro |
separate_longer_delim()
|
Separador | No | No es un problema (filas) | Listas de valores en una celda |
read.table(text = …)
|
Separador | Sí |
Error, o fill = TRUE
|
R base, conversión rápida |
strsplit() + do.call(rbind)
|
Separador o regex | No | Recicla sin dar error | R base, solo datos regulares |
substr()
|
Posiciones | No | Devuelve cadenas más cortas | R base, ancho fijo |
separate()
|
Regex o posiciones |
Con convert = TRUE
|
Aviso y NA
|
Código antiguo (reemplazada) |
En resumen: usa separate_wider_delim() por defecto, porque se detiene cuando los datos no son como esperas. Usa read.table(text = ...) si quieres R base y tipos automáticos, y separate_longer_delim() cuando cada celda contenga una lista de valores que deberían ser filas.